机器学习辅助高通量细胞表面抗原抗体发现
时间:2026-07-28 | 作者:多维游侠 | 阅读:0计算生物学和合成生物学正深度交融。抗体发现领域随之经历一场静默但深远的变革。
机器学习想要真正改变抗体筛选的游戏规则,离不开结构清晰、质量过硬的训练数据。这里先明确一个判断:光有算法远远不够。能够匹配算法需求的实验体系,才是关键中的关键。
一项最新研究精准地抓住了这个痛点。研究者构建了一种合成Fab酵母展示文库。其设计思路从一开始就瞄准了与机器学习流程的无缝对接。
核心思路是把序列多样性高度集中在重链的互补决定区——CDRH3环上。这个环在天然免疫系统中就是抗原识别的主要火力点。
他们从人类B细胞抗体库中汲取关键序列特征,将其压缩进一个紧凑的“抗原识别模块”(ARM)中。以VH1-69重链和四种轻链为基础,这个文库一口气对PD-L1、TIGIT、ROBO1等十种细胞表面抗原进行了实战检验。
结果相当漂亮。不仅拿下了数百个生物物理性质优异的抗体,还通过流式、免疫组化等实验进行了验证。更重要的是,研究者直接从海量的测序数据中,用机器学习模型挖出了针对ROBO2和PD-L2的新抗体。整个公开数据集,本质上就是在搭建一个适用于机器学习的高通量抗体发现框架。
抗体展示技术的价值与挑战
抗体展示技术对于寻找高质量抗体的价值,业内早就有共识。在某些场景下,它获得的候选分子甚至能与传统免疫方法得到的单抗一较高下。无论是酵母还是噬菌体展示,核心优势在于能对大量候选分子进行“饱和式”筛选。
纯合成展示文库的最大亮点,在于流程的可控性、稳定性和可重复性。这对于构建“计算-实验”闭环体系来说,几乎是必备的前提。传统免疫法在面对神经系统或发育过程中的高度保守抗原时常常力不从心,而合成文库却能轻松绕过这一障碍。
不过,目前很多用于治疗性抗体开发的先进文库,结构还是偏复杂。它们往往依赖患者或动物来源的多种CDR组合,再叠加多种筛选技术。虽然抗体空间被撑大了,但数据结构的复杂度也急剧上升。这恰恰给大型机器学习模型的训练数据集构建,设置了不小的障碍。
研究设计的核心:抗原识别模块(ARM)
回到天然免疫识别本身,重链CDRH3环在决定抗原特异性方面扮演着举足轻重的角色,是整个互补位的核心区域。一个很自然的想法就此诞生:如果把互补位的主要序列空间从六个CDR压缩到仅仅一个CDRH3,那么抗原-抗体相互作用的语言会不会变得简洁、有序,从而更适合计算建模?
这种思路并不新鲜,此前就有合成文库尝试过。但它们多用固定的随机氨基酸频率,结果引入了一系列在天然体系中本该被B细胞选择过程清除的不良基序,比如多反应性、容易聚集或降解的氨基酸。
这就是这项研究设计的出发点。他们构建的合成Fab酵母展示文库,巧妙之处在于:在CDRH3区域引入的是来自初始B细胞抗体库的位置特异性氨基酸频率,同时清除了那些“坏分子”基序。每个CDRH3序列后面还附上了一个核苷酸层面的条形码,用来追踪是哪个轻链配上了它。这个完整的“CDRH3+轻链条形码”结构,就是所谓的ARM。
因为ARM本质上是一段超短核苷酸序列,天然适合深度测序,可以作为抗体互补位的一种紧凑表示。研究者用这套系统去筛选十个有生物学和治疗价值的细胞表面抗原,结合大规模测序和机器学习,去挖掘那些低频但潜力巨大的Fab克隆。
方法
具体怎么做的?
- 先从人类初始B细胞抗体库里“临摹”出CDRH3的序列空间,然后剔除掉那些可能惹麻烦的基序。
- 接着以VH1-69重链作为固定支架,搭配四种轻链,把带着紧凑ARM的合成Fab酵母展示文库装起来。
- 之后,针对十种细胞表面糖蛋白抗原,通过磁珠分选加多轮流式分选进行轮番“拷问”。
- 每一轮筛选后,都对ARM区域深度测序,实时跟踪候选Fab克隆的富集情况。
- 最后根据CDRH3序列聚类,选出代表性克隆,表达成IgG1或兔嵌合抗体,再用一套完整的分析手段去验证。
验证手段包括:尺寸排阻色谱看聚集,多特异性反应查非特异,表面等离子体共振测动力学,流式和免疫组化看应用潜力。更关键的是,对于那些在实验筛选中被“埋没”的克隆,他们用基于k-mer特征的逻辑回归模型,从早期分选数据里重新识别出来。
结果
ARM的设计与序列分析
为了搭建一个既适合高通量筛选又适合机器学习分析的平台,团队的核心发明就是这个ARM。它覆盖了CDRH3及其邻近框架区,再加上一个轻链条形码。因为序列短,深度测序的效率极高,天然就是抗体识别特征的理想编码形式。
他们为11到17个残基长度的CDRH3设计了不同的寡核苷酸池。每个位置的氨基酸频率都来自Observed Antibody Space数据库的初始B细胞序列。为了确保多样性不被扭曲,还特意调整了不同长度的比例。同时,主动排除了半胱氨酸、甲硫氨酸以及其他可能带来不良性质的基序。
展示支架选择了VH1-69。这是一个在治疗性抗体和广谱中和抗体中很常见的重链胚系。四种轻链的选择也很有讲究:VK1-39、VK3-15和VK3-20形成相对平坦的互补位表面,而VK4-1因为CDRL1环较长,能形成更凹陷的表面,可能识别不同类型的表位,比如肽类表位。
深度测序的结果证实,两个VH1-69子文库检测到了海量独特的CDRH3序列。各子文库之间重叠度很低,各自贡献着丰富的多样性。总体上,这个ARM文库的氨基酸频率很好地再现了天然初始B细胞库的特征,同时有效去除了不良基序。
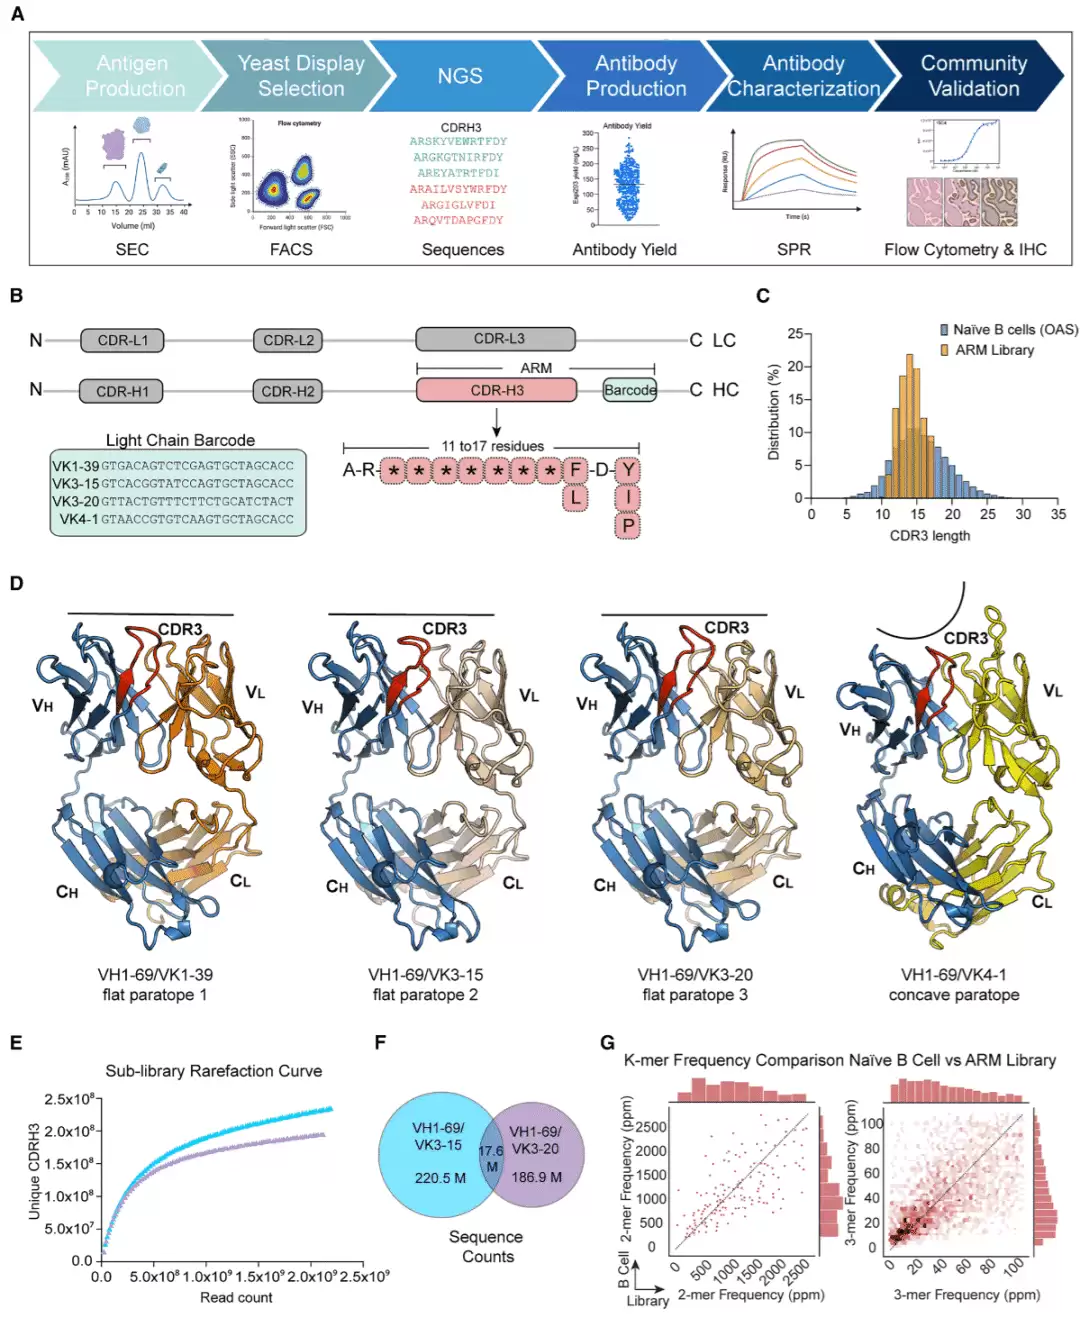
图1:用于 Fab 酵母展示的 ARM 文库构建。
高通量抗体发现流程产出丰富
为了检验这个最小化Fab文库的真实战斗力,团队一口气对十个靶点并行发起了挑战:PD-L1、PD-L2、TIGIT、LOX1、DKK1、IL-23R、DCC、ROBO1、ROBO2和syncytin-2。这些抗原在大小、序列相似性和结构类型上天差地别,足以检验文库的“成色”。
筛选流程是一轮磁珠分选加三轮流式分选,全程逐步降低抗原浓度,向强结合群体施压。每一轮筛选后,都对ARM区域深度测序,动态追踪每个CDRH3克隆的命运。
根据最终轮次的频繁ARM序列,对CDRH3进行聚类,并订购了代表性重链。因为插入片段短,成本优势很明显。最终订购了429条重链,获得了424个产量合格的抗体。质量控制结果显示:301个抗体无聚集或降解问题,354个无多特异性反应,共有285个抗体双通过。
后续的动力学和细胞结合实验进一步筛选出一批性能优异的候选分子。部分针对TIGIT和LOX1的抗体表现甚至与商业抗体相当。ROBO1/2和syncytin-2的优选抗体,热稳定性也高得令人印象深刻。
一个特别亮眼的例子是ROBO1和ROBO2。这两个轴突导向受体,目前高质量的商品化IHC抗体非常稀缺。虽然筛选的是人源抗原,但部分抗体对小鼠同源蛋白也表现出强交叉反应。经过抗体工程改造后,在小鼠胚胎组织切片上,这些抗体产生的免疫染色模式与已验证的商业抗体高度一致。这证明这个文库不仅能筛选出“结合”抗体,更能产出经得起实际生物学实验检验的高质量试剂。
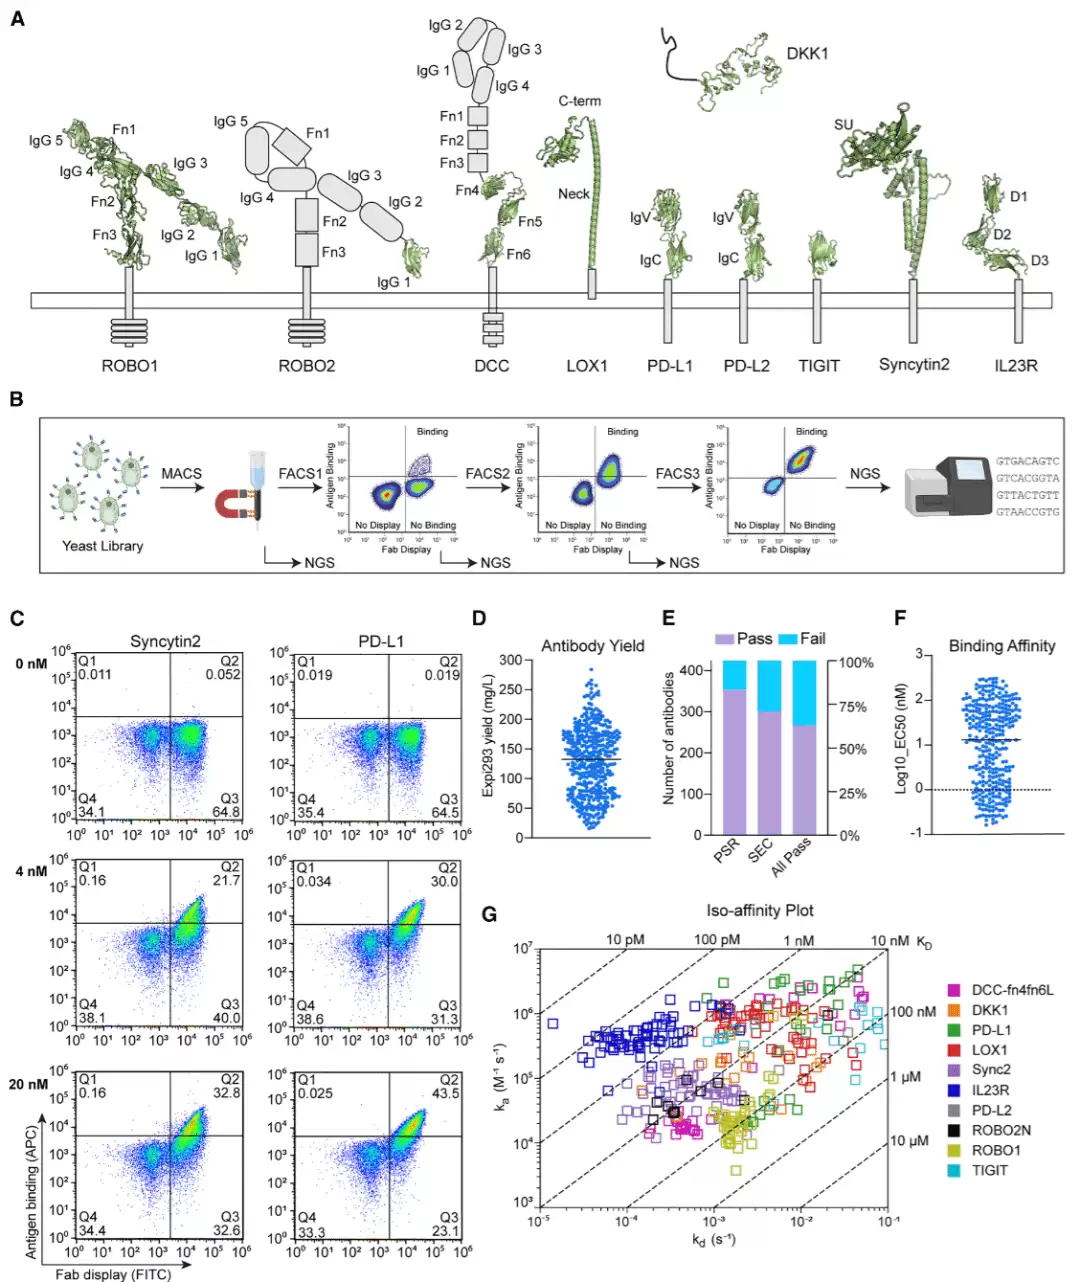
图2:针对十种细胞表面糖蛋白的抗体发现活动。
深度测序揭示文库的稳健性与特异性
深度测序的数据清晰地展示了抗原驱动的富集模式。比如,针对IL-23R的一个富集聚类,CDRH3环的基部序列高度一致,而环顶部则保留变异。这说明文库能在同一骨架下产生功能相似的多种结合模式。
对于高度同源的ROBO1和ROBO2N,独立筛选得到的ARM序列聚类几乎相同。这说明文库在识别保守表位时,会自然收敛到相似的解决方案。与此同时,不同抗原筛选又展现出高度特异性。随着筛选轮次推进,聚类数量逐步减少,而每个聚类内部的序列数量在增加。这说明筛选过程并非随机放大,而是真正的抗原驱动选择。
跨抗原的序列相似性分析也印证了这一点。PD-L1和PD-L2虽然结构相似,但外结构域序列相似性有限,最终筛选出的CDRH3序列几乎没有重叠。而ROBO1和ROBO2N则因共享保守表位,筛选结果呈现明显相关性。整个结果显示,ARM文库能根据抗原表面特征,产生可重复、稳健且具有抗原驱动性的序列富集。
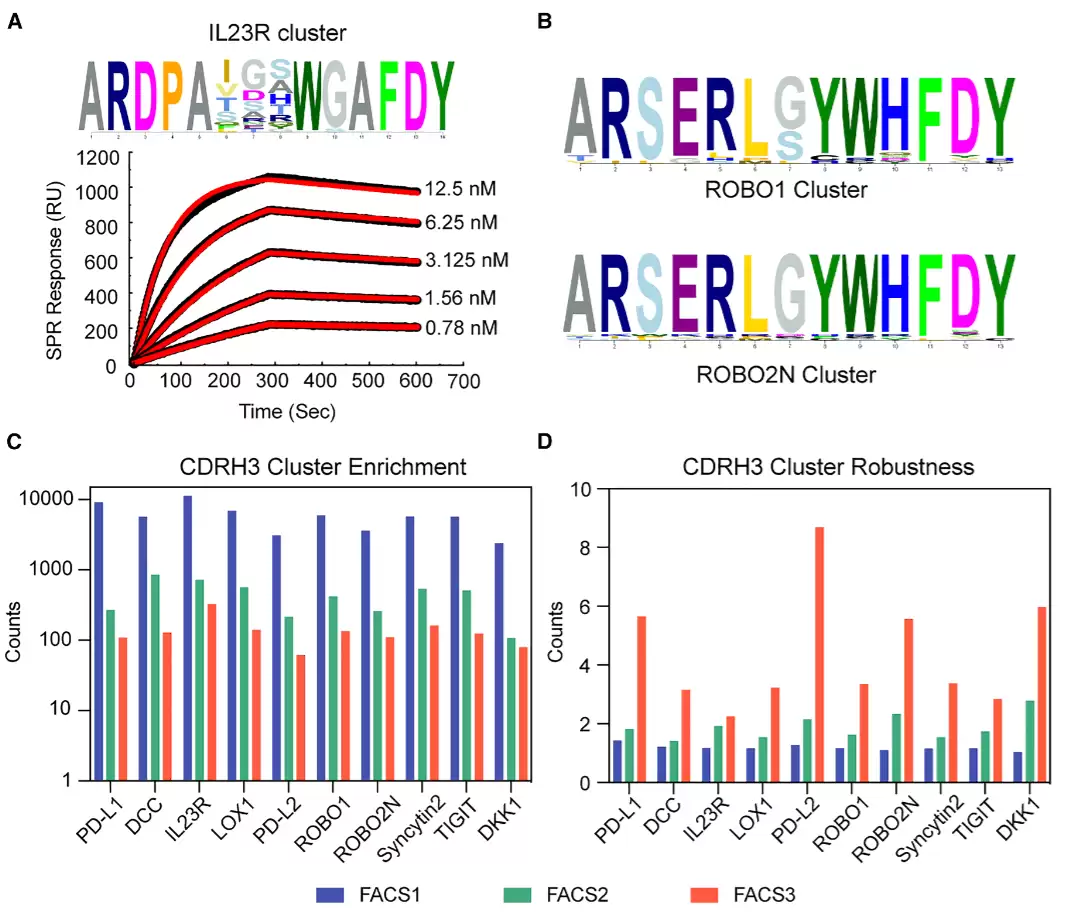
图3:抗原驱动的序列富集显示稳健且独特的 CDRH3 序列模式。

图4:使用归一化汉明距离评估不同抗体筛选活动之间的序列多样性。
机器学习的介入:弥补实验筛选的“盲区”
实验筛选虽然高效,但并非十全十美。有些克隆可能因为展示效率、生长速率甚至筛选动力学上的细微差异,在后续轮次中被低估或丢失。在ROBO2N的筛选中,团队就发现最终轮次被一个优势克隆主导,而早期轮次里还藏着丰富的ARM多样性。正是针对这一痛点,机器学习开始大显身手。
他们针对ROBO2N的数据训练了一个逻辑回归模型,用ARM序列中的k-mer频率做特征。模型的训练目标是区分相对于磁珠分选,在第一轮流式分选中是否出现富集。经过充分训练和评估后,他们用模型对第一轮流式分选中具有足够计数的1909个ROBO2N ARM进行评分,从中选出了29个模型评分很高、但在后续实验中被“埋没”的ARM序列。为了保证这些候选与已发现的抗体不同,还特意要求它们保持足够的序列编辑距离。
将这些机器学习选出来的ARM重新表达为抗体后,通过表面等离子体共振和细胞展示检测,结果令人振奋:排名靠前的机器学习抗体,大部分结合动力学表现优异,甚至优于实验筛选中占优势的短CDRH3克隆。多个抗体成功结合ROBO2,且对ROBO1有交叉反应,对PD-L1等阴性对照则无反应。
更进一步,通过表位分箱分析,机器学习的两个抗体还能同时结合ROBO2N。这说明它们识别了不同的表位,成功拓展了实验筛选获得的表位空间。他们还尝试将基于ROBO2N训练的模型,直接用于预测ROBO1上哪些抗体更可能结合。模型给出的高分,精准指向了那些识别共享N端表位的抗体。
这个结果相当漂亮:机器学习不仅能抢救被实验流程忽略的克隆,还能在同源抗原之间,预测出共有的结合模式。
同样的策略也被应用到PD-L2的筛选中。原始实验只得到了少数良好抗体。通过逻辑回归模型从早期数据中重新选择,他们发现的候选抗体,在细胞结合效力上毫不逊色。ROBO2N和PD-L2的例子共同证明,深度测序产生的ARM数据集里,隐藏着大量未被传统分选流程充分利用的信息。
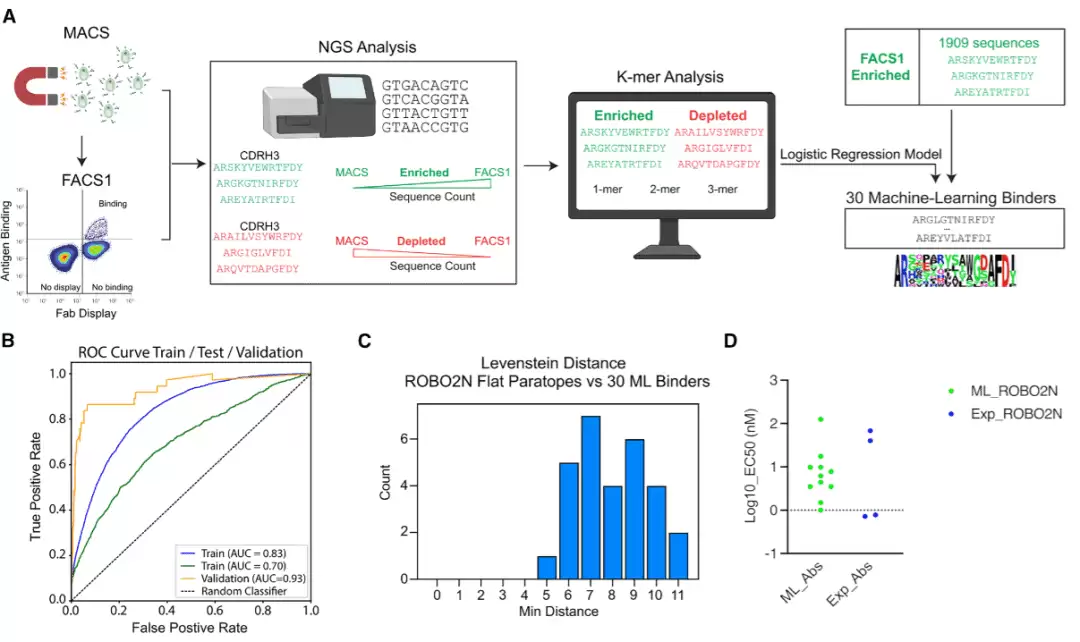
图5:逻辑回归模型从早期分选群体中抢救被动力学细胞分选丢失的 ROBO2N 结合抗体。

图6:利用逻辑回归模型进行交叉反应抗体的表位分箱与评分。
讨论
必须承认,机器学习在蛋白质结构预测方面已经取得了惊人进展。但在抗体-抗原相互作用的从头预测上,依然面临挑战。尤其是在缺少高质量结构数据和大规模互作数据的情况下。
合成抗体文库为机器学习生成系统化数据集提供了绝佳的路径。但以往文库的序列空间过于复杂,反而成了阻碍。ARM文库通过将主要多样性集中在CDRH3,大幅压缩了互补位序列空间,使其变得可跟踪、可学习。
从十个不同抗原的测试结果来看,这种设计无疑是成功的。文库既保证了筛选的稳健性,又能产生抗原特异性识别模式。同时也必须指出的是,细胞分选有其局限性。最终富集的克隆不一定总是最优的。而ROBO2N和PD-L2的结果,恰好证明了“计算-实验”混合策略的价值:早期分选轮次保留的大量信息,可以通过机器学习重新激活,让那些低频但有潜力的抗体也能进入后续验证。这种策略,有效缓解了实验中克隆丢失和富集偏倚的问题。
表位分箱实验的一个有趣发现是,ROBO1和ROBO2N上存在抗体识别的“热点”区域,多数抗体集中于此。这可能反映了抗原本身存在优势结合表面,但也可能与文库设计有关。由于只主要改变CDRH3,固定了CDR1和CDR2,一定程度上限制了依赖其他CDR多样性的互补位类型。这也提示我们,未来要覆盖更广泛的表位空间,或许需要引入更多支架或适度扩展其他CDR区域的多样性,同时保持一个可学习的紧凑体系。
这项研究一个最值得称道的贡献,是公开了大规模下一代测序数据和数百个抗体的实验表征结果。这些数据不仅服务于当前的筛选,更为未来的计算模型——无论是表位分箱、亲和力成熟、抗体排序还是零样本发现——提供了宝贵的训练语料。随着更多抗原、支架和实验标签的加入,类似ARM的紧凑抗体表示,完全有潜力成为机器学习驱动抗体发现的核心数据接口。
总的来说,研究者们构建并验证了一套可扩展的高通量抗体发现框架。成功地将合成Fab展示、深度测序、生物物理表征和机器学习筛选融为一体。它既能针对多种细胞表面抗原快速产出玻尿酸抗体,又能借助机器学习的力量,从实验筛选的“盲区”中发现惊喜。这项工作不仅为抗体发现提供了一个“实验-计算”闭环的生动范例,也为面向大规模抗体设计模型的数据集建设,铺设了一块坚实的基石。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Ollama基本概念与入门使用介绍
- 时间:2026-08-21
-
- 人工智能与机器学习技术全景:从理论到实践应用
- 时间:2026-08-18
-
- 阿里云倚天710云服务器详解:CIPU架构性能与应用场景
- 时间:2026-08-17
-
- C语言如何计算离散分布的期望值公式与实现
- 时间:2026-08-15
-
- 机器学习中非法字符串导致float转换错误的处理方法
- 时间:2026-08-15
-
- Anaconda3 2026安装教程 新手快速完成环境配置
- 时间:2026-08-13
-
- ICML 2026 美团技术团队机器学习前沿论文精选
- 时间:2026-07-28
-
- 机器学习发展史:从神经元到大语言模型
- 时间:2026-07-23
精选合集
更多大家都在玩
大家都在看
更多-

- 以下哪种食材被称为“地下苹果” 蚂蚁庄园今日答案9.18
- 时间:2026-09-17
-
- 蚂蚁庄园今天答题答案2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园答题今日答案2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园小课堂2026年9月18日最新题目答案
- 时间:2026-09-17
-
- 小鸡答题今天的答案是什么2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园每日答题答案2026年9月18日
- 时间:2026-09-17
-
- 蔬菜洗完掉色,说明是被染色了,是真的吗 蚂蚁庄园今日答案9月18日
- 时间:2026-09-17
-
- 满襟蜡绘花纹巧染就花纹当绣裳说的是哪种传统技艺 蚂蚁新村今日答案2026.9.17
- 时间:2026-09-17