黄仁勋:Prompt正在过时,Loop成新范式
时间:2026-07-28 | 作者:白桃企划师 | 阅读:0Prompt已死,loop当立
最近行业里有个提法挺有意思——老黄黄仁勋给AI画了个新重点:
Nobody writes prompts anymore. The new job is to write and handle loops.(现在根本没有人写Prompt了,新时代的核心工作是编写和管理loop。)

这个词直译是“循环”。换成AI圈的说法就是:你不再亲手给AI下指令。
而是设计一个系统,让系统替你下指令、替你验收。
不合格自己重来,直到活干完。
嗯?这不就是Agent那一套吗?为啥又搞出个新概念?
先别急着下结论。环顾一圈后发现,这个“loop”还真挺火。
除了老黄,“龙虾之父”Peter、“Claude Code之父”Boris Cherny、吴恩达等一众大佬全都在谈、在大力推。
(Peter)别再给编程Agent写提示词了,去设计循环,让循环替你提示Agent。

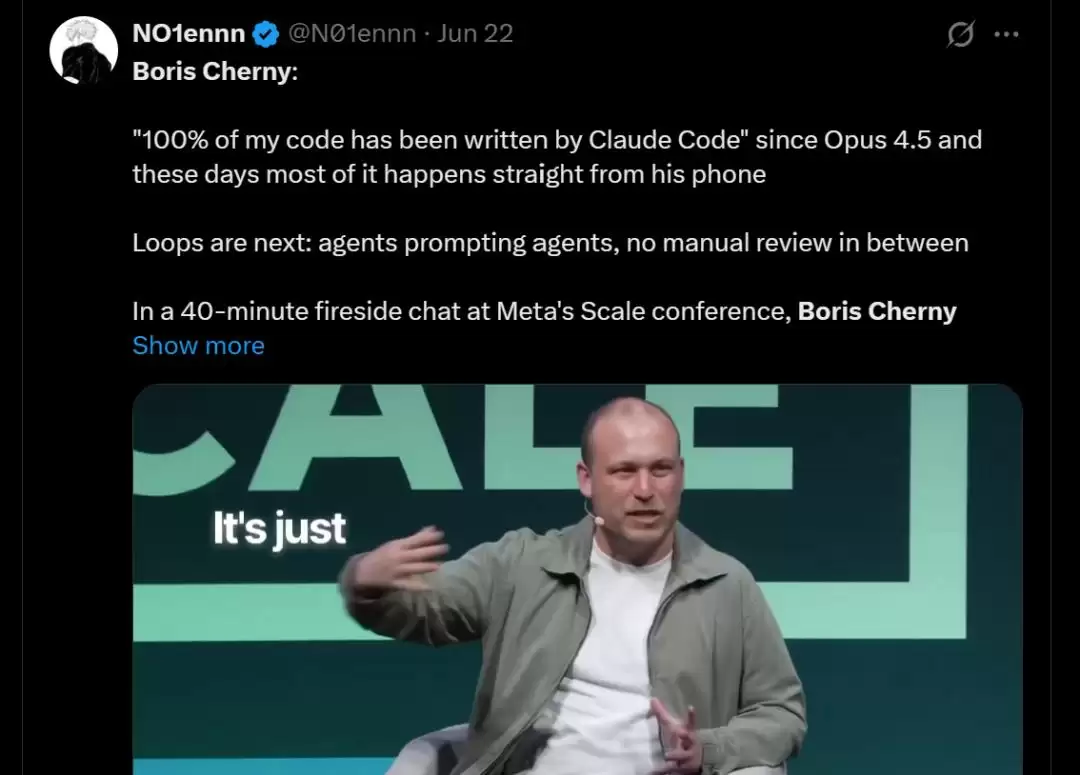
(Boris)我已经不给Claude写提示词了。我有一堆循环在跑,是它们在给Claude下指令、决定下一步做什么。我的工作,就是写循环。
当“写loop”取代“写prompt”成为大佬们新的日常,这个概念显然已经越过了“又一个新概念”的阶段。
剩下的问题只有:loop具体指什么?它怎么就火了?
loop到底是什么
从旧范式说起
要理解这个新东西,得先回顾一下旧范式。
过去两年AI编程的标准动作是这样的:你写一条prompt,AI吐一段代码。
你看了不满意,再写一条,AI再改,你再看……反正来回拉锯,人全程盯着。
卡帕西之前还侧面吐槽过“人就是瓶颈”这件事,劝大家:
你不能坐在那里等着给每一步写prompt,你得把自己从流程中抽离出来。
loop的核心逻辑
把人从流程中抽离出来,这正是loop要解决的事。
核心逻辑就一句话:你定义一个目标,AI自己跑。
跑完自己验收,不合格带着报错再来一轮,直到通过或者撞上预算上限才停。
此时人的角色就从“传话人”变成了“规则设计者”。
loop与Agent的区别
回到开头的疑问:这跟Agent有什么区别?
显而易见,Agent是干活的那个人。
而loop是让这个人不用你盯着也能持续干活的那套管理机制。
没有loop的Agent,你提一句它动一下。本质上还是个听话的工具。
套上loop的Agent,才真正变成了一个能自转的系统。

原理听起来不复杂,但好像还有点抽象。别急,我又去翻了下当前loop的实际落地情况。
结果发现它其实已经藏在了我们熟悉的系统里。
围绕loop,产品落地层目前已经形成了“双雄对峙”格局。
双雄之一:Claude Code
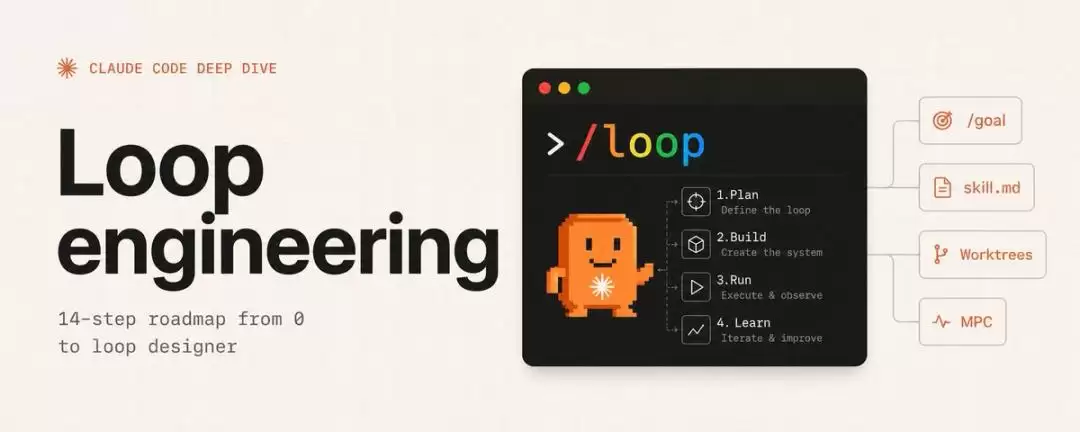
一个就是大家天天都在用的Claude Code。它围绕loop做了三件套:
/loop:负责定时循环/goal:负责目标驱动(跑到验收条件满足为止)/schedule:负责云端定时任务(合上电脑也能跑)
其中最精妙的设计是/goal。它背后藏着loop最关键的一条原则——自己不能判自己的卷子。
Claude Code把这条原则直接写进了产品架构:写代码的是大模型,验收的是另一个独立的小模型Haiku。两个模型各司其职。
这样一来,Agent不会自己给自己打高分,验收才有真实的约束力。
双雄之二:OpenAI Codex
另一个就是OpenAI Codex。Codex的玩法更接近“自动化流水线+目标驱动+多个子Agent”的组合。
在一些开发者的实际体验中,能看到最多8个Agent同时跑在各自的云端沙箱里,各干各的活,最后把结果汇总回来。
有意思的是,两家的实现路径不同,但最终长出来的形态高度相似。
都是把复杂任务拆碎,分给多个Agent并行去跑,再统一汇总。
在公开评测和社区口碑里,两者的表现也已经非常接近。
这也说明一个问题,模型本身已经卷不出太大差别了,真正的差距在上层的loop编排。
大佬的日常:Boris Cherny的工作方式
说到这儿,直接看看“Claude Code之父”Boris Cherny每天怎么工作的就全明白了。
他自述去年11月卸载了IDE,一个月没打开过,索性删了。
现在他手下几百个小Agent同时跑:
- 有的扫GitHub issue
- 有的读Slack上的用户反馈
- 有的监控CI失败
每个Agent在自己隔离的代码分支里干活。一个写代码,另一个跑测试验收。
搞不定的才进他的收件箱,等他来做判断。
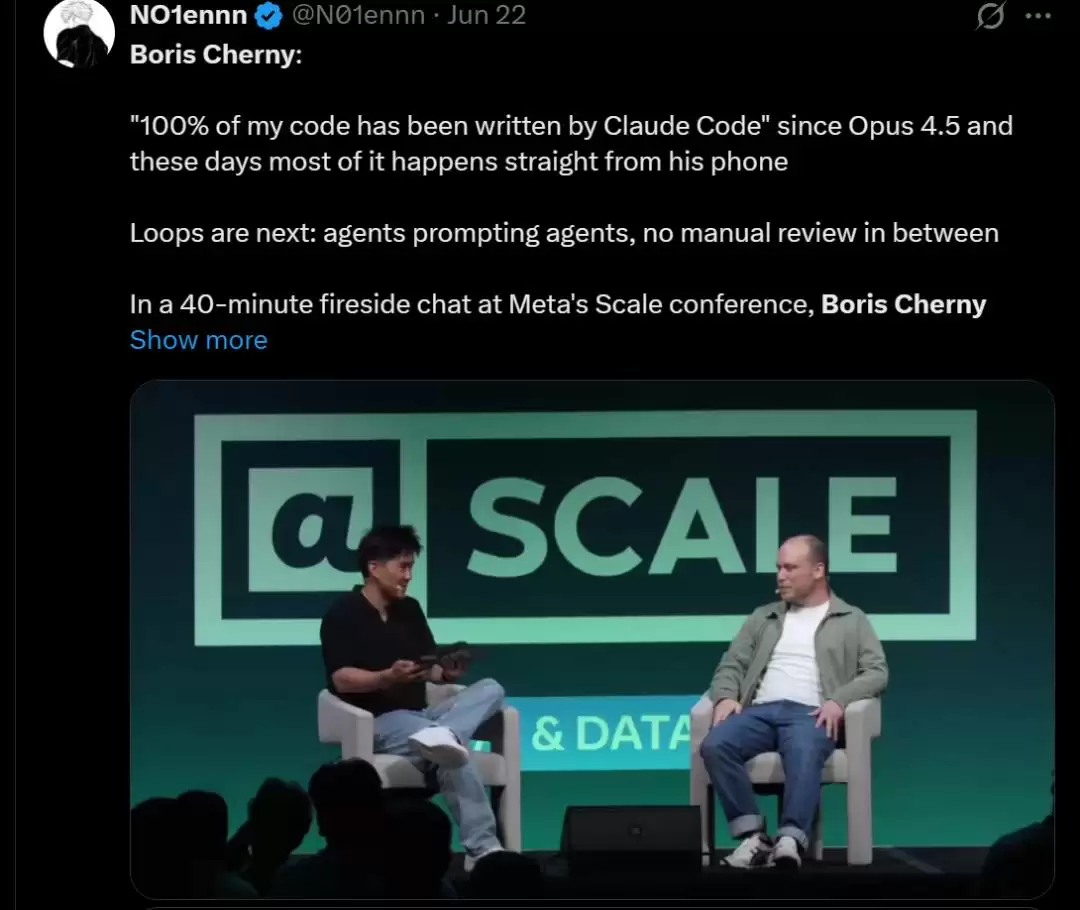
据他透露,自Opus 4.5以来,其所有代码都是Claude Code写的。
如今大部分代码都是直接在他的手机上完成。
接下来是循环,Agent之间互相提示,中间无需人工审核。
看到没,loop的终极形态已经很清晰了:人不写代码,也不写prompt,只写规则和判断,剩下的全交给loop。
怎么loop起来
那么,我们该怎么loop起来呢?
X上有个叫Codez的博主已经都替大家总结好了。他发了一份14步实操roadmap,这里挑了一些干货。

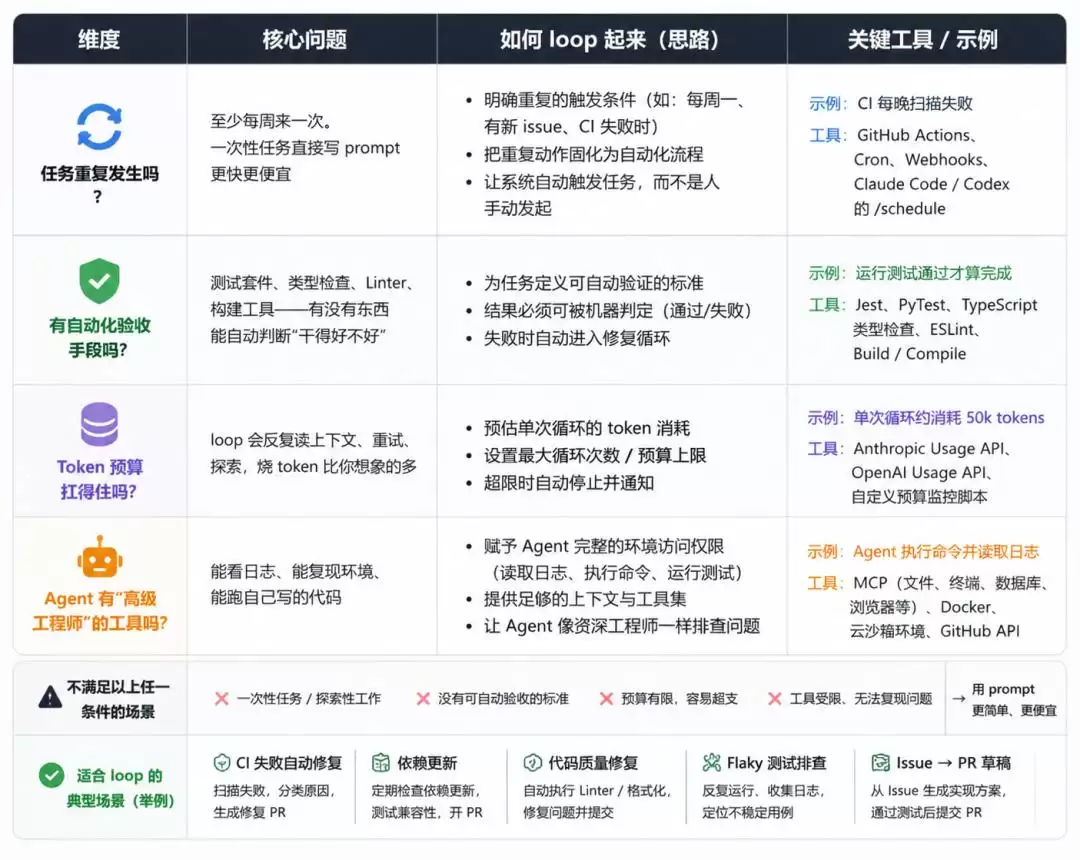
step 1:先别急着建,先做“4条件测试”
loop不是什么活儿都能往里面塞,瞎建只会亏钱。
在动手之前,先回答四个问题:
- 任务重复发生吗?
- 有自动化验收手段吗?
- Token预算扛得住吗?
- Agent有“高级工程师”的工具吗?
四个全过,才值得建loop。
step 2:从最小可行loop开始
第一次别搞花活,就建一个四件套:
- 一个触发器:Automation(定时跑、事件触发跑都行。Claude Code里用
/loop,Codex里用Automations面板) - 一个技能:Skill(把项目上下文写进STATE.md,让每次运行不用重新解释一遍)
- 一个状态文件:State File(用Markdown记下“做到哪了、什么成了、什么挂了”,下次接着跑)
- 一个门禁:Gate(测试、类型检查、构建——能自动拦住坏结果的东西)
而且顺序很关键:先手动跑通一次→写成Skill→包进loop→最后才上定时。
跳步是loop死在生产环境的主要原因。
step 3:做“拆卷子”的人,别做“判卷子”的
整个loop设计里最重要的一条原则前面已经提过了——写代码的和验代码的,必须分开。
落地到具体操作就是:用一个模型(或者子Agent)负责写,用另一个独立的模型(或者子Agent)负责验收。
验收的那个不能看到写代码的那个的推理过程。
为什么这很重要?因为模型给自己写的代码打分时,往往“手太松了”。
所有“看起来不错”的代码,在独立验收器面前大概率能挑出一堆毛病。

step 4:别人踩过的坑就别再踩了
附几个避坑指南。
1、没有硬停止条件。loop跑到你发现账单或者被限流才停。所以需要设Token上限、迭代次数上限、时间限制。
2、状态不落地。Agent的记忆是短时的,今天学到的东西明天就忘了。所以需要写进状态文件(STATE.md),每次运行接着读。
3、让loop碰“需要判断”的活。架构重写、鉴权代码、支付逻辑、产品方向决策,这些别让loop碰。
loop适合干“对错清晰、机器可验证、不依赖人的判断”的活,比如:
- Lint自动修复
- 依赖更新PR
- CI失败分类
- Flaky测试复现
4、不读Diff。loop合入代码越来越快,你对代码库的理解越来越浅。这叫“理解力债务”。
真正的代价不是Token账单,而是某天你要调试一个团队里没人读过的系统。
所以建议你读Diff,哪怕只是扫一眼。
step 5:衡量指标就一个
别管烧了多少Token、开了多少PR、跑了多少次任务。
唯一有用的指标是:每个被接受的改动,平均成本是多少。
如果你的“被接受率”低于50%,说明你在做loop本该替你省掉的评审工作,即loop在亏钱。
从提示词到loop,四次范式跃迁
原理和方法搞懂了,最后的问题只有一个:loop为什么现在火了?
虽然严格来说,loop Engineering这个概念只有不到三周的历史。
但它不是凭空蹦出来的。往回拉一下时间线,就能看到一条很清晰的演化路径。
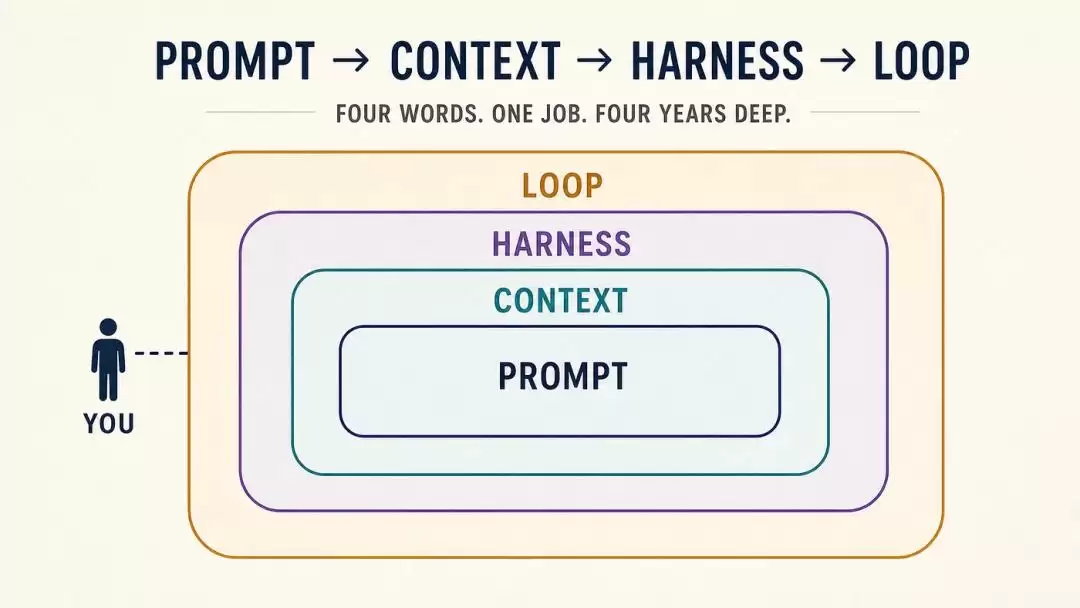
这条路径大佬们已经替大家总结好了:从Prompt→Context→Harness→loop,一共四次。
第一阶段:Prompt Engineering(2023~2024年)
这是Prompt Engineering的天下。
当时大家都在琢磨一件事:提示词怎么写才能让AI好好干活。
写得好和写得不好,出来的东西天差地别。
所以那会儿“会不会写prompt”基本就等于“会不会用AI”。
这一阶段,人和AI的关系还停在最表面那层——你说一句,它回一句,细到每一个指令都要人亲自敲。
第二阶段:Context Engineering(2024~2025年)
随着模型能力增强、上下文窗口变长,以及RAG和代码库接入逐渐普及,问题开始发生第一次迁移。
大约在2024到2025年前后,行业开始强调“Context Engineering”的重要性。
关注点从“怎么问”变成了“给AI看什么”。
AI不再只依赖一句提示词,而依赖你提供的整个背景。
这一阶段,信息组织能力开始比写prompt更重要。控制粒度从“一句话”上移到了“一堆信息”。
第三阶段:Harness Engineering(2025~2026年)
到了2025~2026年,随着Agent系统逐步进入真实开发流程,问题继续往外扩展。
这时人们发现,光给信息和上下文也不够了。
AI得能接工具、能跑代码、能调接口、能走权限审批。
因此,你得给它搭一个能干活、能约束、能调取真实世界资源的运行环境。
“Harness Engineering”正是为此而生。
第四阶段:loop Engineering(现在)
在Harness的基础上,“loop Engineering”成了最新的进化方向。
如果说Harness解决的是“AI能不能在真实环境里干活”的问题。
那loop解决的就是“AI能不能在这个环境里持续干活、自己推进任务、不需要人一步步盯着”的问题。
它的核心不再是单次执行能力,而是一个闭环系统的运行能力。
所以从Prompt到Context,再到Harness,再到loop。
看起来像是概念的更替,但本质上是一条连续的迁移路径:
人类对AI的控制粒度不断上移,从“写一句话”,变成“提供信息”,再变成“搭建系统”,最终变成“设计循环”。
一个逐渐解放人类双手的过程。
学术界的先声:ReAct框架
实际上,虽然loop这玩意儿刚在工业界火起来,但学术界其实早就有了类似理念。
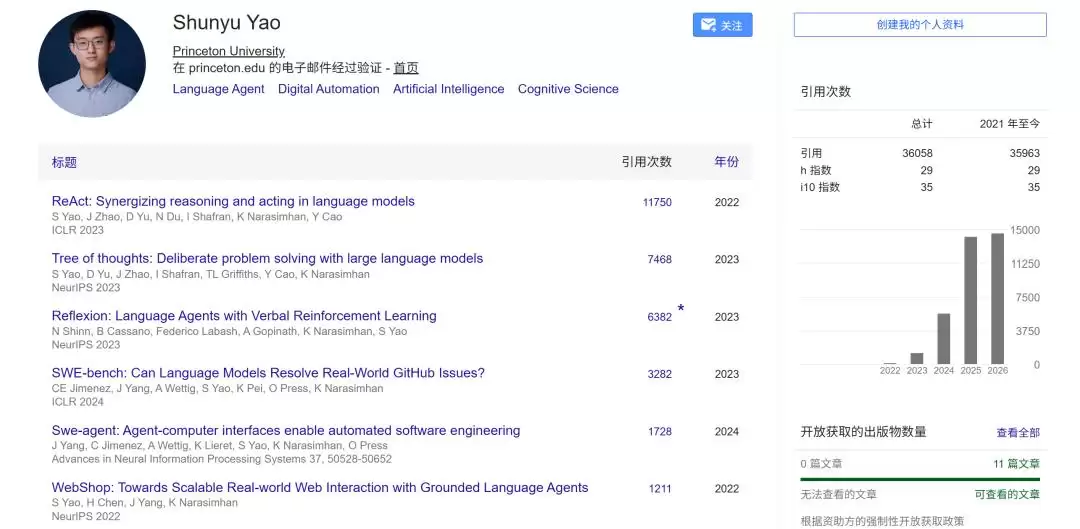
很多重要工作都和我们今天熟悉的一个人有关:姚顺雨(腾讯那个)。
他在大模型Agent方向最具代表性的工作之一,是2022年的ReAct框架(Reason+Act)。
这篇工作在ICLR 2023拿到Oral级别,也在后续获得了上万引用量。
ReAct做了一件很关键的事:把“推理”和“行动”绑定成一个循环过程。
大模型不再是一次性输出答案,而是先进行可解释的思考,再调用工具执行动作。
执行之后再观察环境反馈,然后进入下一轮推理。
抽象出来就是:思考→行动→观察→再思考→再行动……
这个结构本质上就是一个最早被系统化表达的“agent loop”雏形。
在ReAct之后,这条路线被不断扩展。
比如Reflexion引入“从错误中学习”的反馈机制,Tree of Thoughts扩展成多路径搜索式推理。
以及后续一系列tool-use agent工作逐步完善“规划+执行+反馈”的完整链路。
这些学术成果一点一点往前拱,最终才在工程界收敛成今天所说的“loop系统”。
所以从学术视角看,loop不是某一个人的发明,它是一条逐步收敛的技术路径。
只不过在这条路上,恰好有个我们熟悉的华人站在了一个关键节点上。
热潮中的清醒声音
最后不得不感慨,从Prompt到loop,AI的发展还是太快了。
太快带来的后果是,有人兴奋激动,也有人难掩担忧。
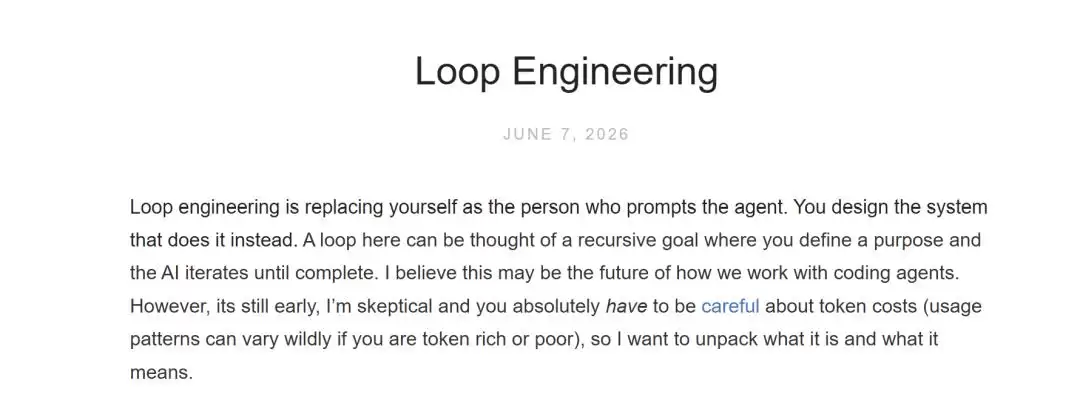
而loop Engineering的命名者、Google工程主管Addy Osmani,正是后者当中的一员。
他在《loop Engineering》这篇长文里写得很明白:
还很早期。我持保留态度。token成本你必须非常小心。
卡帕西的话更让人深思。他在红杉资本AI Ascent 2026大会上引用过一句让他本人反复回想的话:
你可以外包你的思考,但你没法外包你的理解。
翻译过来就是:AI可以替你想办法,但你自己得真懂问题本身。
这大概是整场loop热潮里最清醒的声音。
参考链接:
[1]https://x.com/i/trending/2068190968809980300
[2]https://x.com/addyosmani/status/2064127981161959567

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- AI学习笔记:Loop Engineering与Graph Engineering解析
- 时间:2026-08-21
-

- MATLAB中LoopTransferC脉冲响应绘制方法
- 时间:2026-08-17
-

- Loop Engineering 入门指南:高效摆脱逐句指挥 AI
- 时间:2026-08-13
-

- Loop Engineering循环工程:正在发生的范式转变解析
- 时间:2026-08-12
-

- Loop未稳GraphAI又来袭技术迭代太快学不完
- 时间:2026-07-29
-

- Loop Engineering的出现原因与组成部分
- 时间:2026-07-28
-

- 从循环到图工程:让Agent系统长期可靠运行
- 时间:2026-07-27
-

- AI智能体循环工程:自主干活监工与返工
- 时间:2026-07-25
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15