算苗科技国产3D TokenPU成功流片 带宽16TB/s
时间:2026-08-10 | 作者:清风无痕 | 阅读:0算苗科技国产3D TokenPU芯片完成流片
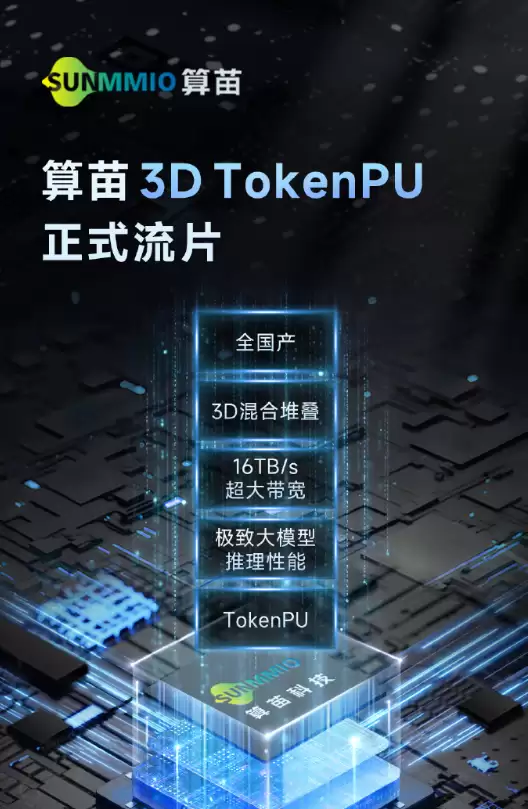
6月16日,算苗科技对外宣布重磅消息。其全国产自研的3D TokenPU芯片,已完成流片。这意味着,国内基于3D混合堆叠工艺的AI推理芯片,终于从图纸走向硅片。对于大模型算力供给日趋紧张的局势,这是一个值得关注的本土硬件信号。
核心突破:3D混合堆叠架构
这颗芯片的关键看点在于架构和工艺路线。它采用前沿的3D混合堆叠架构,与传统2D平面设计完全不同。简单来说,通过多层晶圆垂直堆叠,存储单元和计算单元间的物理距离被压缩到极致,大幅缩短数据传输路径。
性能亮点:16TB/s超大带宽
这种结构带来16TB/s的超大带宽。大模型推理场景中,长期存在“隐形瓶颈”——带宽不足导致数据搬运效率低,进而拉高延迟和功耗。TokenPU的设计从底层硬件逻辑出发,有针对性地回应了这个痛点。
产业价值:提升大模型推理效率
当前国内大模型产业快速扩张。无论是云端推理还是端侧部署,算力需求激增。传统芯片受限于带宽天花板,陷入高功耗、低推理速度的困境。3D TokenPU凭借超高带宽优势,有效降低数据搬运损耗,显著提升大模型推理效率。从通用大模型到多模态生成,再到实时对话等高负载场景,这颗芯片都试图覆盖更广。
国产化底色:全流程自主可控
另一个值得留意的点是“国产化底色”。从架构设计到流片制造,全部依托国内产业链完成,真正实现了全流程自主可控。在此之前,3D堆叠算力方案主要由海外玩家主导。本土同类产品几乎是空白。这次流片成功,不只是一家公司的技术突破,更是在高端AI算力硬件这条短板上,添上了一块重要拼图。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- 广东首个Token贷发布:中行前期试单授信资金已达2800万元
- 时间:2026-08-14
-

- 助推AI算力普惠!苏宁易购与骋风而来达成战略合作
- 时间:2026-07-24
-
- 阿里Token Plan个人版发布 Qwen3.8-Max预览版同步上线
- 时间:2026-07-20
-

- 黄仁勋:token吞吐量越高 收入就越高
- 时间:2026-06-25
-

- 周鸿祎谈放弃龙虾:查天气要消耗上千万Token 太浪费了
- 时间:2026-06-24
-

- 人民锐评:新能源车太“胖”、token太“耗”?盲目堆料不如更聪明地创造
- 时间:2026-06-19
-

- 超百万现金激励 TRAE AI创造力大赛正式启动
- 时间:2026-06-16
-

- 9.9元起!三大运营商齐上线Token套餐:AI算力像话费一样包月
- 时间:2026-05-19

精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15