传音控股获多语种对话语音语言模型挑战赛Task1亚军
时间:2026-08-12 | 作者:星际追番人 | 阅读:0近日,在国际语音领域顶级会议INTERSPEECH 2026卫星活动——第二届多语种对话语音语言模型挑战赛 (Multilingual Conversational Speech Language Model Challenge,MLC-SLM)Task 1赛道中,传音TEX AI中心语音算法团队以自主研发的说话人归属多语种自动语音识别系统取得tcpMER 15.41%的成绩,在全球110支参赛队伍中位列第二。
此次突破展现了传音在多语种语音识别、说话人日志、时间对齐与长音频工程化系统等关键方向的系统性技术实力。

赛事聚焦真实多人对话场景
本届赛事把焦点放在多语言对话语音模型最棘手的几项关键技术挑战上,最终吸引了全球工业界和学术界共110支队伍报名参赛。
官方提供的训练数据规模约为2100小时,覆盖14种语言和21个语言变体。
MLC-SLM 2026 Task 1直指真实的多人对话场景。赛事要求系统直接处理未经预切分、也未标注说话人的长音频,并输出“谁在什么时间说了什么”的带说话人转写结果。
挑战赛采用的评价指标tcpMER,会同时衡量文本准确率、时间位置以及说话人归属。
任何一个环节只要出现偏差,都会一路传导到最终结果。这实际上是在对语音算法全链路的协同能力进行高强度检验。
构建级联系统应对多重挑战
面对多语种、快速轮次切换、短暂停顿、说话人交叠以及长音频处理等挑战,传音TEX AI中心语音算法团队没有局限于单一模型优化。
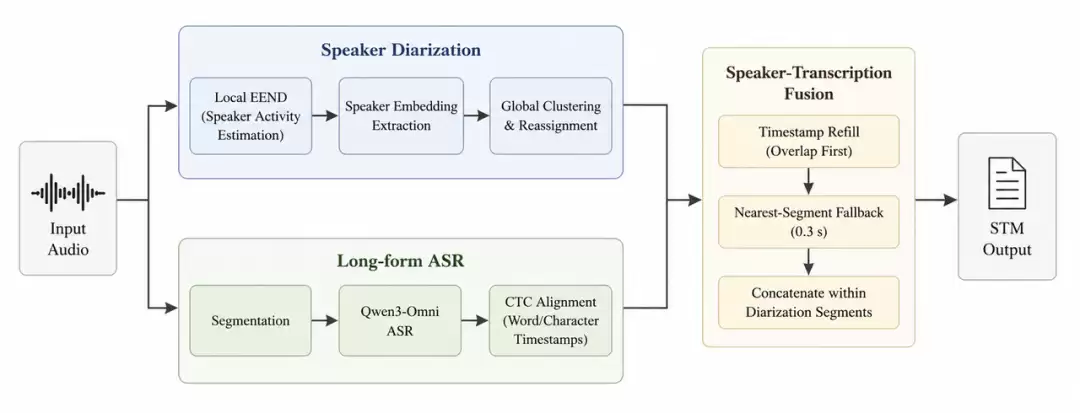
团队构建了由Speaker Diarization(说话人分离)、Long-form Multilingual ASR(长音频多语种自动语音识别)和Speaker-Transcription Fusion(说话人与转写融合)组成的级联系统。
- Speaker Diarization(说话人分离):恢复跨片段一致的说话人结构,对不同说话人进行准确区分。
- Long-form Multilingual ASR(长音频多语种自动语音识别):对多语种长音频进行高精度转写,并为识别结果标注精确的时间戳。
- Speaker-Transcription Fusion(说话人与转写融合):最终融合生成可评测、可追溯的说话人归属转写结果。
系统形成了从数据清洗、模型训练、推理解码、时间对齐到结果融合的闭环优化能力。
核心指标tcpMER稳步降至15.41%
持续且可复现的实验验证,往往是团队实现技术突破的关键基石。
团队并未止步于基线表现,而是通过一系列增量式实验逐步打磨模型。
这些实验涵盖以下关键环节:
- Local EEND 任务适配
- 融合策略优化
- 说话人表征与聚类后端升级
- SD 条件化切分
这一过程使得赛事核心评价指标 tcpMER 从最初的 22.78% 稳步降至 15.41%,实现了 7.37 个百分点的绝对降幅。
相对提升幅度更是达到了约 32.4%。
与此同时,团队还完成了端到端方案 VibeVoice-ASR 的适配验证,成功确立了级联系统与端到端系统并行探索的技术路线。
这也为后续算法的进一步演进储备了充足的潜力。
为实际业务落地奠定基础
此次赛事成绩突破,验证了传音TEX AI中心语音算法团队在多语种语音理解领域的深厚积累。
目前,团队已具备将说话人日志、多语种自动语音识别和精细化时间对齐能力灵活组合的工程能力。
可根据不同业务场景灵活替换和升级识别模型,并保留可检查、可定位、可持续迭代的中间结果链路。
这为相关技术在实际业务中的快速落地和持续迭代奠定了基础。
持续推进多语种语音技术应用
多年来,传音持续加大在多语种语音识别、语音合成及降噪等领域的研发投入。
技术能力已覆盖多种语言及本地口音、方言变体,并广泛应用于智能终端的通话、录音、翻译等多个场景。
这为传音在新兴市场复杂语言环境下的语音体验优势提供了坚实支撑。
未来方向
未来,传音将持续深化多语种语音交互与语音理解技术研究。
推动相关能力在全场景录音、智能终端及更多真实语音交互场景中落地,为全球用户提供更自然、更精准、更具理解力的智能语音体验。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 爱芯元智开源Magnetar一站式模型部署工具发布
- 时间:2026-08-21
-

- 沐曦股份完成阿里千问Qwen3.8-2.4T-A95B大模型Day 0适配
- 时间:2026-08-21
-

- 昆仑万维发布Mureka V9.5 AI音乐生成模型快速制作高质量原创音乐
- 时间:2026-08-21
-

- 智在无界发布隐式触觉世界模型推动具身智能发展
- 时间:2026-08-13
-

- 国产大模型涨价美国模型降价背后的Token价值规律
- 时间:2026-08-12
-

- 摩尔线程完成MiniMax H3多模态生成模型适配部署
- 时间:2026-08-12
-

- SpaceXAI推出Grok 4.5新模型:效率翻倍,价格减半
- 时间:2026-07-29
-
- 谷歌正式推出Gemma 4 12B多模态人工智能模型新版本
- 时间:2026-07-23
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15