Spark 3.5安装部署教程:Local模式配置与使用详解
时间:2026-08-17 | 作者:云端旅人 | 阅读:0Spark 是一个通用的大数据处理引擎。对于初学者来说,local mode 是入门学习和快速验证最直接的方式。
它不需要集群资源,单机就能运行。对于想先上手体验Spark 3.5的朋友,这篇教程会一步步带你完成本地模式的安装与配置。
整个过程以可操作为主,适合练习和演示使用。
下载
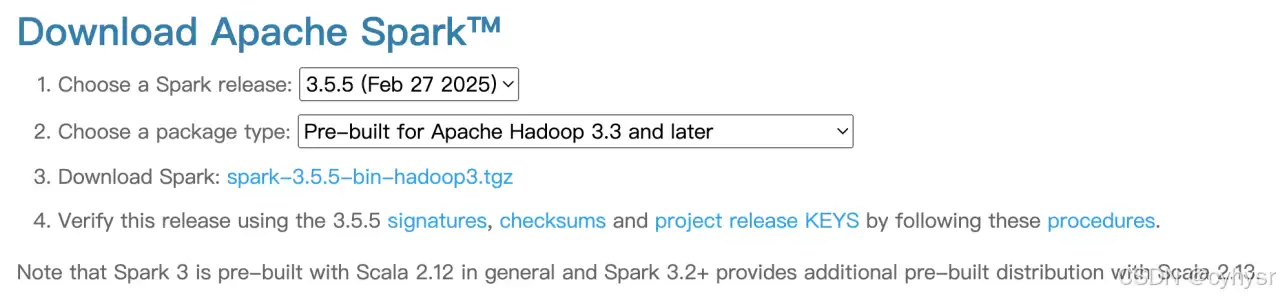

先说清楚什么是local模式:它本质上就是本地模式。
这种模式不需要任何其他节点资源,在单机环境下就能执行Spark代码。
非常适合练习和演示用途。
上传解压
使用PortX将文件上传至/opt目录。

进入/opt目录,创建module目录。
然后将压缩包解压到/opt/module下。

进入module目录后,顺手把目录名改得清爽一点。

配置jdk
启动Spark之前,必须先装好JDK。
先把JDK文件上传到服务器。

解压
执行解压命令:
tar zxvf jdk-8u271-linux-x64.tar.gz

配置环境变量
使用root用户来配置环境变量。
先切换到root家目录。


保存后,以root用户执行source .profile使更改生效。
然后验证一下Ja va版本是否正常。

启动查看
进入Spark的解压目录,这里命名为spark-local。
执行bin/spark-shell启动Spark。
看到如下日志输出,就说明启动成功了。

启动成功后,可以通过浏览器访问WebUI监控页面:
http://ip:4040

交互操作
有两种方式与Spark进行交互:
- 命令行交互
- 提交作业
下面分别演示。
命令行
进入Spark目录下的data文件夹,创建一个test.txt文件。

执行vi test.txt编辑内容。

然后进入spark-standalone/bin目录,执行./spark-shell启动命令行。
输入以下代码,进行经典的WordCount测试:
sc.textFile("../data/test.txt").flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_).collect

退出命令行可以按Ctrl+C。
或者输入:quit后回车。
提交应用
在实际生产或批量数据处理中,一般不会手动敲命令。
更常见的做法是编写好Spark程序,再通过spark-submit指令提交给集群去计算。
这里用Spark自带的Pi计算示例来演示提交方式:
bin/spark-submit

--class org.apache.spark.examples.SparkPi

--master local[2]

./examples/jars/spark-examples_2.12-3.5.5.jar
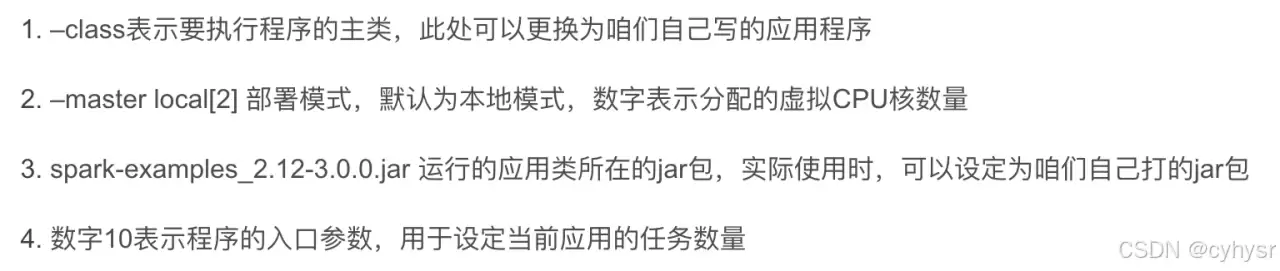

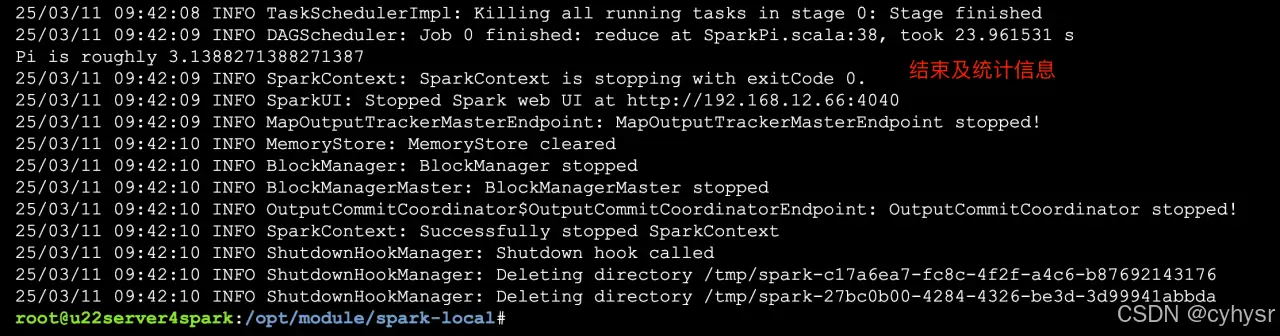
备注:路径等信息参考下图,所有示例代码都位于Spark目录下的对应位置。


免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 告别Gradle:揭秘Scala开发者青睐的sbt构建工具
- 时间:2026-08-27
-

- Akka 实战:测试驱动开发 TDD 与 Actor 测试策略
- 时间:2026-08-27
-
- Scala 下划线 `_` 的常见用法,一次看清它在不同语境里的含义
- 时间:2026-08-25
-

- 从递归练习到 Akka 心跳机制:几段 Scala 常见题目的实现思路
- 时间:2026-08-25
-

- Scalatra 返回 JSON 时最容易踩的几个坑,顺手把正确写法梳理清楚
- 时间:2026-08-25
-

- Atmosphere 的“Exception during suspend() operation”到底在报什么
- 时间:2026-08-25
-

- Scala 与 akka-stream 如何处理广告竞价后半程
- 时间:2026-08-25
-

- 本地配置 Scala 开发环境:从 IntelliJ 接入到 Hello World 验证
- 时间:2026-08-25
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15