在 Scala 里,下划线 _ 几乎无处不在,看起来像一个统一符号,实际却承担了默认值、占位参数、方法转函数、可变参数展开等多种角色。真正难的不是记住它出现过,而是判断当前语境里它到底代表什么、哪些写法能省、哪些地方又必须补上类型说明。下面按常见开发场景逐项梳理,结合原始代码示例,把容易混淆的几种用法一次看清。
成员变量初始化:用 _ 取得类型默认值
Scala 和 Java 一样,类中的成员变量如果没有显式赋值,可以拥有默认值。但在 Scala 里,如果你想手动声明“这里就用默认值”,需要写成 = _。这一写法只适用于 var,不能直接用于 val。
这里要特别注意一点:如果希望某个引用类型最终表现为 null,就必须显式写出变量类型;否则编译器会把它推断成 Null,语义就变了。
// _ 对应的默认值:整型默认值0;浮点型默认值0.0;String与引用类型,默认值null; Boolean默认值false
class Student{
    //String类型的默认值为null
    var name : String = _
    var age: Int = _
    var amount: Double = _
    var mOrF: Boolean = _
}
可以把这类用法理解为“按类型补零值”:Int 是 0,Double 是 0.0,Boolean 是 false,字符串和其他引用类型通常是 null。
方法、函数与偏应用:下划线如何参与函数化
Scala 里经常把 def 定义的方法和 val 保存的函数放在一起使用。多数时候两者可以顺畅配合,但在某些场合,方法并不会自动当成函数值处理,这时就需要借助下划线完成转换。
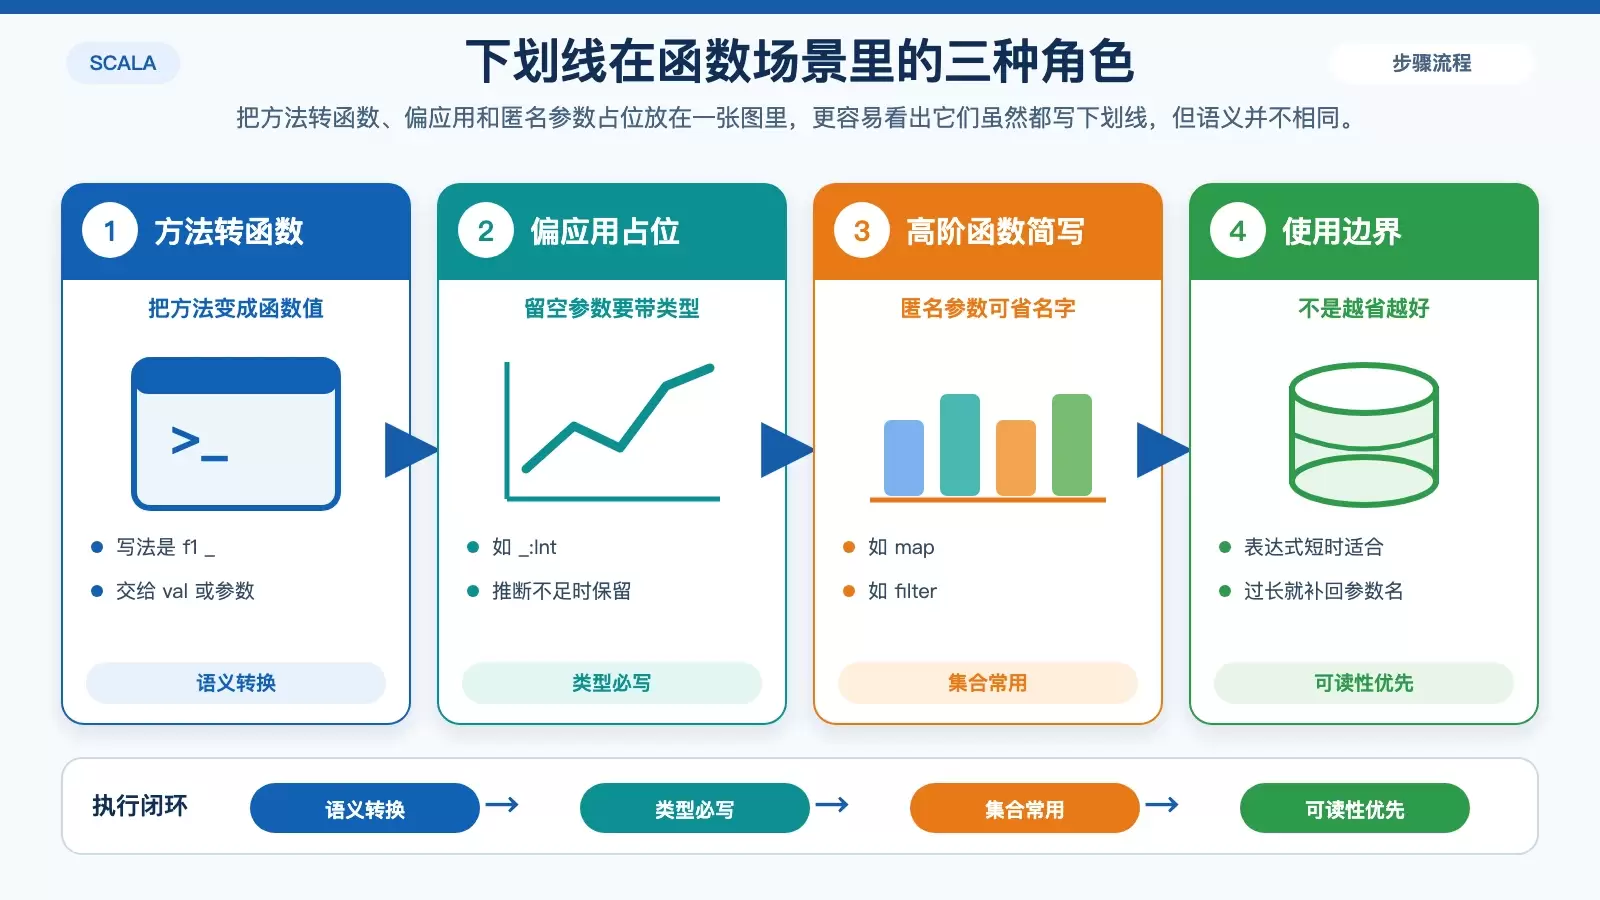
方法转函数
严格说,def 定义的是方法,val 接住的是函数值。把方法转成函数时,常见写法就是在方法名后补一个 _。
scala> def f1 = ()=>{}
scala> val f2 = f1 _
这类写法的核心含义不是“执行方法”,而是“把方法本身交出去”。当你需要把一个方法赋值给变量、作为参数传给高阶函数,或者延后调用时,这种转换就很常见。
部分应用函数与参数占位
下划线在偏应用函数里也很重要。所谓部分应用函数,就是一个原本有多个参数的函数,只先固定其中一部分,剩余参数留待后续调用时再传入。这个“留空位”的动作,通常就由 _ 来表示。
// 定义一个函数
def add(x:Int, y:Int, z:Int) = x+y+z
// Int不能省略
def addX = add(1, _:Int, _:Int)
addX(2,3)
addX(3,4)
def addXAndY = add(10, 100, _:Int)
addXAndY(1)
def addZ = add(_:Int, _:Int, 10)
addZ(1,2)
// 省略了全部的参数,下面两个等价。第二个更常用
def add1 = add(_: Int, _: Int, _: Int)
def add2 = add _
这里的重点有两个。第一,参数类型在某些位置不能省,尤其是编译器无法准确推断时,_ : Int 这种写法要保留。第二,如果全部参数都交给下划线处理,那么 add _ 就是更常见也更简洁的写法。
导包与高阶函数:最常见也最容易顺手写的两类场景
很多开发者第一次熟悉下划线,往往就是从导包和集合操作开始的。这两种场景出现频率高,而且写法很短,但它们表示的含义并不相同。
导入包内全部成员
在 Scala 中,导入包下全部内容的写法是 _,作用类似 Java 里的 *。
//Scala
import ja va.util._
//Ja va
import ja va.util.*;
这类语法比较直观,记忆成本不高,关键是不要和其他场景里的“参数占位”混在一起理解。
高阶函数里省去参数名
在 map、count、sortWith、filter、reduce 这类高阶函数中,传入的往往只是一个很短的匿名函数。如果参数名本身没有语义价值,就可以直接用 _ 来占位,减少样板代码。
val list = List(3,3,5)
list.reduce(_+_) //等同于list.sum()
list.map(_ * 2)
list.filter(_ > 3)
这类写法适合逻辑非常直接的场景,比如“每个元素乘 2”“只保留大于 3 的元素”。但如果表达式一长,或者包含多个条件判断,继续强行使用下划线反而会影响可读性,这时恢复成显式参数名更稳妥。
元组、可变参数和模式匹配:三种经常一起考察的语法点
除了函数式风格中的大量使用,下划线还常出现在 Scala 的基础语法里。它们看起来分散,但都属于“用一个符号代替具体名字或结构”的思路。

访问元组元素
元组中的元素可以通过 _1、_2 这类方式访问。
val tu = (1,2,3)
tu._1
tu._2
它不是匿名占位,而是元组位置访问器。看到 _1、_2 时,应当直接理解为“第 1 个元素”“第 2 个元素”。
集合展开为多个参数
如果方法接收的是可变参数,而你手里已经有一个数组或集合,那么可以通过 _:* 把集合展开成多个独立参数。
def addSum(nums: Int*) = {
  nums.sum
}

addSum(1 to 10: _*))
这个写法在调用可变参数方法时很实用,尤其是数据本来就来自 List、Range、数组等集合类型时,可以避免手动拆参数。
模式匹配中的默认项与类型占位
在模式匹配里,下划线通常表示“兜底分支”或“这个位置的名字不重要”。做类型匹配时,也可以只写类型,不再额外起变量名。
val a = 10
a match {
  case _: Int => println("Int")
  case _ => println("defalult")
}
这里的 case _: Int 表示“只关心它是不是 Int,不关心变量名”,而 case _ 则是标准的默认分支。
命名约定中的下划线:手写 setter 的实现方式
Scala 里下划线还会出现在成员变量和 setter 方法的命名中。这种写法常用于手动封装内部状态,并暴露一组更符合 Scala 风格的访问方法。
下面这个例子中,_leg 是私有字段,leg 是 getter,leg_= 则是 setter。调用时既可以显式写成 dog.leg_=(4),也可以直接写成更自然的 dog.leg = 5。
class Dog {
  private var _leg = 0
  def leg: Int = _leg
  def leg_=(newLag: Int) = {
    _leg = newLag
  }

  def get() = {
    _leg
  }
}
object GetterAndSettre {
  def main(args: Array[String]): Unit = {
    val dog = new Dog
    dog.leg_=(4) //等同于 dog.leg = 4 ,都是修改了_leg的值
    println(dog.get())
    dog.leg = 5
    println(dog.get())

  }

}
这类下划线更多是一种命名和访问约定。前缀下划线强调内部字段,后缀 _= 则让赋值语法能够按 Scala 的方式工作起来。
怎么快速判断当前的 _ 到底是什么意思
理解 Scala 下划线,最有效的方法不是死记“九种用法”,而是先看它所在的语境:
- 出现在
= _中,通常表示按类型取默认值; - 出现在方法名后面,多半是在把方法转换成函数;
- 出现在高阶函数参数位置,通常是匿名参数占位;
- 出现在
_:*中,表示把集合展开成可变参数; - 出现在
_1、_2中,表示访问元组位置; - 出现在
case _或case _: Type中,属于模式匹配语法; - 出现在
leg_=这类名字里,则是 setter 命名规则的一部分。
从开发角度看,下划线确实能大幅减少样板代码,但前提是场景合适、可读性还在。写得太“省”,有时反而会把语义藏起来。真正实用的经验是:能一眼看懂就用,下划线一多开始费解时,就把参数名和类型补回来。