Agent终极考试上线:最强模型得分率仅8.6%Claude Code挂零
时间:2026-08-18 | 作者:实验室老王 | 阅读:0如今,AI 模型看上去越来越强了:棋类游戏能赢顶尖选手,在主流 benchmark 上不断刷新 SOTA。
但为什么就是没法真正帮人类干活?
由加州大学伯克利分校牵头、联合 250 余位行业专家组成的研究团队,给出了这个问题的答案:
问题不在 AI 本身,而在评估体系。
现有常用基准,已经无法持续衡量在真实、长流程、具经济价值工作中的表现。
针对这个问题,研究团队提出了新的基准Agents’ Last Exam(ALE)。
之所以叫“最后的考试”,一是针对能力门槛,二是针对难度前沿。
只有当前 AI agents 真的能通过这场考试,才算具备了持续完成真实专业工作的能力,benchmark 上的提升才更有价值。

这场考试的结果也很直接:主流模型虽然能在传统 benchmark 上拿高分,但在 ALE 最难层级中,平均完整通过率则是 2.6%。
这说明,目前,Agent 距离稳定完成复杂、长流程的专业任务,仍有不小差距。

图|Agents’ Last Exam 涵盖了大量不同类型的专业任务和真实工作流程。
“最后一场考试”考什么?
Agents' Last Exam(ALE)是一个由250余位行业专家共同开发的 AI Agent 评测基准。
它用来衡量 AI 在长期、具有经济价值的真实工作流程中的表现。
为了测试 AI 能不能像人一样在电脑上完成真实工作,研究团队收集了 1490 个任务。
这些任务覆盖制造、法律、医疗、视觉媒体等多个领域。
任务都来自真实从业者的日常工作。
- 有的要求 AI 画出 3D 模型
- 有的要求它在达芬奇里完成绿幕抠像和视频合成
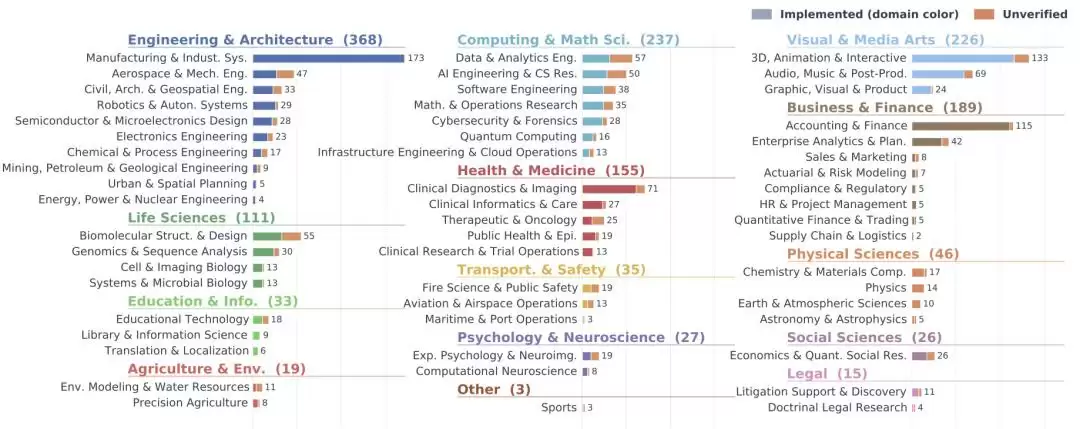
图|ALE 分类体系下 1490 个任务实例的分布情况
相比常见的问答或短流程基准,这类任务对 Agent 提出了更高要求。
研究团队把这类 Agent 称为Generalist Computer-Use Agent(GCUA)。
它不仅要会操作界面,还得具备一整套通用工作能力:
- 跑命令行
- 处理文件
- 写代码
- 调用工具
- 完成完整工作流程

图|典型的 GCUA 框架结构。
为了测试这些对象的真实能力,ALE 提供了一整套可以执行和评分的任务环境。
具体执行时,任务脚本会负责加载任务、准备环境和最后评分。
Agent 则根据任务描述,自行完成以下过程:
- 观察环境
- 选择动作
- 持续执行
任务结束后,脚本会直接检查结果。
93.2% 的任务都能自动判分,无需人工打分。

图|任务构建流程。
考试成绩怎么样?
研究团队指出,如果只看最难一档的任务,当前表现最好的配置是 Codex + GPT-5.5,完整通过率也只有 8.6%。
研究团队给出的主流系统平均完整通过率则是 2.6%。
研究团队还列举了几个具体的失败案例。
- 在音乐转谱任务中,需要提交总谱 PDF、MIDI 和界面截图,但 AI 只导出了 MIDI 文件,最终拿了 0 分。
- 注塑仿真任务中,AI 在 Moldex3D 中完成了仿真并导出结果,但没能稳定提取关键数值,最终得分为0.4762。
- 在绿幕合成任务中,AI 虽然导出了视频,但结果没有满足参考要求,因此同样得分0 分。

图|ALE 的主要结果。

图|实验分析概览。
研究团队随后对失败原因进行了分类。
以Claude Code + Opus 4.7为例,31%属于理解问题,47%属于方法问题,22%属于执行问题。
理解和方法问题合计约占八成。
研究团队据此指出,当前系统的主要瓶颈在于领域知识,而不是执行能力。
研究团队还比较了模型和 agent 框架的影响。
结果显示,更换模型带来的结果差异,要明显大于更换 agent 框架。
- 固定 agent 框架、只更换模型时,整体通过率最高和最低之间相差18 个百分点
- 固定模型、只更换 agent 框架时,这个差距大约只有5 到 6 个百分点
模型选择带来的影响范围,大约是 agent 框架的三倍。
不足和未来方向
研究团队也指出,ALE 以 SOC 2018 为职业分类骨架,覆盖的主要是软件型、数字化的专业工作。
现阶段,任务也主要运行在 Linux 或 Windows 虚拟机中。
此外,ALE 在不同领域上的覆盖也并不均衡。
有些方向任务覆盖较多,有些方向则很少。
- 能源与核工程只有4 个任务实例
- 城市与空间规划有5 个
- 法律领域是15 个。
公开集目前只占完整任务池的一部分。
研究团队做过一次检验:在 Claude Code + Opus 4.7 上,公开子集和完整任务池在各领域通过率上的相关系数只有 0.89。
不过,研究团队认为,ALE 是一个持续更新的基准。
未来,任务池会继续扩展到新的工作流和新的行业。
目前保留在私有池中的任务,也会定期轮换进入公开集。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 微软自研AI编程大模型取代Claude 开发者受益
- 时间:2026-08-22
-

- Claude iOS版设置菜单重设计上线,新增记忆文件功能
- 时间:2026-08-21
-

- Claude攻克百年数学猜想,黎曼猜想之后再引关注
- 时间:2026-08-21
-

- 微软意外泄密Claude Mythos万亿参数与训练规模曝光
- 时间:2026-08-21
-

- 专家预测年底实现,Claude Mythos今日跑出3小时6分成绩
- 时间:2026-08-21
-

- AI编程新范式崛起:提示词工程会被取代吗
- 时间:2026-08-21
-

- Bun用Claude Code 9天重写100万行代码后安全吗测试通过率引质疑
- 时间:2026-08-21
-

- 把Claude Code作为可编程基础设施:从提效工作到让系统自动干活
- 时间:2026-08-20
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15