OpenSkill智能体自进化新范式:孙立超团队刷新多项基准SOTA
时间:2026-08-18 | 作者:星河游者 | 阅读:0当前,自进化Agent的持续学习,基本都靠成功轨迹、现成技能或者明确反馈。
但在真实部署场景下,这些前提条件往往很难同时满足。结果就是Agent不断卡在原地,既没法积累经验,也没办法迭代自己的表现。
针对这个瓶颈,里海大学孙立超团队与合作者提出了一个新的框架——OpenSkill。
它和依赖人工标注、大模型生成或者监督信号的自进化方法完全不同。核心思路是:即使不依赖目标任务的监督信号,Agent也能自己拿到可执行、可迁移的技能。

结果显示,OpenSkill在多个基准测试上都达到了SOTA的自动化表现。
而且,学到的技能还能直接迁移到能力更弱的模型上,效果相当不错。

图|自进化Agent技能的范式。
OpenSkill 是怎么设计出来的?
一句话概括,OpenSkill是一个面向开放世界的Agent技能框架。
它把任务指令、执行环境、基础模型、工具访问权限、开放世界资源这些因素作为输入,并将流程拆成三步:开放世界知识获取、无泄漏技能进化、零样本目标评估。

图|OpenSkill 框架概览。
第一步:开放世界知识获取
团队先到开放世界里找两类信息:
- 任务知识:像背景概念、API文档、最佳实践、代码示例这一类,用来辅助技能规划。
- 验证知识:包括参考值、统计不变量、交叉验证流程,以及已知的输入输出样例,这些专门用来支撑后面的虚拟测试。
第二步:无泄漏技能进化
拿到了任务知识和验证知识以后,OpenSkill会先生成候选技能。
随后,它会通过自动构造的虚拟任务,反复测试、筛选、改进这些技能。
整个过程里,目标任务的标准答案完全没有泄露出来,真实测试集也不会提前掺合到技能构建阶段。
第三步:零样本目标评估
技能进化完成后,最后会以显式文件的形式部署到目标Agent上。
只有那个藏起来的真实测试集,才会在这一步拿来做最终评估,完全不参与前面的技能构建与迭代。
一句话说就是:训练归训练,测试归测试,互不干扰。
实验结果怎么样?
为了验证OpenSkill到底行不行,团队从基准测试表现、技能迁移和消融实验三个方面做了评估。
1. 基准测试:OpenSkill总体表现领先
OpenSkill在三个基准测试、两个目标Agent上,都拿到了最佳自动化表现。
在SkillsBench上,它把Opus 4.6和GPT 5.2的总体通过率直接抬到了43.6%和42.1%。
相比最强基线,分别高出了8.9和8.8个百分点,离人类参考上限只差1到3个百分点。
更有意思的是,在Opus 4.6上,11个领域里有8个都达到了最佳或并列最佳的效果。
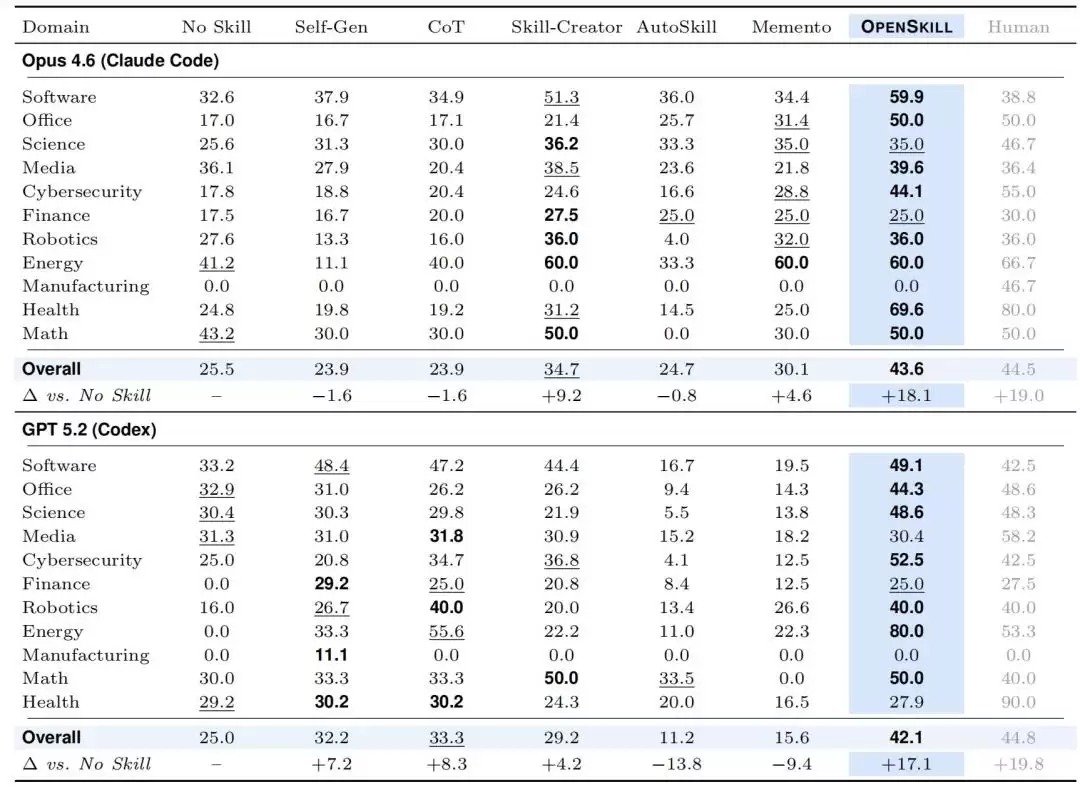
图|SkillsBench在11个领域的主要结果:展示了两个目标Agent在各领域上的平均奖励。
类似的优势也出现在另外两个基准上。
- 在SocialMaze里,OpenSkill让Opus 4.6和GPT 5.2的通过率分别达到了82.7%和70.7%。
- 在ScienceWorld里,这两个数字是90.0%和85.3%。
团队指出,在这四组设置里,OpenSkill就是所有自动化方法里表现最好的,没有之一。

图|两个目标Agent在SocialMaze和ScienceWorld上的平均奖励。
2. 技能迁移:不用额外适配,就能迁移到更弱模型
在技能迁移这部分,团队把Opus 4.6生成的技能,直接移植到了Haiku 4.5、Qwen 3Coder、DeepSeek V3、Mistral Large 3这4个更弱的模型上,完全没做额外适配。
结果很清楚:这些技能在4个目标模型上都带来了非常明显的增益。
跟没有技能的基线相比,提升了5.5到14.8个百分点。
这说明学出来的技能确实有泛化价值,不是针对特定模型“定制”的。

图|由Opus 4.6生成的技能迁移到其他模型后,在SkillsBench上获得的平均奖励。
3. 消融实验:三轮迭代效果最好
在SocialMaze上,OpenSkill在3轮迭代时达到了最高的82.7%。
但如果继续增加到5轮和10轮,效果反而往下走。
消融结果也指出,开放世界检索和虚拟验证器,每一块单拎出来都能提升表现,但合在一起效果才最好。
团队进一步发现,虚拟验证器跟真实评测结果之间的一致性很高。
- 能覆盖88.9%的真实测试意图。
- 还能额外补充格式、类型、边界条件之类的检查。
等于在真实评测之外,又加了一层非常实用的“保险”。

图|SocialMaze上的消融实验。
局限与未来方向
当然,团队的坦诚也值得关注。
开放世界知识源本身就可能存在噪声、过时甚至相互矛盾的信息。虚拟任务也很难完全复现真实任务的复杂程度。
尤其在深层语义验证和反作弊元验证这些环节上,目前的覆盖还比较有限。
另一个不得不提的问题是:成本高、耗时长。
在SkillsBench的84个任务上,端到端API总成本大约1800美元,单任务要消耗大约1.14M tokens,差不多耗时131分钟。
但好在一套技能只需创建一次,后续迁移到其他模型时就不需要重新搞了。
展望未来,团队明确了三个大方向:
- 提升知识源的可信度
- 增强虚拟任务对真实任务的覆盖能力
- 想办法降低整体成本与时延
毕竟,成本也是落地时绕不开的大山。
更多技术细节,可以参考原论文。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 阿里千问开放第三方Agent与Skill接入,瑞幸东航首批测试
- 时间:2026-08-21
-

- 将老员工经验沉淀为Agent可调用资产:Skill与MCP治理实践
- 时间:2026-08-21
-

- Microsoft Agent Framework 1.0发布:Agent开发迈入工程化时代
- 时间:2026-08-21
-

- 郑州GEO源码推荐指南:核心要点与靠谱选择技巧
- 时间:2026-08-18
-

- 小红书上线RED Skill功能:AI应用深度嵌入社区笔记场景
- 时间:2026-08-18
-

- AI简历优化工具怎么选:校招社招ATS兼容与数据安全指南
- 时间:2026-08-17
-

- AI简历工具推荐:国内与海外及ATS和全流程能力区别
- 时间:2026-08-17
-

- AI改简历如何避免改过头:事实约束、JD定向与工具选择指南
- 时间:2026-08-17
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15