消费级显卡运行Opus级Agent:Qwen3.8-27B多项榜单超越Claude
时间:2026-08-18 | 作者:穿越地图的猫 | 阅读:0梦瑶 发自 凹非寺量子位 | 公众号 QbitAI
开发者苦等已久的Qwen3.8-27B终于开源了。
270亿的总参数量,让它在最新Benchmark多项软件工程和Agent评测中的表现非常亮眼,多少又有点让Claude《危》了。
Agent编程评测SWE-bench Pro上,27B以8.3分的优势卷超Claude Opus 4.6 Max。
到了更考验真实软件工程能力的QwenSWEBench,甚至领先幅度进一步扩大到15.2分:

小尺寸,但能力并不弱
尺寸虽小,参数配置和模型表现配的可不孬。
它具备原生多模态、262K原生上下文、最高100万Token扩展能力。
同时,重点强化的Coding、专业工作和长程Agent能力,也一项没落下。
好东西大家自然都想尝鲜一番。
这不,已经有一大波网友开始大roll特roll了。
下面这老哥用3.8-27B和3.6-27B分别做了个像素风宝塔效果,3.8-27B在色彩细节和主体结构明显更next level~

还有网友用Qwen3.8-27B做的俄罗斯方块——
甚至连空格键掉落时的屏幕抖动、消除行时出现的奖励倍增器效果,也都是模型自己添加的:

甚至还有网友说:好啊好啊,那这意思是,差不多咱以后可以在本地跑「Opus级」模型了!?

Qwen这模型,多少还是有点说法的。。。

270亿参数,代码和Agent多项榜单超过Opus 4.6 Max
Qwen3.8这一代,最近上新速度属实有点快。
而且这只27B,开发者友友们其实已经蹲挺久了。
正式开源之前,社区里的《催更》就没怎么停过。
也有不少人直接把它列进这一轮Qwen3.8里最值得等的开源版本。
大家之所以这么惦记,一个特别现实的原因就是——这回,自家电脑真有机会带得动了。
毕竟,总参数量就「270亿」。
换句话说,经过量化之后,24GB显存的RTX 3090、4090这类显卡,都有机会把模型整卡装下~

尺寸下来了,但上下文长度一点没缩水。
它原生支持262K Token上下文,还可以继续扩展到100万Token。
重点强化方向
具体到干活场景,这一代27B重点强化的方向很明确:
- 编程
- 专业工作
- 研究
- 长程Agent任务
这些基本都是现在开发者最常拿模型狠狠干活的地方。
原生多模态是重点能力
但这里特别值得单独拎出来说一个能力——原生多模态。
需要给友友们划个重点,Qwen3.8-27B本身就带视觉理解和解析能力。
意思就是,它除了读文字、啃代码,还能直接看图片、读PDF文档、理解图表,甚至处理视频!!!

尺寸够小,能往本地塞。
上下文够长,能吃大工程。
多模态和Agent能力又都保留了。
至于这些本事到底练到什么程度,最新榜单已经给出了一波答案。
代码与Agent评测表现
先从最适合拿来干活的两项看:代码和Agent。
- 在编程评测SWE-bench Pro里,Qwen3.8-27B比Claude Opus 4.6 Max高出8.3分。
- 到了软件工程评测 QwenSWEBench,领先幅度进一步拉到15.2分。
- Agent评测中面向计算机、金融、法律、医疗等专业长任务的CoWorkBench达到70.7分,也超过Opus 4.6 Max的68.2的成绩。

多模态操作能力表现
再看多模态能力这边,模型能力提升表现甚至更集中。
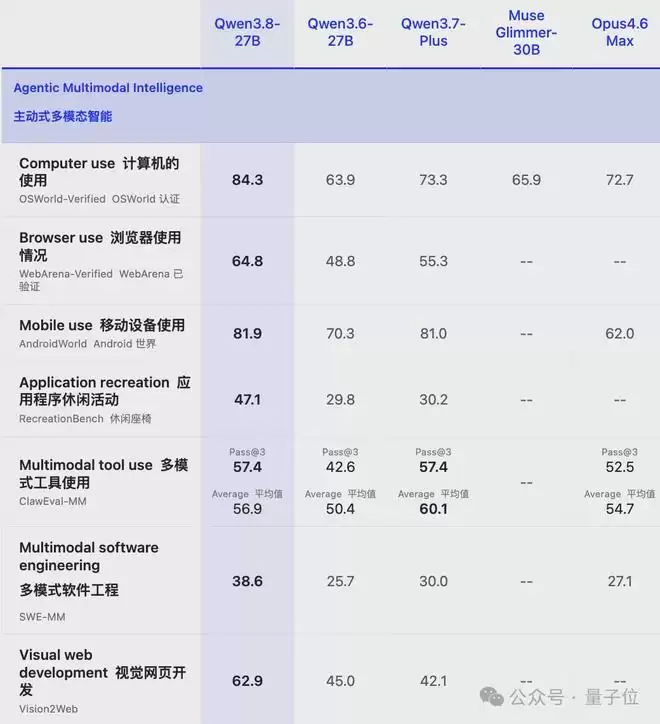
- 在电脑操作评测OSWorld-Verified中,Qwen3.8-27B拿到84.3分,Opus 4.6 Max是72.7。
- 在手机操作评测 AndroidWorld 里,Qwen3.8-27B拿到了81.9分,而 Opus 4.6 Max 只有62.0。
- 在浏览器操作 WebArena-Verified,成绩也从上一代的48.8一路提升到了64.8。
通用视觉推理能力
通用多模态智能这边,也有几项维度可以一起看一下。
在视觉数学问题解决能力上,开启CI后,Qwen3.8-27B拿到94.6分。
这是图里这一排可见模型中的最高成绩。
这类任务不只是识别图片里的字,还得把图形、公式、空间关系一起理解。
在通用视觉推理方面,Qwen3.8-27B开启CI后做到85.6分。
相比不开CI时的65.7,提升非常明显。
它更偏向考模型面对普通视觉场景时,能不能从「看见东西」进一步走到「理解关系、做判断」。
这成绩也说明,这代27B模型在看图、读文档和视觉推理这些任务上,模型覆盖的场景和性能表现更多更强。

网友已经开始实测了
好东西大家自然要一试。
这不,各方网友大神已经开始集体研究「这小27B模型到底该怎么跑」了。
比如下面这位友友用Qwen3.8-27B做了一个贪吃蛇游戏后,直言感觉像拥有了一个Opus级别的Agent——

还有网友直接把Qwen3.8-27B-FP8放到一张NVIDIA GH200上实测。
同时跑10个真实请求,每个最高输出16K Token、上下文拉到262K。
结果首批流式Token基本都在10ms内返回,10个请求也全部正常完成。
高并发和长上下文下的运行稳定性确实夯:

还有网友直言,模型的多模态理解能力也非常不错。
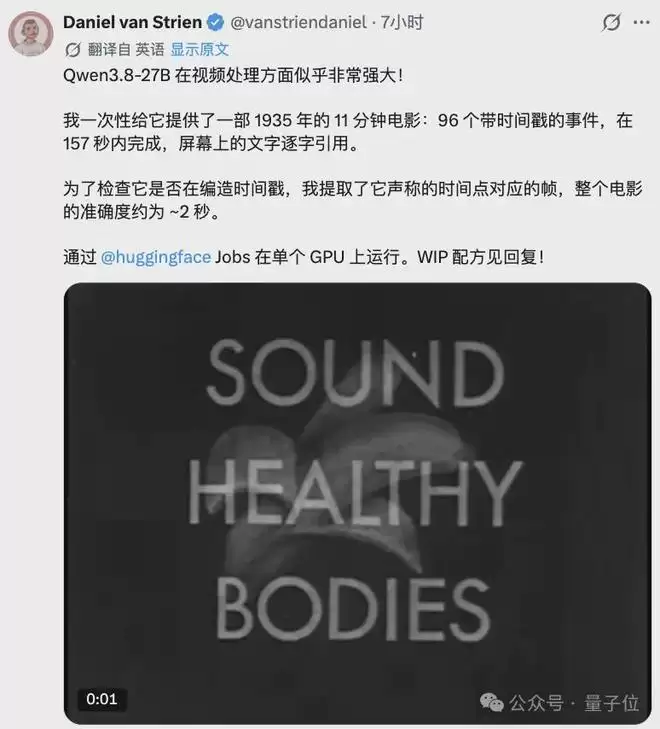
一次性丢给它一部1935年的11分钟电影,让模型识别其中96个带时间戳的事件并逐字引用画面文字。
最终157秒完成。
时间点对应到具体画面时,整部片子的误差大约只有2秒,而且是在单张GPU上跑完:
只能说,还是那个Qwen,还是不负众望啊。。。
从Thinking推理档位到上下文理解,27B还有这些功能
除了前面这些榜单表现,Qwen3.8-27B这次还有一个很实用的变化。
那就是模型到底要「想多久」,现在可以自己手动调了。
因为27B里内置了个「推理档位」——
模型默认开启Thinking模式,同时支持reasoning_effort调节推理深度,一共分成xhigh、medium和low三档。
- 复杂代码、长程Agent这类任务,可以把档位拉高。
- 简单问答、摘要、轻量任务,则可以降下来,优先换速度和成本。
- 此外Thinking本身也能直接关闭,让模型跳过推理过程直接回答。

此外,在长任务这件事上,还有一个挺实用的功能——Qwen3.8-27B默认开启了preserve_thinking。
简单说,就是Agent前几轮「怎么想的」可以继续留在后面的上下文里。
比如Coding Agent连续改十几个文件,做到后面时还能沿着前面的决策继续走。
这样可以少一点每轮重新捋思路的重复劳动,同时也能更好利用KV Cache。
底层架构如何支撑长上下文
小小的身形,想把长任务稳稳扛住,底层架构也得下点功夫。
说得更具体一点,Qwen3.8-27B总共由64层组成。
其中48层使用的是Gated DeltaNet线性注意力,另外16层则保留了完整Attention。
整体上基本遵循「三层线性注意力+一层完整Attention」这样一套循环节奏。
线性注意力负责降低长序列下的计算和缓存压力。
完整Attention则隔几层做一次更充分的信息交互。
这样带来的最大好处就是——Qwen3.8-27B原生上下文能做到262K Token,还可以继续扩展到100万Token!!!

怎么把模型跑起来
最后说一下大家同样比较关心的问题——怎么把模型跑起来。
其实,非常之简单。
最新已经给模型接上了Transformers、vLLM、SGLang和TokenSpeed。
如果是生产环境或者需要高吞吐,Qwen更推荐SGLang、vLLM这类专门的Serving引擎。
当然,本地玩家则可以更省事一点儿。
Hugging Face也提供量化版本入口了,大家可以直接通过大家熟悉的工具链部署。
换句话说,手里有一张高端消费级显卡或者大内存Mac,基本已经可以开始折腾这只27B了。
开源链接
- [1]https://mp.weixin.qq.com/s/Ttv5cMD5p6DkUQWyoOsqCA
- [2]https://huggingface.co/Qwen/Qwen3.8-27B
- [3]https://www.modelscope.cn/collections/Qwen/Qwen38

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 微软自研AI编程大模型取代Claude 开发者受益
- 时间:2026-08-22
-

- Claude iOS版设置菜单重设计上线,新增记忆文件功能
- 时间:2026-08-21
-

- Claude攻克百年数学猜想,黎曼猜想之后再引关注
- 时间:2026-08-21
-

- 微软意外泄密Claude Mythos万亿参数与训练规模曝光
- 时间:2026-08-21
-

- 专家预测年底实现,Claude Mythos今日跑出3小时6分成绩
- 时间:2026-08-21
-

- AI编程新范式崛起:提示词工程会被取代吗
- 时间:2026-08-21
-

- Bun用Claude Code 9天重写100万行代码后安全吗测试通过率引质疑
- 时间:2026-08-21
-

- 把Claude Code作为可编程基础设施:从提效工作到让系统自动干活
- 时间:2026-08-20
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15