大数据开发必学语言Scala:隐式转换能力强于Java
时间:2026-08-21 | 作者:极客少年 | 阅读:0大数据开发语言scala:源于Ja va,隐式转换秒杀Ja va
前言
在多年的学习路上,我也掌握了几门比较常见的语言,例如Ja va、Python以及前端Vue生态中包含的语言。
很多时候,各种语言相似功能的框架都会被放在一起比较,进而评判语言本身的优劣。
在我的实际学习应用中,我发现每种语言都有自己适合的领域。
- Ja va拥有庞大丰富的后台生态,所以常用来构建后端服务。
- Python轻量且简单易上手,常应用于数据分析、爬虫、机器学习等场景。
- 一些小众语言也会在各自的领域熠熠生辉。
在还没有接触大数据开发之前,我从来没有听说过scala这门语言。
后来在实时开发Spark、Flink领域,官方提供了Ja va、Python和scala三种选择,而我对scala情有独钟。它仿佛天生就是为流数据处理而生。
所以这篇文章,就从scala独有的特性入手,结合一些开发中的小技巧,看看为什么寂寂无名的scala,能在流处理中与Ja va争雄。
隐式转换(implicit)
第一次接触implicit的时候,我的反应是:“啥是隐式转换?”
后来学完之后就悟了:它本质上就是“藏起来的类型转换”。先从类型转换开始入门。
1. 变量隐式转换
假设我定义了一个字符串变量a,如果将a转换成int类型,并需要赋值给一个变量。
在Ja va中,我需要:
String a = "6";
int a_ = Integer.parseInt(a)
在python中,我需要:
a = '6'
a = int(a)
上面两种语言有一个共同点:从string到int,都需要调用方法来做类型转换。
而且Ja va还需要重新创建一个int类型的变量,来接收转换后的数值。
因为Python是个动态类型语言,所以在Python中可以直接使用变量a,来接收转换后的数值。
而Ja va是静态类型语言。在定义变量时,变量类型就已经声明确定了。如果直接将int赋值给String类型的变量a,在类型检查时就会报错。
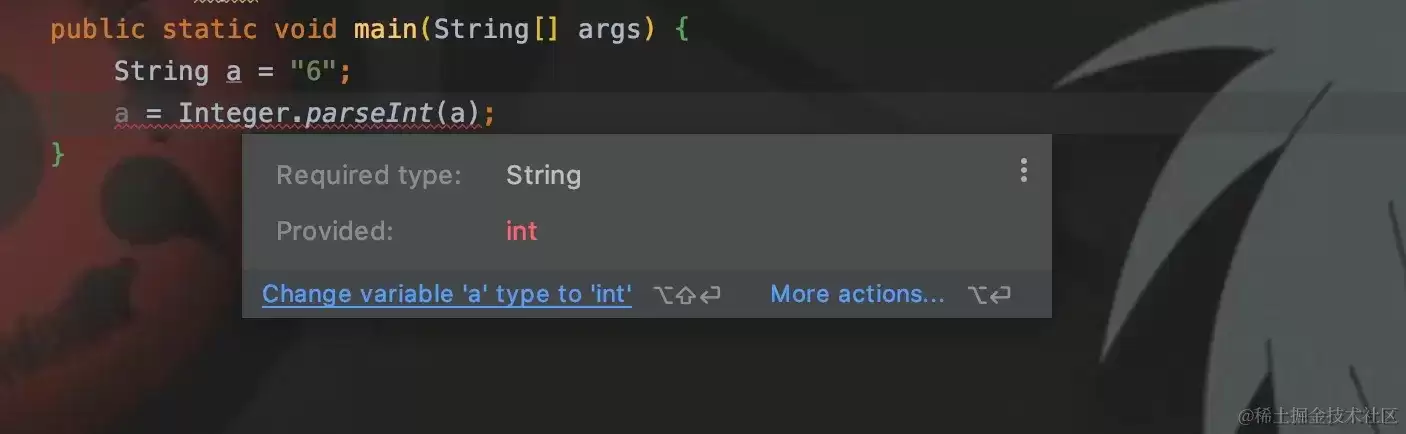
scala也属于静态类型语言。
在scala中用val或var定义变量时,只是在变量定义阶段能省略数据类型,由scala编译器自动声明。所以在上面的示例里,scala和ja va的情况是相同的。
但如果真想达成python那种一个变量有两种类型的动态类型效果,就接着往下看:
var a: Int = "6"
a += 1
print(a)
在这段代码中,我直接将String类型的数值赋值给了int类型的变量。
这看起来比Python更动态,而且scala最后也是转换成Ja va运行,这能不报错?

结果是:编译无问题、运行无报错,String类型的6还变成了int类型,最后输出结果7。
正常情况下,在赋值那一步就应该报错。但有了scala的隐式转换,scala编译器就自动完成了转换。
在上述代码中,我定义了一个隐式转换方法:

使用implicit定义一个方法,方法参数类型就是要被转换的数据类型,方法返回值就是要被赋值目标变量的类型。
当检测到String类型要赋值给Int类型变量时,就会调用这个隐式转换函数,将String类型转换成int。
如果删除了这个隐式转换方法,和Ja va一样会报错。

2. 方法隐式参数
隐式参数,就是在定义方法形参时,在形参名称前面使用implicit修饰。
调用这个方法时,如果你传入了参数,那就是正常的方法调用。
如果没有传入参数,scala会自动寻找邻近的、同类型的、implicit修饰的变量,当做方法参数自动传入。

如图所示:我定义了一个say方法,有一个String类型的参数使用implicit修饰。
使用say("aqi")调用方法时,正常执行。如果我直接写一个say,不加括号,也不传入参数,就会报错。
报错的意思就是:没有发现String类型的隐式参数。这时,我们就在调用say之前,定义一个隐式变量作为参数。
def say(implicit s: String) = println(s)

implicit val a = "aqi aqi"
say
使用implicit修饰了String类型变量a后,直接调用say,scala会自动将a当做参数传入,最后正常输出。

如图,最后say的形参会自动绑定implicit修饰的变量a,并传入say()中输出结果。
scala
既然开胃菜吃完,接着就从scala最简单的语法看起。
定义变量
虽然Scala依赖于JDK,且能引用Ja va类,但是除了字符串要用双引号之外,感觉scala和Ja va没有太大的相似之处。
下面是scala定义变量的样例:
var a = 1
val b = new util.HashMap[String, Int]
val定义常量,var定义变量。
a是一个Int类型,b是一个Ja va的HashMap。
熟悉Ja va的朋友可能会指出:“HashMap后面少加了一个括号!”
在Scala中,如果使用无参构造器,是可以省略掉括号的。
定义函数
scala摒弃了Ja va这种public static void定义函数方式,而是和Python一样使用关键字def。
在此基础上还有进一步优化:返回值不用return。
val a = 1
def aqi() = {
  a
}
print(aqi)
输出结果为1,这里的a就是被aqi这个函数返回的值。
多参数
不仅如此,在定义函数时,还可以将不同参数放在不同括号里:
def add(x:Int)(y: Int): Int = x + y
add(1)(2)
最后输出结果为3。
看到这里可能会疑问:这个花里胡哨的有啥用?后面在进阶用法中会讲到它的妙用。
以函数为参数
在scala的方法定义中,除了使用常见的数据类型作为参数,还可以使用函数作为参数。
例如我定义一个方法:
def say(func: () => Unit) = {
  println("say....")
  func()
}
这里的形参func本身就是一个函数,所以在调用say()时,也要传入一个函数。
val func = () => println("aqi")
say(func)
定义一个func函数变量,然后在调用say()时传入,运行结果如下:

定义类
在scala中,有三种方式定义一个类,分别是:class、object、case class。
class和object通常被定义在一个源文件中,且名称相同。
class是object的伴生类,object是class的伴生对象。
这些概念听起来有些拗口。我在理解这一块的时候,也费了一番功夫。
这里先不管概念,直接从用法来记住它们。
伴生类
先定义一个class:
class aqi {
  def say(word: String) ={
    print(word)
  }
}
按照Ja va的用法,如果想调用say(),我们需要先new aqi()创建对象,再通过.say(xxx)调用方法。
val aqi = new aqi()
aqi.say("hello aqi")
最后输出hello aqi。
But sorry,在scala中虽然可以这样用,但是建议不要这么用。通常更常见的是使用object的方式来创建class。
伴生对象
我们在上面的class文件中,再创建一个同名的object。
// 伴生对象
object aqi {
  def apply(word: String): aqi = {
    val aqi_ = new aqi
    aqi_.say(word)
    aqi_
  }
}
在伴生对象中有个apply函数,这是scala中的语法糖。
通过object创建对象,实际上直接调用的是apply()。

以下面代码为例:
val aqi_ = aqi("hello aqi")
这里的aqi前面没有new,所以引用的是object而不是class。
因为apply需要一个String参数,所以传入一个String。
然后在apply中使用new,创建一个aqi的class对象aqi_,调用say(),并返回aqi_。

从这个样例可以看出,class和object是相互依存的。
- object的apply必须返回一个对象
- class被apply用来创建对象
两者是伴生关系。根据名称翻译,所以class是伴生类,object是伴生对象。
除此之外,object提供apply来创建对象,也同样提供了unapply来结构对象。
同时,object是单例,且只有object才有main()来启动应用。
case class
而case class会自动生成伴生对象,并实现了。
case class Person(name:String, age:Int)
编译之后查看class文件,自动生成了伴生对象MODULE$。
并实现了apply、unapply、equals、hashcode方法,以及实现Ja va的Serializable接口和scala的Product接口。

case class在Spark开发中常用来定义实体类。
进阶用法
在阅读Spark源码的时候,我发现了很多scala很有趣的用法。
这里拿出其中具有代表性的两个:柯里化和贷出模式。
柯里化(currying)
柯里化,指将原来接受两个参数的函数,变成新的接受一个参数的函数的过程。
前面讲过,一个函数的多个形参,可以放在两个括号里。
先从代码看概念:
def func1(x: Int)(y: Int) = x + y
val func2 = func1(1)_
这里定义了一个func1(),x、y有两个参数列表,可以通过func1(1)(2)调用,返回值为3。
柯里化的做法是:先把func1其中一个参数写死,再用占位符_表示另一个参数先不传。
这样返回值就是一个函数值,然后赋值给func2。此时func2就变成了只需要传一个参数的函数。

如图所示,这就是上述柯里化代码的运行结果。
贷出模式(loan pattern)
贷出模式主要涵盖资源的获取、使用及释放。
它常见于文件、数据库连接等资源的管理流程。
在一个方法中,我们定义资源的获取与关闭。这个方法的形参是函数。
在方法内部,我们将获取的连接等资源“贷”给形参函数。
这样在调用该方法并传入函数时,就可以在函数体中直接使用连接进行操作。
而连接的初始化、关闭都在方法中完成,实现统一的资源管控。不理解就直接看代码:
def withFileReader[T](fileName: String)(func: BufferedReader => T): T = {
  val fileReader = new BufferedReader(new FileReader(fileName))
  try {
    // 将Reader对象借给了func形参
    func(fileReader)
  } finally {
    fileReader.close()
  }
}

// 调用withFileReader,使用贷出模式读取文件
val result = withFileReader("aqi.txt") { reader =>
  reader.readLine()
}
这样,在调用withFileReader传入的形参函数体中,我们就可以使用withFileReader中贷出的Reader对象来读取文件。
scala的流开发之旅
在开头提到,在Spark/Flink中,提供了Ja va、Python、scala三种开发语言。
原则上就是你会哪种语言,就用哪种语言开发。
但在刚开始学习spark开发的时候,虽然我已经掌握了Ja va和Python,我还是又学了scala。
原因有二:
- spark源码是scala实现的
- scala符合流处理的设计
下面是Spark官方文档提供的三段代码。
它们做的是同一件事:一个RDD到DataFrame实现SparkSQL计算的代码。
我们无需理解代码逻辑,只看每种代码的开发复杂度和可读性。
Ja va版本
用Ja va来做流处理开发,代码会显得有些繁多。
因为每一个变量都要明确声明数据类型。
/** Ja va Bean class for converting RDD to DataFrame */
public class Ja vaRow implements ja va.io.Serializable {
  private String word;

  public String getWord() {
    return word;
  }
  public void setWord(String word) {
    this.word = word;
  }
}
...
/** DataFrame operations inside your streaming program */

Ja vaDStream words = ...

words.foreachRDD((rdd, time) -> {
  // Get the singleton instance of SparkSession
  SparkSession spark = SparkSession.builder().config(rdd.sparkContext().getConf()).getOrCreate();

  // Convert RDD[String] to RDD[case class] to DataFrame
  Ja vaRDD rowRDD = rdd.map(word -> {
    Ja vaRow record = new Ja vaRow();
    record.setWord(word);
    return record;
  });
  DataFrame wordsDataFrame = spark.createDataFrame(rowRDD, Ja vaRow.class);

  // Creates a temporary view using the DataFrame
  wordsDataFrame.createOrReplaceTempView("words");

  // Do word count on table using SQL and print it
  DataFrame wordCountsDataFrame =
    spark.sql("select word, count(*) as total from words group by word");
  wordCountsDataFrame.show();
});
在RDD到DataFrame的转换中,Ja va还需要定义一个实体类。
Python
Python是流开发中我最不建议的一种,非必要不使用。
Python代码最后还是被转换成Ja va来运行。
# Lazily instantiated global instance of SparkSession
def getSparkSessionInstance(sparkConf):
    if ("sparkSessionSingletonInstance" not in globals()):
        globals()["sparkSessionSingletonInstance"] = SparkSession
            .builder
            .config(conf=sparkConf)
            .getOrCreate()
    return globals()["sparkSessionSingletonInstance"]

...
# DataFrame operations inside your streaming program
words = ... # DStream of strings
def process(time, rdd):
    print("========= %s =========" % str(time))
    try:
        # Get the singleton instance of SparkSession
        spark = getSparkSessionInstance(rdd.context.getConf())
        # Convert RDD[String] to RDD[Row] to DataFrame
        rowRdd = rdd.map(lambda w: Row(word=w))
        wordsDataFrame = spark.createDataFrame(rowRdd)
        # Creates a temporary view using the DataFrame
        wordsDataFrame.createOrReplaceTempView("words")
        # Do word count on table using SQL and print it
        wordCountsDataFrame = spark.sql("select word, count(*) as total from words group by word")
        wordCountsDataFrame.show()
    except:
        pass
words.foreachRDD(process)
代码量少了很多,但是可读性稍微差一点。
scala
最后就是scala,我不说,你自己看!
/** DataFrame operations inside your streaming program */
val words: DStream[String] = ...
words.foreachRDD { rdd =>
  // Get the singleton instance of SparkSession
  val spark = SparkSession.builder.config(rdd.sparkContext.getConf).getOrCreate()
  import spark.implicits._
  // Convert RDD[String] to DataFrame
  val wordsDataFrame = rdd.toDF("word")
  // Create a temporary view
  wordsDataFrame.createOrReplaceTempView("words")
  // Do word count on DataFrame using SQL and print it
  val wordCountsDataFrame =
    spark.sql("select word, count(*) as total from words group by word")
  wordCountsDataFrame.show()
}
整体代码从简洁性和可读性来看,远超Ja va和Python。
虽然它和Ja va一样是静态类型语言,但是RDD转换DataFram的时候,无需定义实体类,直接一个toDF完成。
结语
这就是我个人在使用scala时,总结的一些开发小技巧和比较有意思的用法。
整体来说,scala在大数据流处理开发领域绝对是秒杀Ja va和Python的。
而且scala虽然依赖于Ja va,但是其开发灵活性和代码简洁性是要超过Ja va的。
所以,scala真的是一门比较值得学习的语言。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Scala 下划线 `_` 的常见用法,一次看清它在不同语境里的含义
- 时间:2026-08-25
-

- 从递归练习到 Akka 心跳机制:几段 Scala 常见题目的实现思路
- 时间:2026-08-25
-
- 广立微YAD平台实现头部Fabless与Fab商用落地应用
- 时间:2026-08-21
-

- 星立方学生成绩查询官网入口及成绩查询方法
- 时间:2026-08-21
-
- 星立方学生期末成绩查询官方入口及查询方法
- 时间:2026-08-21
-

- 大数据开发中Scala函数式编程实践与应用指南
- 时间:2026-08-21
-
- Scala Trait使用入门:3分钟快速学会特质用法
- 时间:2026-08-21
-
- 大数据RDD编程实验教程与实训指南
- 时间:2026-08-20
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15