Liquid AI开源LFM2.5混合专家模型,端侧大模型实现突破
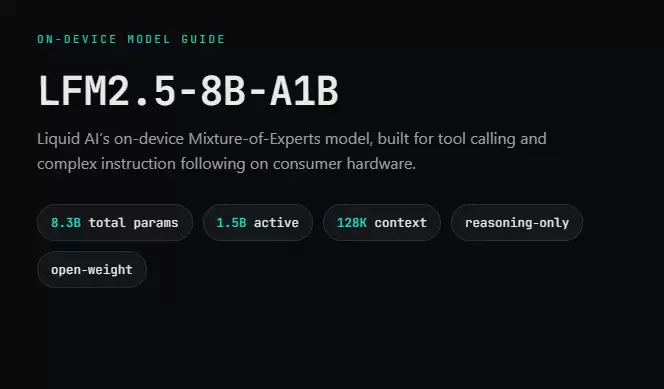
时间:2026-08-21 | 作者:骑光打字机 | 阅读:0人工智能初创公司 Liquid AI 今天正式发布并开源了全新的端侧大模型 LFM2.5-8B-A1B。它的目标很明确:提升消费级硬件上的工具调用和指令遵循体验,同时把计算成本压到极低。
更值得关注的是,它在端侧设备的推理与推理性能上实现了肉眼可见的提升。
架构设计上,它采用了稀疏混合专家(MoE)方案。总参数量 8.3B,但每生成一个 Token 仅激活 1.5B 参数。
这意味着,你的手机、笔记本电脑完全能扛得住。无需依赖云端,也能在本地高效运行。
长文本扩展与推理能力升级
比起前代,LFM2.5 的上下文窗口 从 32K 直接提升到 128K 词元,预训练数据量也从 12T 跃升到 38T。
作为一款纯推理模型,它在输出最终答案前,会先生成显式的思维链。同时,它的词表压缩率很高,处理中文、阿拉伯文等九种语言时效率更优。
如何解决长推理中的常见问题
长推理场景里,逻辑死循环和幻觉问题较为常见。为了解决这些问题,开发团队在训练中引入了两阶段强化学习(RL)。
- 偏好优化:专门处理长链路推理中的“死循环”问题。
- 防幻觉奖励机制:让模型在遇到超出知识库的问题时,学会主动拒绝回答。
这一点尤其关键。
端侧性能强劲与生态全面兼容
性能表现上,LFM2.5 堪称爆发式增长。逻辑推理和反幻觉基准测试得分大幅超过前代,甚至在指令遵循上能媲美参数更大的模型。
工具调用方面,模型默认输出高效的 Python 函数调用,也支持在系统提示词里无缝切换为 JSON 格式。
首发即获主流生态支持
发布首日,LFM2.5 就获得了主流推理生态的全面支持。
- llama.cpp
- MLX
- vLLM
- SGLang
硬件实测数据也很扎实。在 M5 Max 芯片上,解码速度达到每秒 253 字节;手机端也能跑到每秒约 30 字节。
兼顾端侧运行的私密性与高效率,这回它做到了。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- 微软或将在Build大会发布自研代码模型与多场景AI模型
- 时间:2026-08-21
-
- 小米MiMo-V2-Pro与Omni将于2026年6月下线并切换V2.5系列
- 时间:2026-08-21
-
- Liquid AI开源LFM2.5混合专家模型,端侧大模型实现突破
- 时间:2026-08-21
-

- 科技圈新变局:MiniMax企业客户破百万,创想三维冲刺港股上市
- 时间:2026-08-21
-
- Mistral AI CEO称自研AI芯片是迟早的事布局未来发展
- 时间:2026-08-21
-
- 全球首个事件级预测具身智能世界模型发布解析
- 时间:2026-08-21
-

- 三菱日联金融集团携手OpenAI推动全员AI化转型
- 时间:2026-08-21
-

- Glean年营收突破3亿美元 企业级AI搜索增长三倍
- 时间:2026-08-21
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15