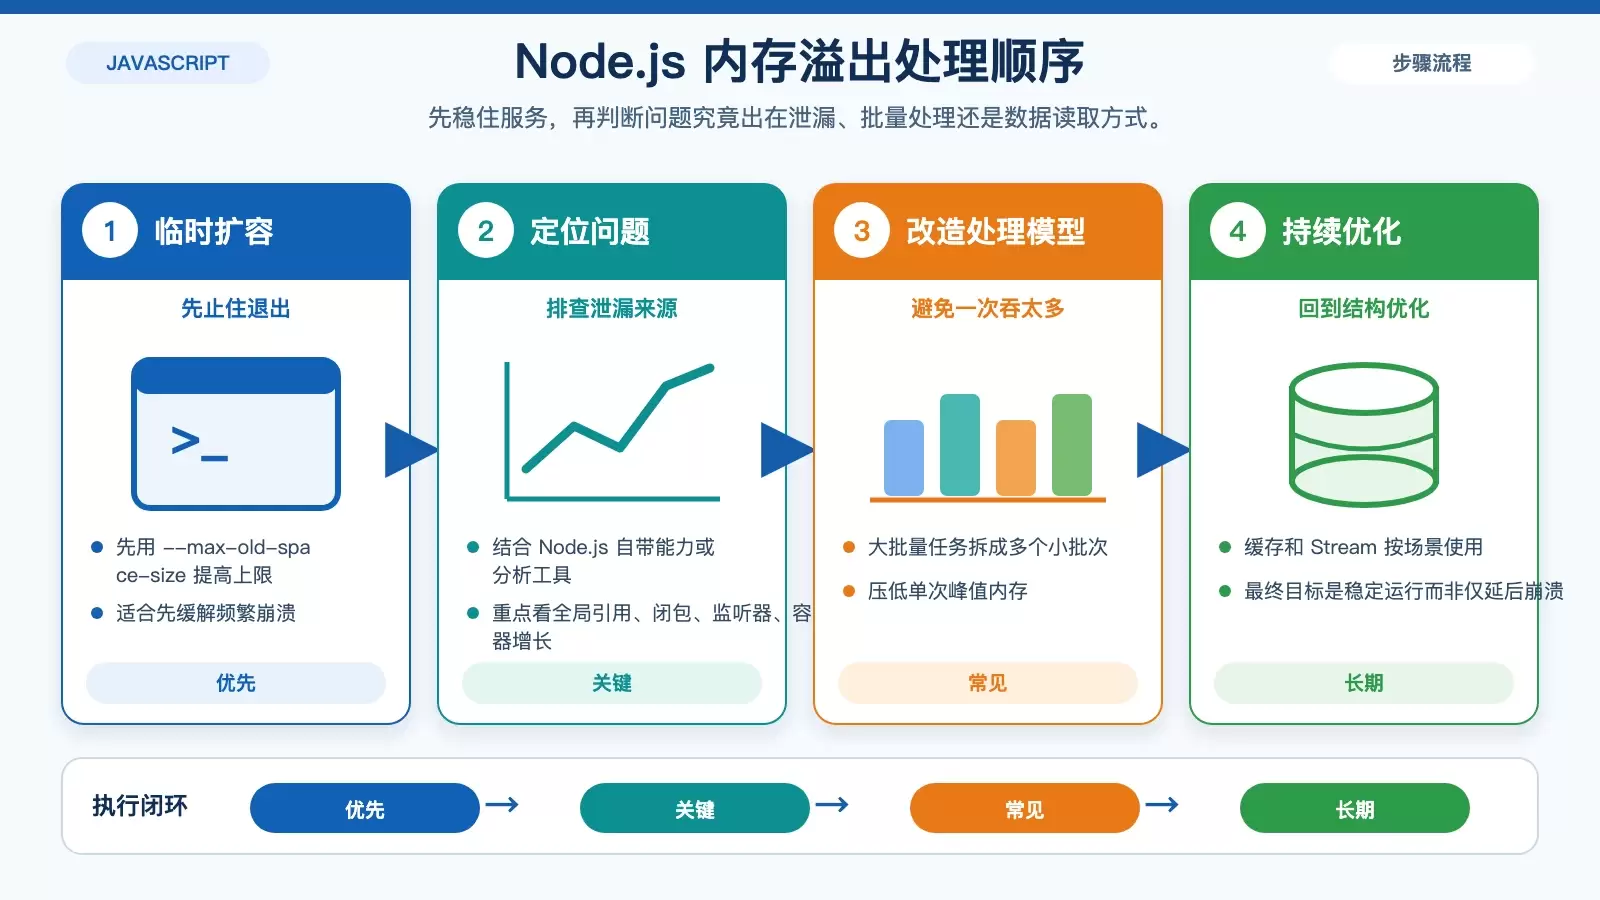
在 CentOS 上部署 Node.js 服务时,内存溢出往往不是单一问题:有时是默认堆内存不够,有时是代码泄漏、批量任务过重,或者文件与数据处理方式本身就不合理。更稳妥的处理思路,是先用参数和系统配置缓解崩溃风险,再回到应用层定位问题来源,最后根据业务负载选择批处理、缓存或流式方案。
下面按实际排查顺序展开,既保留可直接执行的命令,也说明每种方法适合解决什么问题、有哪些边界。
先提高 Node.js 可用内存上限
如果应用是在运行一段时间后因为堆内存不足退出,最直接的临时措施,是在启动时通过 --max-old-space-size 调高 Node.js 的内存上限。
node --max-old-space-size=4096 app.js这里的 4096 表示把 Old Space 调整到 4GB。这个办法适合先止住服务频繁退出的问题,但它本身并不会消除内存泄漏,也不能替代后续优化。如果应用只是“延后崩溃”,说明问题通常还在代码或数据处理路径上。
先查是不是内存泄漏或异常占用
很多 Node.js 内存溢出并不是内存太小,而是对象没有按预期释放,或者某段逻辑一次性吞入了过多数据。排查时可以优先借助 Node.js 自带能力,或者使用 heapdump、clinic 这类分析工具观察堆变化。
排查重点通常包括:
- 是否存在长期持有的全局引用。
- 闭包是否保留了本该释放的变量。
- 定时器、事件监听、连接对象是否在不再使用后及时清理。
- 某些数组、Map、缓存容器是否只增不减。
如果只做内存扩容而不处理泄漏,服务负载一上来,问题仍然会重复出现。对生产环境来说,这一步通常比单纯调大参数更关键。
大任务改成分批处理
如果业务里存在一次处理几十万条数据、一次性拼装大对象、或集中跑长列表计算的场景,内存压力很容易瞬间拉满。相比把所有数据一次读入内存,拆成多个小批次处理更稳妥。
分批处理的核心价值在于把单次峰值内存压下来,让垃圾回收有机会及时回收中间对象。对于导入、导出、批量统计、消息消费等任务,这种改法通常比单纯加机器资源更有效。
哪些场景适合优先拆批
- 批量导入数据库记录。
- 一次遍历超大结果集。
- 生成大报表或聚合统计结果。
- 批量调用外部接口并汇总结果。
如果拆批后内存曲线明显平稳,基本可以确认瓶颈在处理模型,而不是简单的系统内存不足。
缓存和流式处理要配合业务使用
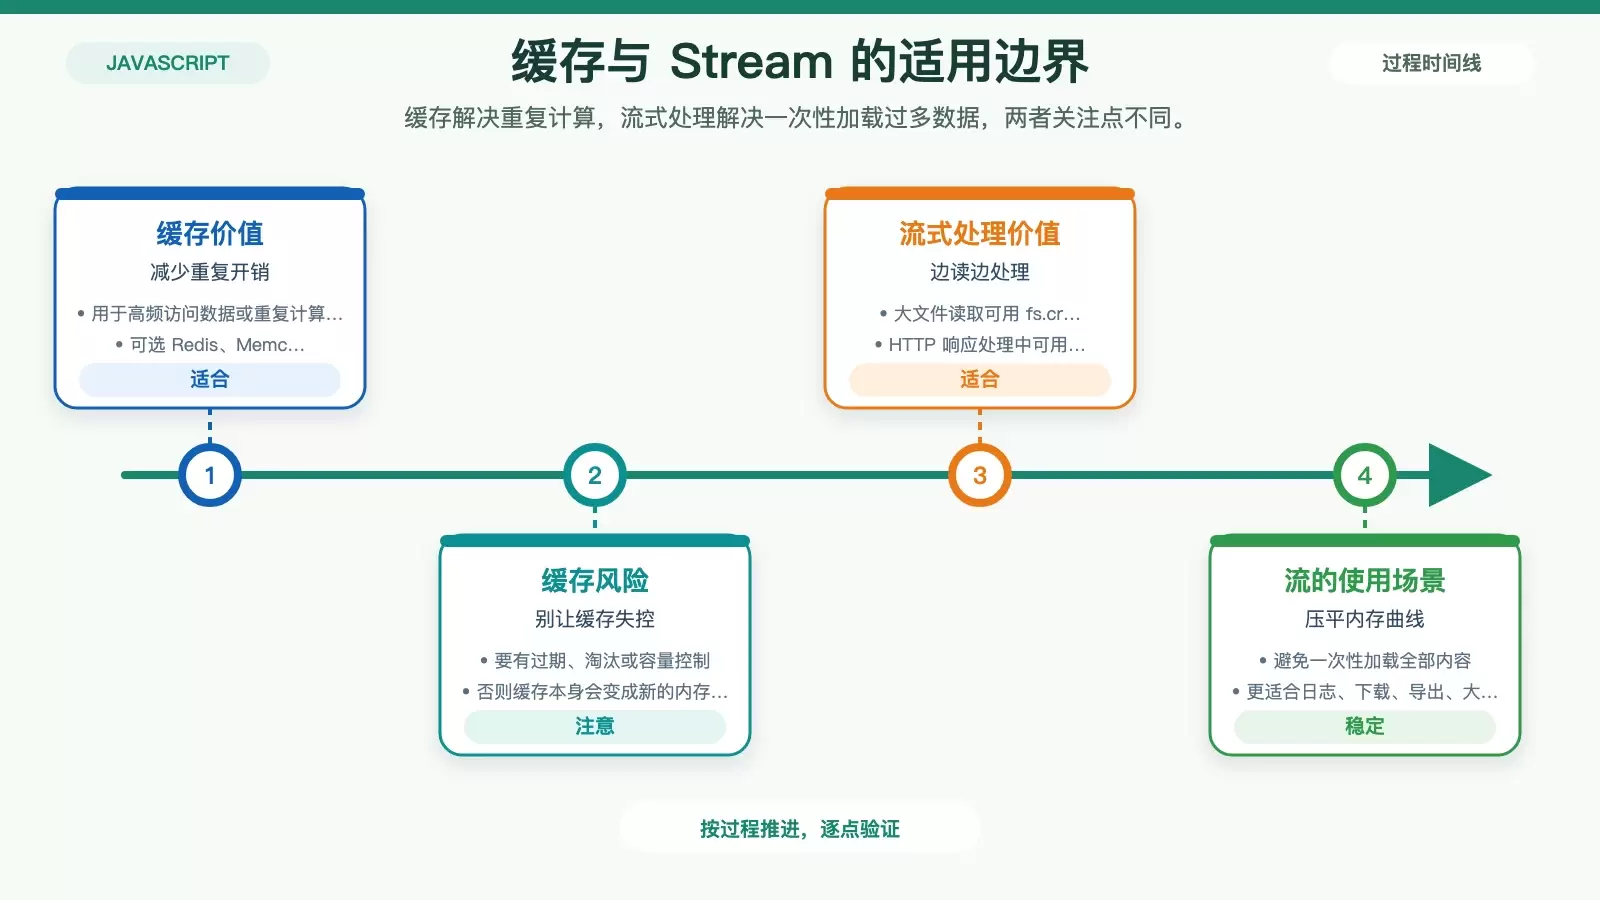
在 Node.js 服务里,缓存和流机制都能降低内存压力,但适用方向不同:缓存更适合减少重复计算与重复查询,流式处理更适合避免一次性加载大块数据。
缓存能省计算,但也可能反过来吃掉内存
对于高频访问的数据或重复计算结果,可以使用 Redis、Memcached,或者在进程内通过 Map、WeakMap 做简单缓存。这样能减少重复开销,缩短响应链路。
但缓存不是越多越好。没有淘汰策略、过期机制或容量控制的缓存,很容易从“优化手段”变成新的内存负担。特别是在进程内缓存场景里,这一点要格外注意。
处理大文件和大结果集时尽量用 Stream
如果应用要读取大文件、传输 HTTP 响应,或者逐步消费大量数据库记录,不要一次性把全部内容加载到内存。更合理的方式是使用 Node.js 的流式处理能力,让数据边读边处理。
常见写法包括:
- 文件读取使用
fs.createReadStream - HTTP 响应处理中使用
res.pipe()
这种方式的优势是内存占用更稳定,尤其适合日志处理、文件传输、导出下载和大体量数据中转场景。
物理内存不足时,可在 CentOS 增加交换空间
如果确认业务高峰下物理内存确实偏紧,可以在 CentOS 上增加交换空间,给系统留出一定缓冲。需要注意的是,Swap 速度明显慢于内存,它更像是避免进程直接崩溃的兜底手段,而不是性能优化方案。
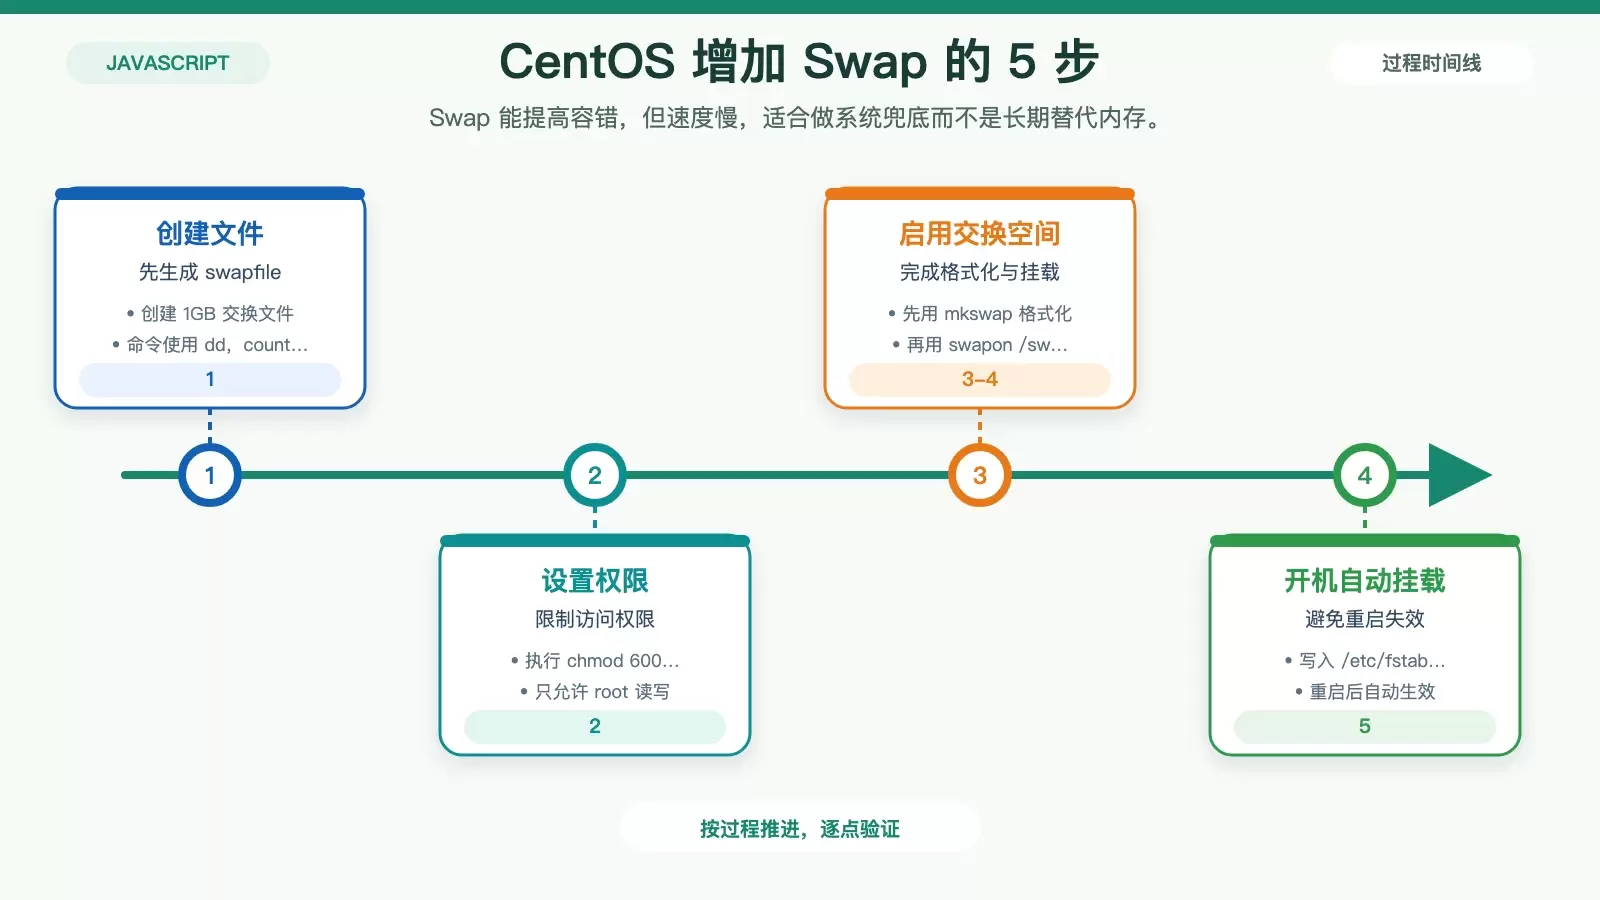
下面是一组完整步骤。
1. 创建 1GB 交换文件
sudo dd if=/dev/zero of=/swapfile bs=1M count=10242. 设置文件权限
sudo chmod 600 /swapfile3. 格式化为交换空间
sudo mkswap /swapfile4. 启用交换空间
sudo swapon /swapfile5. 写入 /etc/fstab 以便开机自动生效
echo '/swapfile swap swap defaults 0 0' | sudo tee -a /etc/fstab如果只是偶发性内存尖峰,这种配置能提高容错空间;但如果服务长期依赖 Swap 才能运行,通常说明应用层或实例规格仍需继续调整。
老版本 Node.js 也可能放大内存问题
如果当前环境还停留在较老版本,例如 Node 10 或 Node 12,内存管理和垃圾回收表现可能不如新版本。升级到最新的 LTS 版本,通常能获得更稳定的运行表现和更好的性能。
不过升级前要先验证依赖兼容性,尤其是原生模块、构建工具链和旧项目框架版本,避免把内存问题换成运行时兼容问题。
结论:先止损,再回到代码层解决根因
对 CentOS 上的 Node.js 内存溢出问题来说,调大 --max-old-space-size 和增加 Swap 都只能算缓解手段,真正决定效果的还是代码是否存在泄漏、任务是否拆分合理,以及大数据处理是否采用了缓存与流式机制。
更实用的处理顺序通常是:先保障服务不立刻崩溃,再定位泄漏或高占用逻辑,最后结合业务特征做结构性优化。这样处理,才能把问题从“暂时跑起来”推进到“长期稳定运行”。



