很多 Node.js 服务出问题,并不是单点配置失误,而是系统、依赖、网络和应用层一起留下了缺口。要把 Linux 下的 Node.js 环境配稳,比较实用的做法不是追求某一个“万能安全项”,而是按攻击面从下往上收口:先压缩系统暴露面,再控制版本和依赖,随后补上网络与代码层防护,最后用监控和应急机制兜底。看完这篇,你可以快速判断一台服务器到底缺的是底层加固、上线规范,还是运行期监控。
系统层先收口:减少暴露面和弱口令风险
Linux 下的 Node.js 安全配置,第一步通常不是改业务代码,而是先处理系统底层。因为只要主机本身暴露过多端口、保留无用账户,或者内核防护缺失,后续应用层措施很容易被绕开。
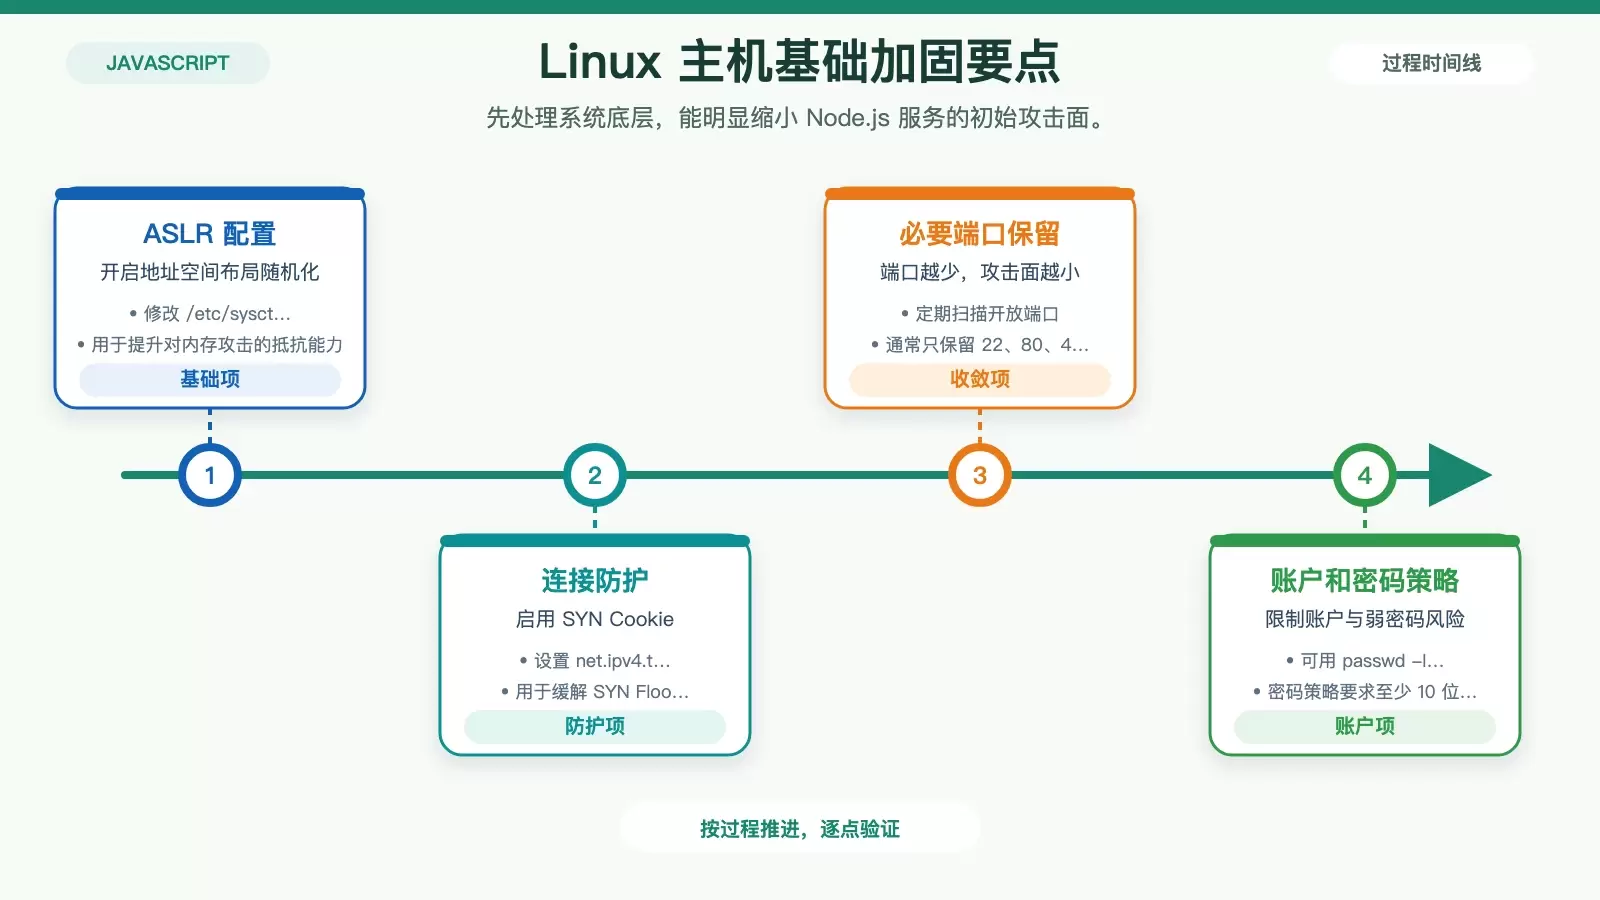
内核参数和开放端口要先做减法
可以通过修改 /etc/sysctl.conf 强化内核防护。文中提到的两项属于常见基础配置:
kernel.randomize_va_space=2:开启地址空间布局随机化,用来提升对内存攻击的抵抗能力。net.ipv4.tcp_syncookies=1:启用 SYN Cookie,主要用于缓解 SYN Flood 这类大量无效连接请求。
同时要定期检查服务器开放端口,只保留业务真正需要的服务。常见保留项通常包括 SSH 的 22、HTTP 的 80、HTTPS 的 443。端口越少,攻击面越小,这一步往往比堆更多安全软件更直接。
账户精简和密码策略不能只做表面功夫
系统账户方面,除了必要账户之外,建议锁定不需要使用的用户。可以直接使用 passwd -l 锁定非必要账户,降低被横向利用的风险。
密码策略也要落到系统配置上,而不是只靠口头要求。比如在 /etc/login.defs 中设置密码有效期:
PASS_MAX_DAYS 90PASS_MIN_DAYS 1
再在 /etc/pam.d/system-auth 中加入:
password required pam_cracklib.so这样可以要求密码包含数字、大小写字母、特殊字符,且长度至少 10 位。对线上主机来说,这类规则属于基础门槛,而不是可选项。
Node.js 版本和依赖管理,重点是持续更新
很多服务器的实际风险并不来自框架本身,而是来自“能跑就不动”的旧版本环境。Node.js 运行时和依赖包都需要持续更新,否则漏洞会随着时间积累。
安装 Node.js 时,尽量避开系统自带旧版本
文中推荐使用 NodeSource 存储库或 nvm(Node Version Manager)安装 Node.js,这比直接使用发行版自带的旧包更稳妥。例如可以使用:
curl -sL https://deb.nodesource.com/setup_20.x | sudo -E bash -如果使用 nvm,则可以定期执行:
nvm install --lts更新到最新稳定版。这样做的核心价值不只是“用新版本”,而是及时获得官方已经修复的已知漏洞补丁。
依赖扫描和运行权限,要一起纳入日常流程
依赖安全扫描应该成为日常维护动作。可以先用 npm 自带工具检查基础风险:
npm audit如果需要更细的漏洞报告,也可以接入 Snyk 这类第三方工具。与此同时,别忽略依赖是否已经长期过时:
npm outdated这个命令可以帮助你确认哪些包已经落后,是否需要更新到更安全的版本。
另一个经常被忽视的问题是进程权限。Node.js 进程不要用 root 权限运行,像下面这种方式就应该避免:
sudo npm start更合理的是使用普通权限运行,例如:
npm start这样即使应用被利用,攻击者能够获得的系统权限也更有限。
网络层防护,要同时处理入口和请求内容
系统和运行时安全做好之后,下一层就是网络入口。这里既包括谁能访问你的服务,也包括访问进来之后,应用如何处理请求内容。
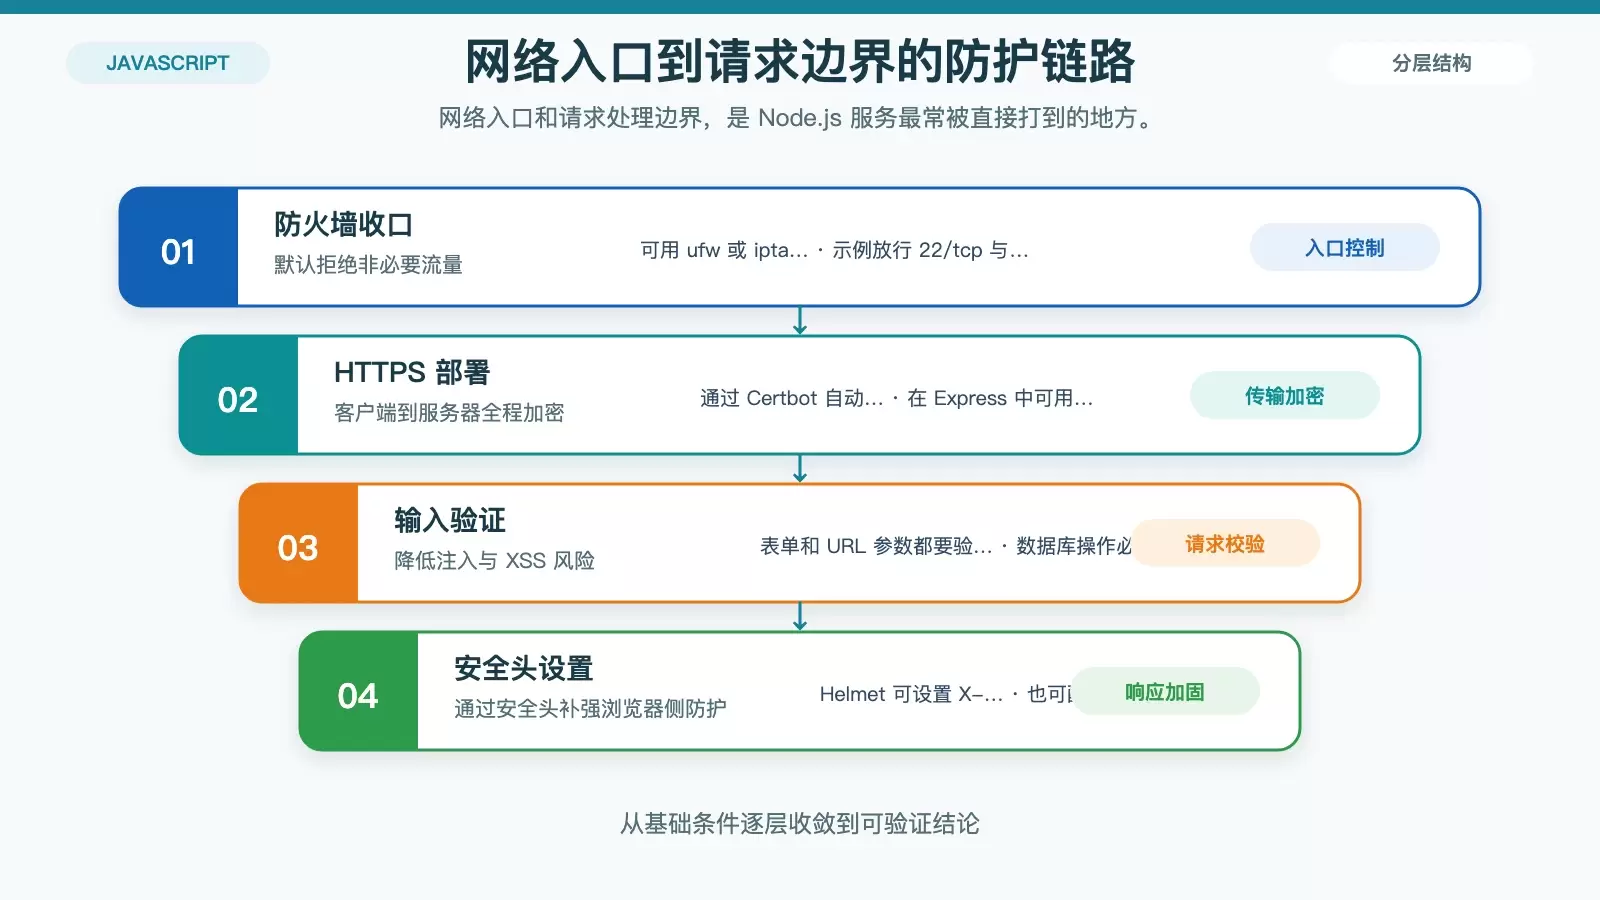
只开放必要端口,并默认走 HTTPS
防火墙建议使用 ufw(Ubuntu 常见方案)或 iptables 来限制访问范围,只开放必要端口。例如:
sudo ufw allow 22/tcp
sudo ufw allow 443/tcp
其余流量默认拒绝,这样可以把很多无关探测和错误暴露挡在外面。
传输加密方面,文中建议使用 Certbot 申请和自动更新 Let’s Encrypt 的 SSL/TLS 证书,并在应用中启用 HTTPS,例如在 Express 里通过 https.createServer 提供加密连接。对于登录、支付、后台接口或任何涉及身份信息的业务,这不是增强项,而是默认项。
输入校验和安全头,是最容易漏掉的应用边界
所有用户输入,包括表单、URL 参数等,都应该做严格验证和清理。可以借助 express-validator 一类库统一处理输入规则,避免把校验逻辑散落在各个路由里。
涉及数据库操作时,参数化查询是硬要求,用来降低 SQL 注入风险;前端输出相关内容时,也要防范 XSS(跨站脚本)攻击。
除了输入验证,HTTP 安全头也值得一次性配置完整。可以使用 Helmet 中间件设置这些常见响应头:
X-Frame-Options: DENY:防止点击劫持。X-XSS-Protection: 1; mode=block:启用浏览器 XSS 过滤器。Content-Security-Policy: default-src 'self':限制资源加载来源。
这些头部配置虽然不复杂,但对减少浏览器侧攻击面很有效。
代码与应用层安全,重点不是“高级”,而是别留明显入口
真正进入业务层后,最常见的问题往往不是复杂漏洞,而是敏感信息硬编码、危险函数滥用,以及认证授权设计过于松散。
敏感信息放环境变量里,危险函数要直接禁用
数据库密码、API 密钥这类敏感信息,应该通过环境变量管理,而不是直接写在代码仓库里。常见做法是用 dotenv 加载 .env 文件,并把该文件加入 .gitignore,代码中通过下面这种方式读取:
process.env.MY_SECRET_KEY这样至少可以避免密钥跟随代码一同泄露。
此外,像 eval()、new Function() 这类高危函数,本身就容易引入代码注入风险。可以用 ESLint 的 no-eval 规则做静态约束,尽量在开发阶段就把这类问题拦下来。
认证、授权和限流,是面向线上攻击的最后一道闸门
认证机制建议采用更成熟的方案,例如 OAuth 2.0 或 JWT,而不是依赖简单弱口令。权限控制上,基于角色的访问控制(RBAC)更适合多数后台和 API 服务,例如:
- Admin 可以访问全部接口
- User 只能访问自身数据
在此基础上,再加上请求限流,才能更完整地应对撞库、暴力尝试和 DoS(拒绝服务)一类攻击。文中给出的做法是使用 express-rate-limit,例如把单个来源限制为每分钟最多 60 次请求。
监控与应急响应,决定你能不能在出事后稳住局面
前面的措施主要是在预防问题,但线上服务不可能完全不出异常。真正决定恢复速度的,往往是日志、监控和应急预案是否提前准备好。
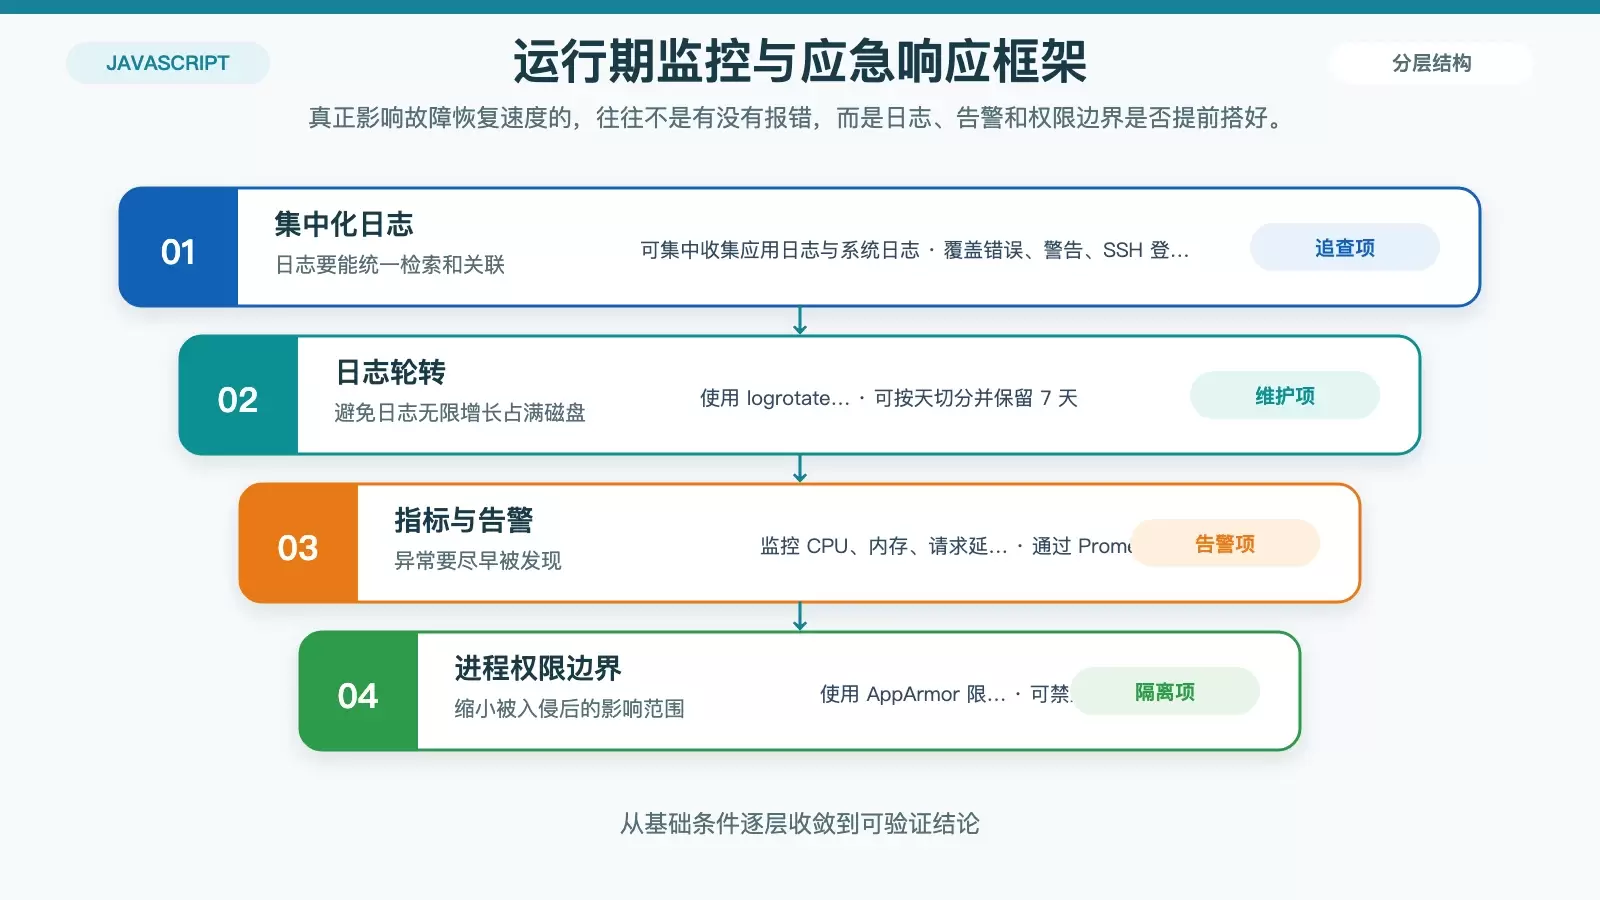
日志、指标和告警要能串起来看
建议使用集中化日志架构,例如 ELK Stack 或 Fluentd,统一收集应用日志和系统日志。前者可以关注错误、警告,后者则要覆盖 SSH 登录、进程异常等关键事件。
日志文件本身也需要维护,避免无限增长占满磁盘。文中提到的做法是借助 logrotate 定期轮转,例如每天生成新日志文件,并保留 7 天。
监控指标方面,至少要覆盖 CPU 使用率、内存占用、请求延迟等核心数据,并配合 Prometheus+Alertmanager 设置异常告警。这样才能在故障扩大前尽快发现异常行为。
应急预案和安全工具,要在事故发生前准备好
安全事件响应不能只靠临场判断。数据泄露、服务中断、异常登录这类场景,都应该有明确处理流程,并定期演练,确保团队知道谁来判断、谁来止损、谁来恢复。
在工具层面,可以加入静态安全分析工具,比如 NodeJsScan,用来识别潜在漏洞,包括 SQL 注入和 XSS 风险。对于主机权限边界,还可以配置 AppArmor 这类 Linux 强制访问控制模块,限制 Node.js 进程访问敏感路径,例如禁止访问 /etc/shadow,把攻击影响范围压到更小。
上线前可以重点检查这几件事
如果你想把这篇内容快速转成一份可执行的检查单,至少要确认以下几类问题:
- 系统层是否已经加固内核参数、精简端口和账户。
- Node.js 是否来自 NodeSource 或
nvm,并保持稳定更新。 - 依赖是否定期执行
npm audit和npm outdated。 - 是否只开放必要端口,并启用了 HTTPS。
- 输入校验、安全头、环境变量、RBAC、限流是否全部落地。
- 日志、监控、告警、应急预案和 AppArmor 是否已经准备好。
对 Linux 上的 Node.js 服务来说,安全配置从来不是“一次设置,长期无忧”。真正有效的方式,是把这些要求固定进部署流程、巡检流程和日常开发规范里。


