在 CentOS 环境里写 C++,容器选型看起来像基础题,实际却很容易在性能和代码复杂度上拉开差距。很多问题并不是“语法不会”,而是数据该怎么放、后续怎么取、插入删除会不会拖慢整段逻辑。本文按常见使用场景把 STL 容器重新梳理一遍,你可以先看自己的访问模式、插入删除位置、是否需要有序以及对内存是否敏感,再把范围快速缩小到合适的几类容器。
先用四个问题缩小选择范围
在具体挑选容器前,先判断下面四件事:
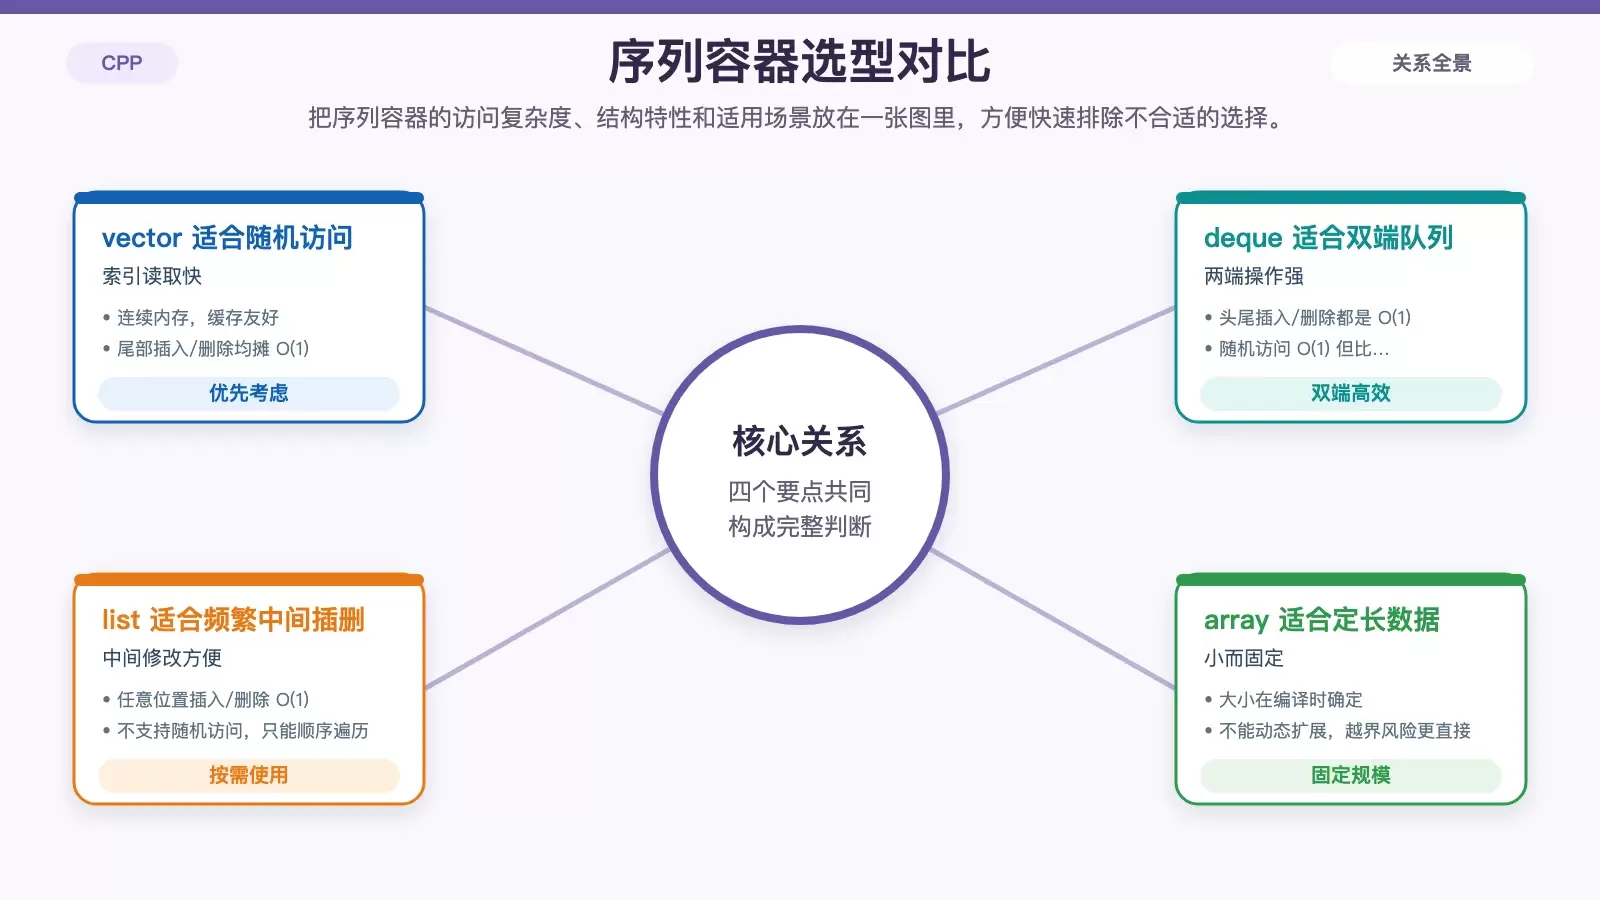
- 是否需要随机访问:如果经常通过下标直接取元素,优先考虑
std::vector或std::array。 - 插入和删除主要发生在哪:尾部操作多,通常偏向
std::vector;两端都要高效处理,通常选std::deque;中间频繁改动才值得考虑std::list。 - 数据是否必须保持有序:需要按键排序或范围查询,考虑
std::map、std::set;不要求顺序但要快查找,则看std::unordered_map、std::unordered_set。 - 是否在意内存和缓存友好性:连续内存通常更有利于遍历性能,链表和哈希表则会带来额外结构开销。
这四个维度基本就能框住大多数实际选择。
序列容器怎么选:先看访问方式和修改位置
为什么大多数场景先看 std::vector
std::vector 本质上是动态数组,特点很直接:连续内存、随机访问 O(1),尾部插入和删除均摊也是 O(1)。扩容时通常按 2 倍增长,这一步会重新分配内存并拷贝已有元素。
它最适合两类场景:
- 需要频繁通过索引访问元素,例如日志记录后快速按位置读取某条数据。
- 主要在尾部追加数据,例如一些只依赖尾部操作的栈式或缓冲区场景。
要避开的地方也很明确:如果你要在头部或中间频繁插入、删除元素,vector 会触发大量元素移动,时间复杂度变成 O(n),性能通常会明显下滑。
什么时候该换成 std::deque
std::deque 是双端队列,由多个小数组组成,逻辑上连续,但物理上不是一整段连续内存。它在头部和尾部插入、删除都是 O(1),随机访问同样是 O(1),只是因为需要定位分段,通常会比 vector 略慢。
它适合下面这些情况:
- 两端都需要高效操作,例如滑动窗口。
- 需要队列结构,尤其是 BFS 这类头尾都有出入队操作的场景。
- 既想保留随机访问能力,又不希望头部操作像
vector那样代价太高。
但如果你经常在中间插入或删除,deque 仍然是 O(n);同时它的内存开销通常也会比 vector 更高,因为还要维护分段信息。
std::list 适合什么问题,为什么别滥用
std::list 是双向链表,非连续内存,任意位置插入和删除都是 O(1),但不支持随机访问,只能顺序遍历。
它真正有价值的场景,是你的核心需求就是频繁在中间改动结构,例如:
- 链表模型本身就是业务结构的一部分。
- 撤销操作栈或可快速重连节点的结构。
- 游戏中需要动态调整的技能链、动作链。
问题在于,list 的代价也非常明显:缓存局部性差、遍历效率通常远低于 vector 和 deque,每个节点还要额外保存前后指针,内存开销也更大。换句话说,只有在“中间频繁插删”确实是主要矛盾时,list 才值得上场。
固定大小数据为什么用 std::array
std::array 是固定大小数组,大小在编译时确定,不能动态扩展,随机访问为 O(1)。
它适合元素数量明确且长期不变的场景,例如:
- RGB 颜色值这类固定 3 个元素的数据。
- 矩阵运算中的固定维度数组。
- 对栈上分配和简单结构有明确需求的小型数据块。
它的限制也同样直接:容量不可变,超出范围会越界,因此不适合动态增长的数据集合。
需要有序结果时,优先看关联容器
std::map:有序键值存储的常用选择
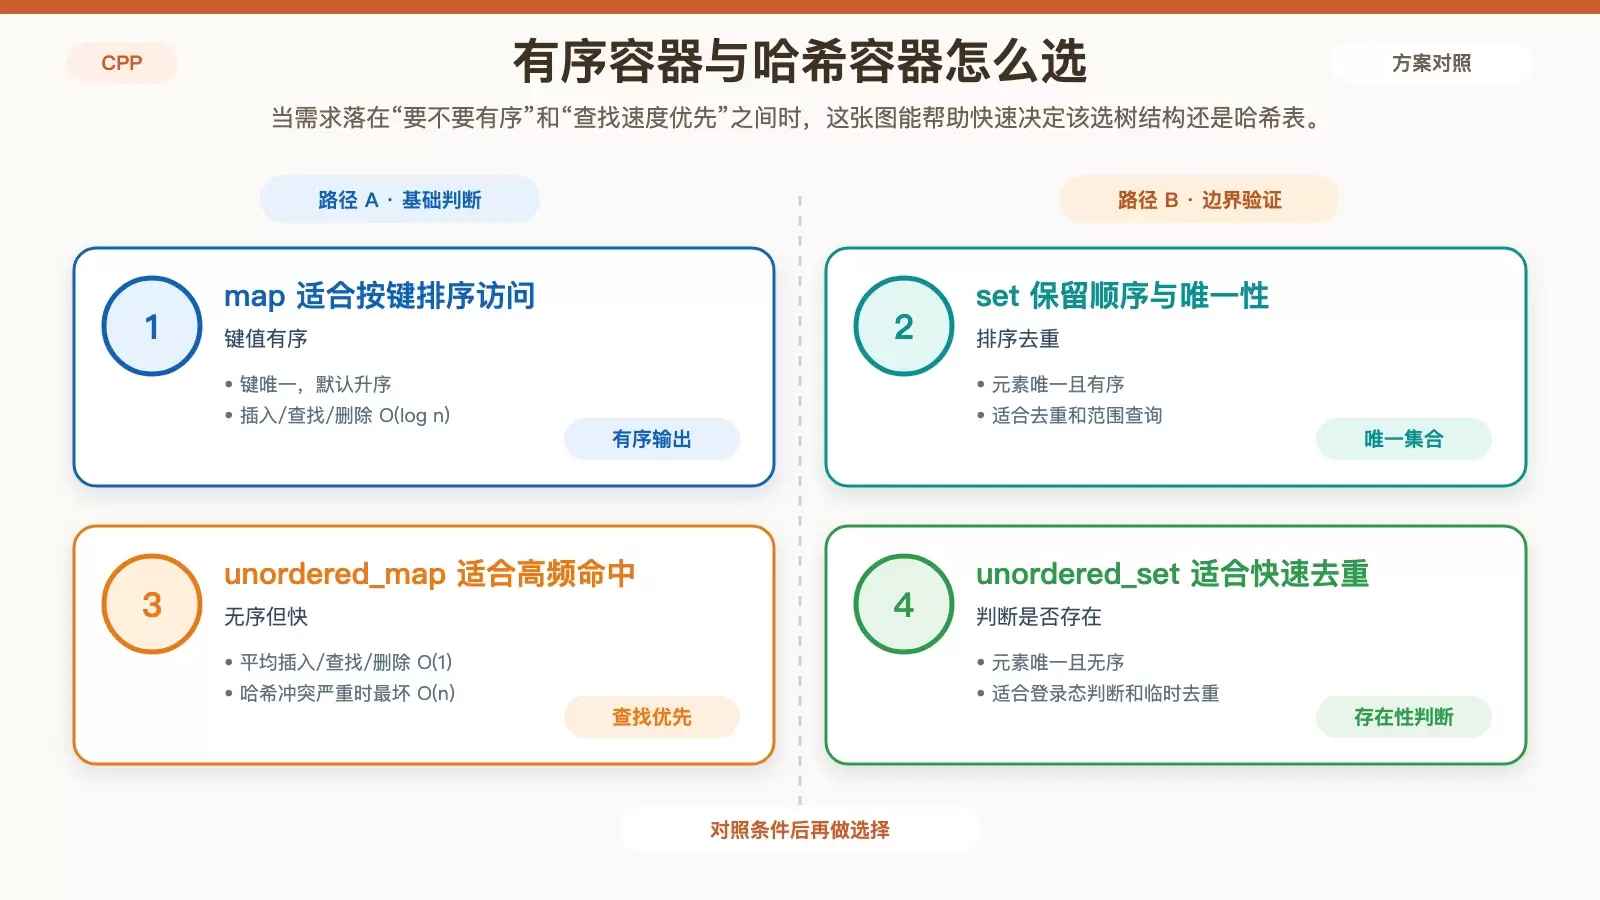
std::map 通常基于红黑树实现,存储键值对,键唯一且默认按升序排列,插入、查找、删除的复杂度都是 O(log n)。
适合它的典型场景包括:
- 既要按键访问,又要保持输出有序。
- 统计单词出现次数后按字母顺序输出。
- 电话簿、配置表这类需要按键排序展示的数据。
要注意两点:一是它的内存开销通常高于线性容器,因为要维护树结构;二是键不能重复,如果业务允许同一个键对应多个值,就该考虑 multimap。
std::set:去重之外还能做有序查询
std::set 同样通常基于红黑树实现,只存元素本身,元素唯一且有序,插入、查找、删除也是 O(log n)。
它不只是“去重容器”,更适合这类任务:
- 需要存储唯一元素并维持排序。
- 范围查询。
- 例如保存用户 ID,并同时确保唯一性和可排序性。
如果你只关心唯一性,不关心顺序,那 set 往往不是效率最优的选择,后面应该转向无序容器。
不要求有序时,无序容器通常更快
std::unordered_map:优先解决查找速度
std::unordered_map 基于哈希表实现,存储键值对,键无序,平均插入、查找、删除复杂度是 O(1),最坏情况下会退化到 O(n),例如哈希冲突严重时。
它适合:
- 需要快速查找和插入,但不要求键排序的业务。
- 缓存系统。
- 数据库索引或高频命中查询场景。
实际使用时要记住,性能高度依赖哈希函数质量;冲突一多,优势会被削弱。另外,它的内存开销通常也会高于 map 中单纯的键值存储部分,因为还要维护哈希桶。
std::unordered_set:高频存在性判断更合适
std::unordered_set 也是哈希表结构,只存元素,元素唯一且无序,平均插入、查找、删除复杂度为 O(1)。
常见应用包括:
- 快速判断某个元素是否已存在。
- 登录态判断,例如某用户是否已登录。
- 临时数据去重。
它的限制与 unordered_map 类似:元素不能重复,哈希冲突会影响实际性能表现。
只需要特定接口时,用容器适配器更直接
什么时候直接用 std::stack
std::stack 是后进先出(LIFO)结构,默认基于 deque,也可以基于 vector 或 list 实现。它只暴露有限接口,例如 push、pop、top。
适合场景包括:
- 函数调用栈。
- 括号匹配。
- 任何只关心“最后进入的元素最先处理”的逻辑。
它不能直接访问中间元素,底层容器需要支持 push_back 和 pop_back。
先进先出就交给 std::queue
std::queue 是先进先出(FIFO)结构,默认基于 deque,提供 push、pop、front、back 等接口。
适合:
- 任务调度。
- 消息队列的简化模型。
- 任何严格按进入顺序消费元素的逻辑。
它同样不支持直接访问中间元素,底层容器需要支持 push_back 和 pop_front。
有优先级时选 std::priority_queue
std::priority_queue 基于 vector 实现,默认是大顶堆,也就是最大元素优先位于顶部。它的插入复杂度为 O(log n),取顶部元素为 O(1)。
它适合:
- Dijkstra 算法。
- A* 搜索。
- 任务优先级调度。
如果业务需要小顶堆,可以通过自定义比较函数调整;但它仍然只适合访问顶部元素,不适合直接查看任意位置的数据。
一张决策表,快速落到具体容器
如果你在项目里需要尽快做判断,可以按下面的思路落地:
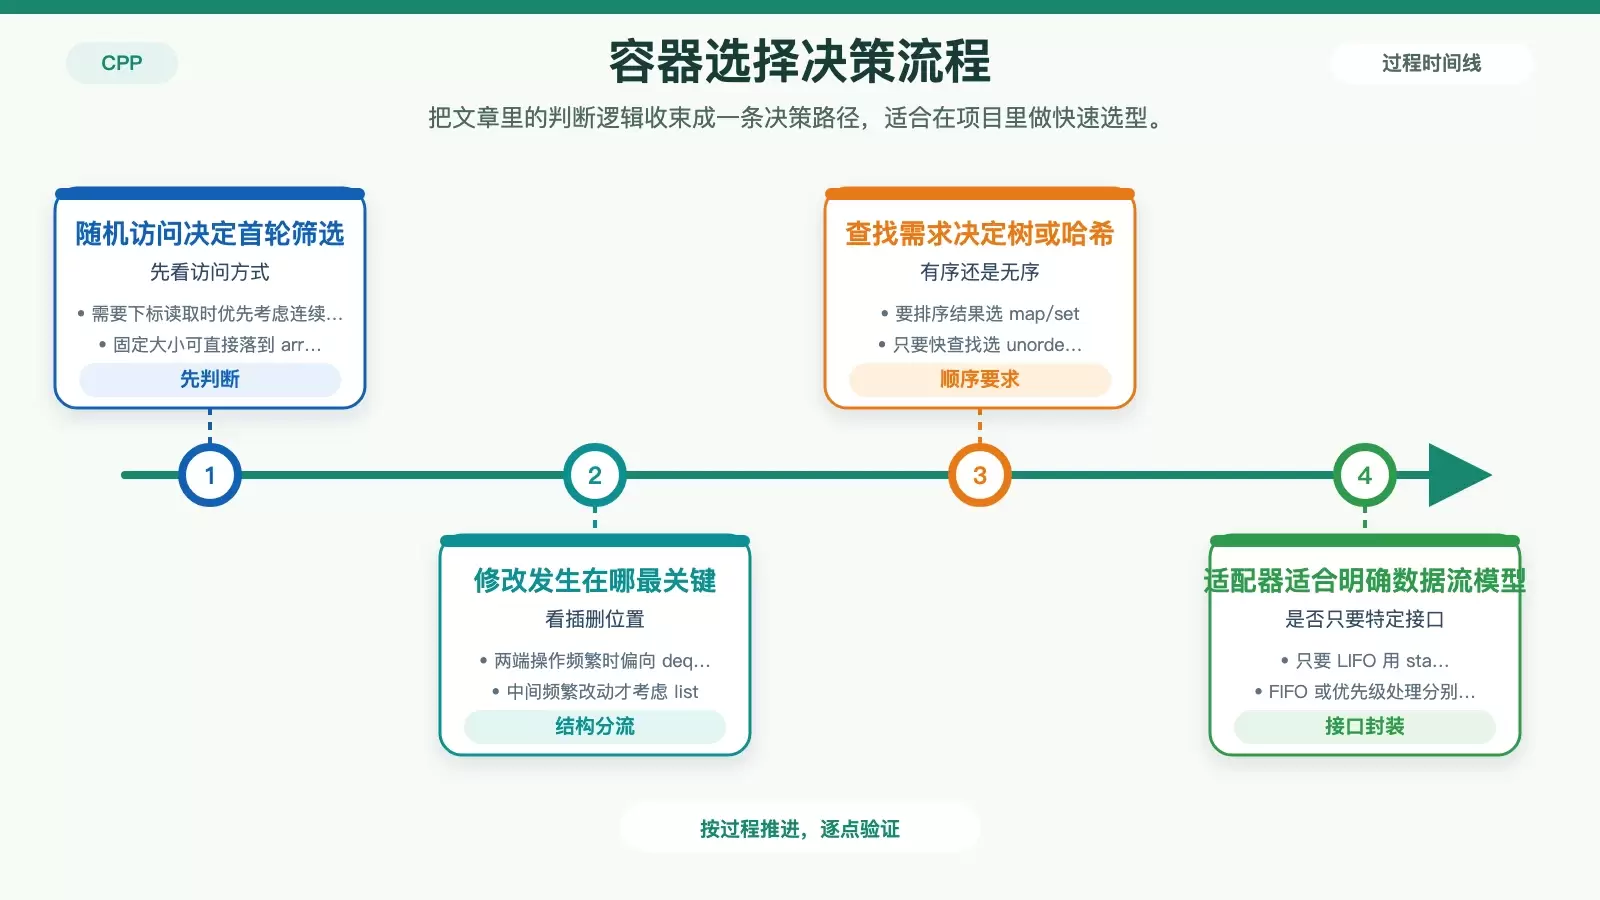
- 需要高效随机访问:优先
std::vector;如果元素数量固定,选std::array。 - 两端都要频繁插入/删除:优先
std::deque。 - 中间频繁插入/删除:考虑
std::list,但前提是你真的不依赖随机访问和遍历性能。 - 需要有序键或有序唯一集合:选择
std::map或std::set。 - 只想快速查找,不关心顺序:优先
std::unordered_map或std::unordered_set。 - 只需要栈、队列、优先级队列接口:直接使用
std::stack、std::queue、std::priority_queue。
最后还是那句话:容器选择没有绝对“最强”,只有是否贴合当前数据访问模式。先把核心矛盾找准,是访问速度、插入删除位置、是否有序,还是内存开销,再选容器,通常就不会偏得太远。



