在 Linux 上写系统级程序,常见痛点无非是内存安全、并发控制和调试成本。Rust 之所以越来越常被拿来做这类工作,关键就在于它把性能、底层控制力和一套更严格的安全约束放到了一起。下面按“环境准备、示例落地、调试构建、继续下探系统调用”的顺序梳理一遍,方便你判断这条技术路径是否适合自己的项目。
先把 Rust 开发环境装好
在 Linux 下,最直接的做法是使用 Rust 官方推荐的安装脚本:
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh安装完成后,还需要把 Rust 的可执行文件加入当前 shell 环境,否则系统可能找不到 cargo 和 rustc:
source $HOME/.cargo/env做到这一步后,基础工具链就已经就位,后续创建项目、编译和测试都会围绕 Cargo 展开。
用 Cargo 创建系统程序项目骨架
Rust 的项目脚手架通常直接交给 Cargo 生成,这也是最省事的起步方式:
cargo new my_system_program
cd my_system_program
执行后会得到一个标准目录结构,核心文件包括 src/main.rs 和 Cargo.toml。前者是程序入口,后者用来声明项目元数据和依赖。对于系统级程序来说,这套结构足够作为第一版原型的起点。
先写一个能跑的 Unix 域套接字服务
如果你想快速验证 Rust 在 Linux 系统编程里的手感,Unix 域套接字是个很合适的切入点。它既贴近本地进程间通信场景,也能直接接触到 Unix 相关接口。
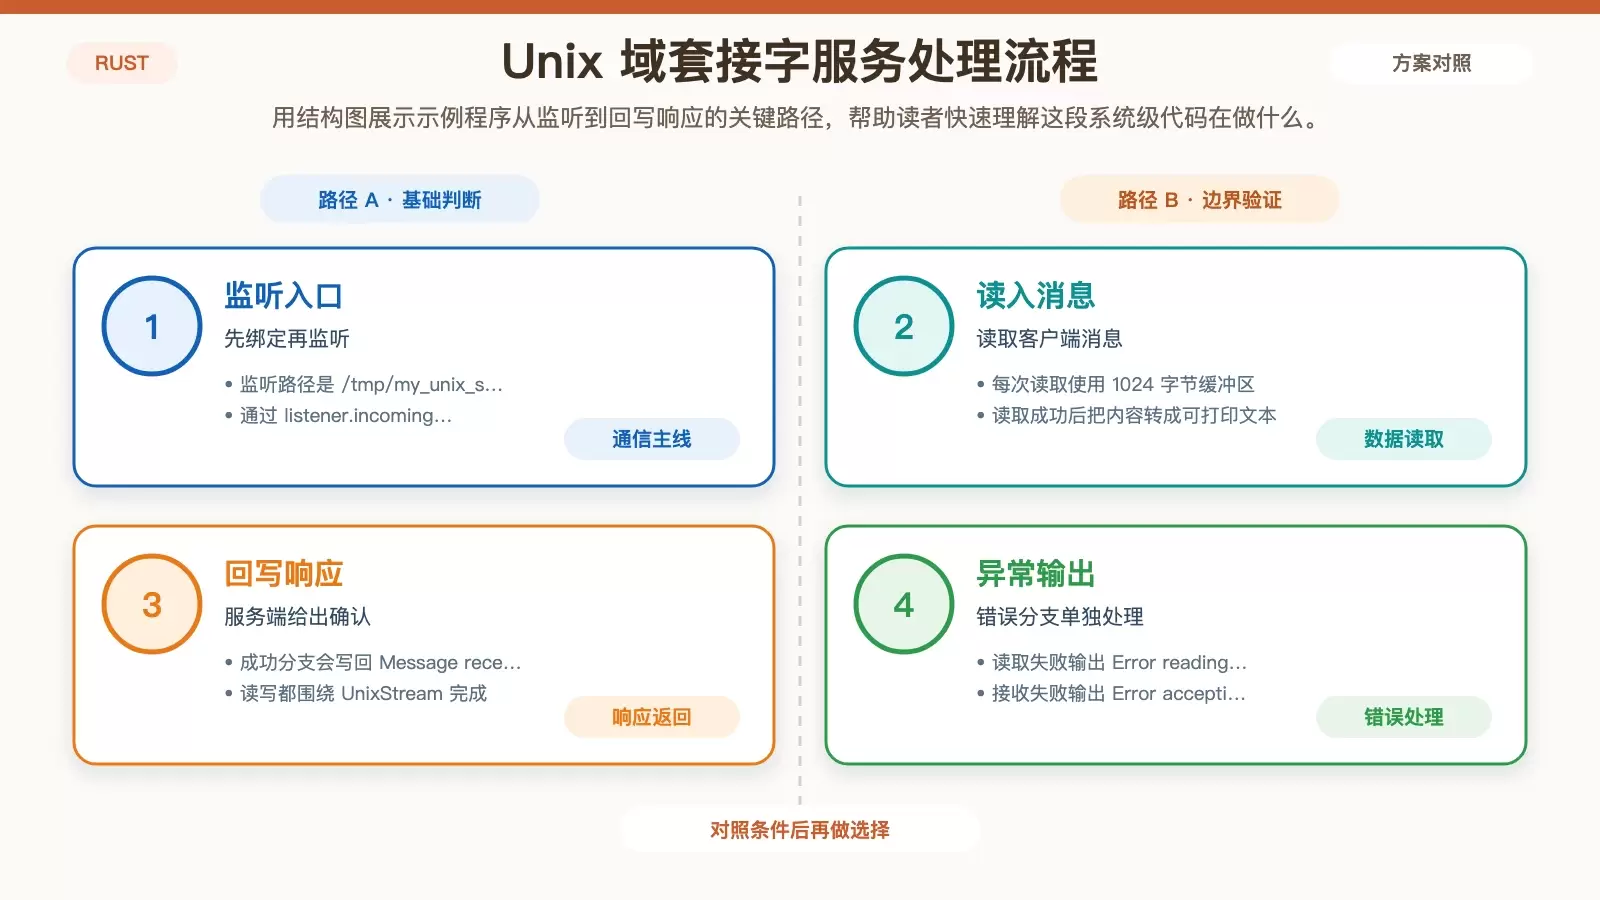
下面这个示例会在 /tmp/my_unix_socket 上创建监听端点,接收客户端连接、读取消息并返回响应:
use std::os::unix::net::{UnixListener, UnixStream};
use std::io::{Read, Write};

fn handle_client(mut stream: UnixStream) {
    let mut buffer = [0; 1024];
    match stream.read(&mut buffer) {
        Ok(_) => {
            println!("Received a message: {}", String::from_utf8_lossy(&buffer));
            stream.write_all(b"Message received").unwrap();
        },
        Err(e) => {
            eprintln!("Error reading from socket: {}", e);
        }
    }
}

fn main() -> std::io::Result<()> {
    let socket_path = "/tmp/my_unix_socket";
    let listener = UnixListener::bind(socket_path)?;
    println!("Listening on {}", socket_path);
    for stream in listener.incoming() {
        match stream {
            Ok(stream) => {
                handle_client(stream);
            },
            Err(e) => {
                eprintln!("Error accepting connection: {}", e);
            }
        }
    }
    Ok(())
}
这个例子用到了 std::os::unix::net 模块,它是 Rust 标准库里面向 Unix 平台的本地套接字接口。放在系统编程语境里看,这段代码已经覆盖了几个典型动作:绑定套接字、接收连接、读写数据、处理 I/O 错误。
为什么这个例子适合作为入门样本
一方面,它保留了系统程序常见的底层特征,比如直接围绕文件描述符语义进行通信;另一方面,它又没有一下子跳到 epoll、信号处理或多进程协作那种更复杂的话题,适合先把 Rust 的基本写法和错误处理习惯建立起来。
如何构建、运行和测试
程序写完后,可以先用发布模式构建优化后的二进制:
cargo build --release构建完成后,直接运行生成出来的可执行文件:
./target/release/my_system_program启动后,服务端会开始监听 /tmp/my_unix_socket。
调试阶段,最简单的方式就是继续使用 println! 输出关键日志。虽然方法朴素,但在排查连接、消息内容和错误分支时依然很有效。测试方面,Rust 原生支持 #[test],写好测试函数后直接执行:
cargo test这意味着即便是偏底层的程序,也可以较早把测试纳入工作流,而不必额外引入测试框架。
需要更底层时,如何接入系统调用
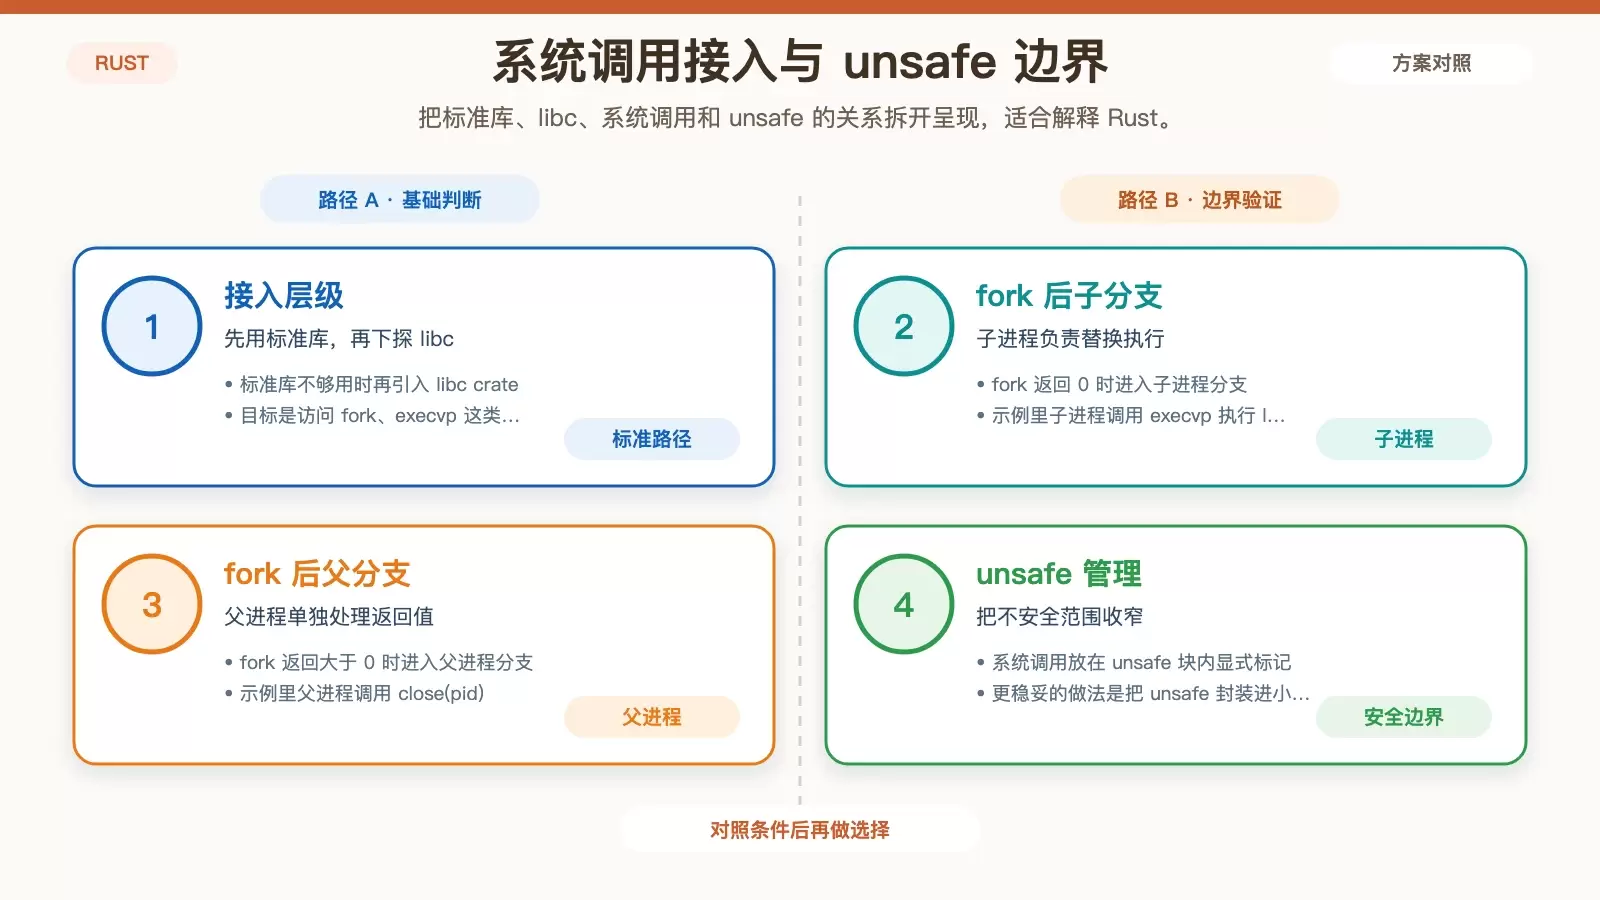
如果标准库不够用,比如要直接操作 fork、execvp 这类系统调用,就需要借助 libc crate。原文给出的示例如下:
extern crate libc;
use libc::{c_int, close, fork, execvp};

fn main() {
    let pid = unsafe { fork() };
    if pid == 0 {
        // Child process
        let args = ["ls", "-l"];
        let envp = std::ptr::null_mut();
        unsafe { execvp(args[0], args.as_ptr()) };
    } else if pid > 0 {
        // Parent process
        unsafe { close(pid) };
    } else {
        eprintln!("Failed to fork");
    }
}
这里最需要注意的是 unsafe。在系统编程场景下,Rust 并不是完全不碰危险操作,而是把这些操作显式隔离出来,让你清楚知道哪里越过了编译器的安全保护边界。
怎么看待 unsafe 的边界
unsafe 并不等于代码一定有问题,它更像是一种声明:这一小段逻辑需要程序员自己保证前提成立。实际开发里,比较稳妥的做法通常是把这类调用封装进小而清晰的接口中,尽量缩小不安全代码的范围,让大部分业务逻辑仍然待在 Rust 的安全模型之内。
Rust 在系统级开发里的价值到底在哪
对很多 Linux 系统程序来说,Rust 的真正吸引力不只是“能调用底层接口”,而是它在调用这些接口时仍然提供了额外约束。所有权模型、借用检查器和类型系统,能帮助你更早发现几类传统系统语言里常见的问题:
- 内存泄漏
- 悬垂指针
- 数据竞争
这并不意味着用了 Rust 就不会出错,而是很多错误会更早暴露在编译期。对于长期维护的系统工具、守护进程或基础设施组件来说,这种收益往往比语法本身更重要。
文档入口与下一步学习方向
入门阶段,最值得优先看的资料仍然是官方体系文档:
- Rust官方文档
- Rust标准库文档
- Rust社区和论坛
如果你已经完成了本文这条基础路径,下一步通常就会进入更典型的 Linux 系统主题,例如信号处理、epoll、io_uring 等。它们复杂得多,但前提仍然是先把工具链、项目结构、I/O 编程模型和 unsafe 边界理解清楚。


