在 Linux 环境里写并发程序,难点通常不在“能不能跑起来”,而在于怎样同时兼顾性能、可维护性和数据安全。Rust 把所有权、类型系统和多种并发模型结合在一起,既能覆盖多线程计算,也能处理高并发 I/O;下面就按实际开发中最常见的几类问题展开,帮助你快速判断每种方案适合什么场景、代码该怎么落地。
先完成环境准备:安装工具链并创建项目
开始之前,先把 Linux 下的 Rust 开发环境准备好。原文给出的步骤可以直接使用:
- 安装 Rust 工具链:
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
source $HOME/.cargo/env
第一条命令用于安装 Rust,第二条命令会把 Rust 工具链加入当前 shell 的 PATH。
- 创建项目:
cargo new concurrent_demo && cd concurrent_demo执行后,Cargo 会自动生成 Cargo.toml 和 src/main.rs。前者负责依赖管理,后者是程序入口。后续无论你要写线程、异步任务还是并行计算,基本都会从这个目录结构开始。
线程怎么创建和回收
如果你的任务适合直接交给操作系统线程处理,Rust 标准库里的 std::thread 就够用了。核心入口是 thread::spawn,它会启动一个新线程,并返回 JoinHandle,让主线程可以显式等待它结束。
示例:创建线程并等待退出
use std::thread;
use std::time::Duration;

fn main() {
    let handle = thread::spawn(|| {
        for i in 1..5 {
            println!("子线程: {}", i);
            thread::sleep(Duration::from_millis(500));
        }
    });

    for i in 1..3 {
        println!("主线程: {}", i);
        thread::sleep(Duration::from_millis(500));
    }

    handle.join().unwrap(); // 等待子线程结束
    println!("主线程退出");
}
这段代码里,主线程和子线程会并行执行;而 handle.join().unwrap() 的作用,是在主线程退出前等待子线程收尾。对于需要明确生命周期、执行顺序较清晰的任务,这种写法最直接。
判断标准也很简单:如果你只是把少量独立任务拆给几个线程执行,而且不涉及复杂 I/O 调度,标准线程模型往往已经足够。
共享数据时,为什么通常用 Arc + Mutex
一旦多个线程要访问同一份数据,就会进入并发编程里最容易出问题的部分。Rust 的常见做法是用 Arc 解决“多线程共享所有权”,再用 Mutex 或 RwLock 保证访问时的同步安全。
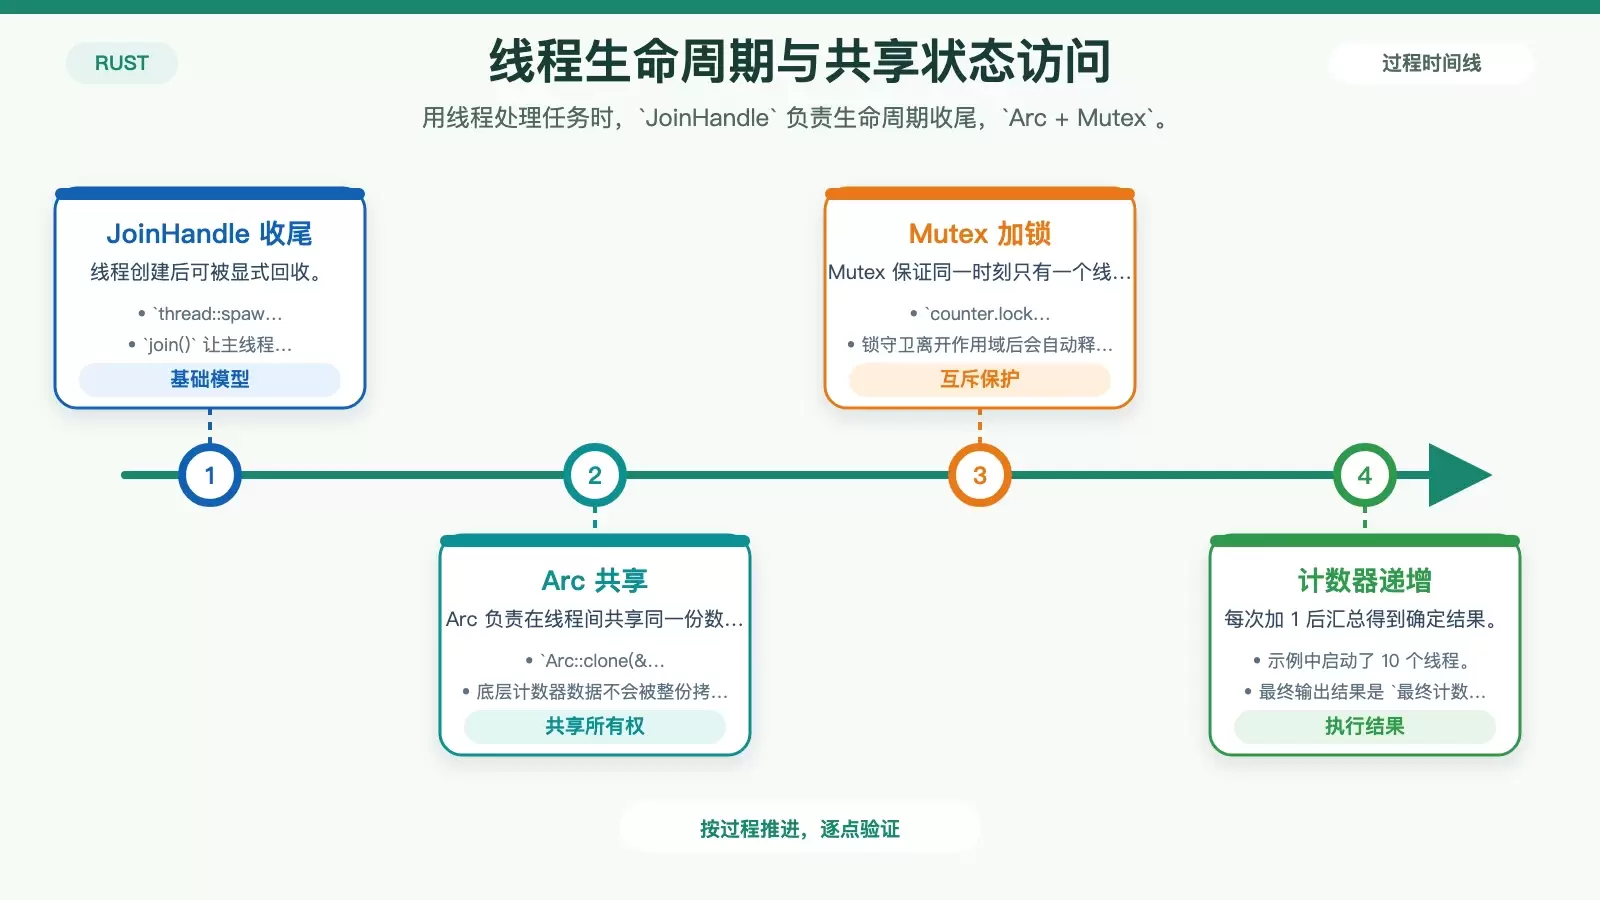
Arc 是原子引用计数,适合在多个线程之间安全共享对象;Mutex 负责保证同一时间只有一个线程可以修改数据。对于读多写少的场景,则可以考虑 RwLock。
示例:用 Arc + Mutex 实现共享计数器
use std::sync::{Arc, Mutex};
use std::thread;

fn main() {
    let counter = Arc::new(Mutex::new(0)); // Arc确保线程安全共享,Mutex保护数据
    let mut handles = vec![];

    for _ in 0..10 {
        let counter = Arc::clone(&counter); // 克隆Arc以传递所有权
        let handle = thread::spawn(move || {
            let mut num = counter.lock().unwrap(); // 获取锁(阻塞直到可用)
            *num += 1; // 修改共享数据
        });
        handles.push(handle);
    }

    for handle in handles {
        handle.join().unwrap(); // 等待所有线程完成
    }

    println!("最终计数: {}", *counter.lock().unwrap()); // 输出: 10
}
这里有几个关键点:
Arc::clone(&counter)并不是复制底层数据,而是复制共享所有权。counter.lock().unwrap()会拿到一个MutexGuard。- 这个守卫对象离开作用域后,锁会自动释放,也就是常说的 RAII 锁管理。
如果你的问题本质上是“多个线程必须共同修改同一份状态”,这类同步原语就很难绕开。但共享状态越多,代码复杂度通常也越高,因此在设计上仍然应该尽量缩小共享范围。
线程之间通信,优先考虑消息传递
相比“大家一起改同一份数据”,Rust 更鼓励把数据直接发送给另一个线程处理。标准库中的 std::sync::mpsc 提供了多生产者、单消费者通道,是最常见的线程通信方式之一。
示例:使用通道发送消息
use std::sync::mpsc;
use std::thread;
use std::time::Duration;

fn main() {
    let (tx, rx) = mpsc::channel(); // 创建通道(tx: 发送端, rx: 接收端)

    thread::spawn(move || {
        let messages = vec![
            "Hello from thread!".to_string(),
            "Another message".to_string(),
        ];

        for msg in messages {
            tx.send(msg).unwrap(); // 发送消息(阻塞直到接收端接收)
            thread::sleep(Duration::from_secs(1));
        }
    });

    // 接收消息(阻塞直到发送端发送)
    for received in rx {
        println!("收到: {}", received);
    }
}
这类模型的优势在于,数据所有权会随着消息一起从发送端转移到接收端。也就是说,线程之间不是共同持有同一份可变状态,而是通过“谁拿到消息,谁负责处理”的方式协作,逻辑上更容易保持清晰。
如果你的业务流程天然是“生产者生成数据,消费者处理数据”,那通道通常比共享锁更容易维护。
高并发 I/O 场景,切换到 async/await 和 Tokio
当并发重点不再是 CPU 计算,而是网络请求、TCP 连接、文件读写这类 I/O 任务时,继续大量创建系统线程往往不是最优解。Rust 在这类场景里更常用 async/await 配合异步运行时,例如 Tokio。
先添加 Tokio 依赖
在 Cargo.toml 中加入:
[dependencies]
tokio = { version = "1", features = ["full"] } // 启用Tokio全功能
示例:异步 TCP 服务器
use tokio::net::TcpListener;
use tokio::prelude::*;

#[tokio::main] // 宏:启动Tokio运行时
async fn main() -> Result<(), Box> {
    let listener = TcpListener::bind("127.0.0.1:8080").await?; // 绑定端口

    loop {
        let (mut socket, addr) = listener.accept().await?; // 接受连接
        println!("新连接: {}", addr);

        // 为每个连接生成异步任务
        tokio::spawn(async move {
            let mut buf = [0; 1024]; // 缓冲区
            loop {
                match socket.read(&mut buf).await {
                    Ok(n) if n == 0 => return, // 连接关闭
                    Ok(n) => {
                        // 回显数据
                        if let Err(e) = socket.write_all(&buf[0..n]).await {
                            eprintln!("写入错误: {}", e);
                            return;
                        }
                    }
                    Err(e) => {
                        eprintln!("读取错误: {}", e);
                        return;
                    }
                }
            }
        });
    }
} 这里的关键区别是:tokio::spawn 创建的是异步任务,而不是操作系统线程;await 会在 I/O 等待期间把执行权交还给运行时调度器,因此单机可以更高效地处理大量连接。
需要特别注意的是,在异步代码里不要随手使用 std::thread::sleep 这类阻塞调用,否则会卡住运行时。原文提到的建议很重要:异步场景里应优先用 tokio::time::sleep。
CPU 密集型任务,用 Rayon 简化数据并行
如果你的目标不是处理海量连接,而是把一批计算任务更快地跑完,比如批量运算、数据处理、统计汇总,那么 Rayon 往往比手动拆线程更省事。它提供并行迭代器,会自动管理线程池和任务分配。
示例:并行求和
use rayon::prelude::*;

fn main() {
    let numbers = vec![1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
    let sum: i32 = numbers.par_iter().sum(); // par_iter(): 并行迭代器
    println!("总和: {}", sum); // 输出: 55
}
par_iter() 会把迭代任务切分到多个工作线程中,再由 sum() 汇总结果。对开发者来说,最大的价值是少写线程管理代码,直接把注意力放回数据处理逻辑本身。
简单说,CPU 密集型任务优先考虑 Rayon;I/O 密集型任务优先考虑 Tokio,这个区分在选型时非常实用。
一组实用的 Rust 并发编程建议
结合上面的几类模型,可以把原文里的实践建议整理成更易落地的判断规则:
- 优先使用消息传递:能不共享状态时,就尽量不要共享状态。
- 按读写比例选择同步原语:
Mutex适合写多读少或结构简单的共享修改,RwLock更适合读多写少。 - 异步代码里避免阻塞运行时:例如使用
tokio::time::sleep,而不是std::thread::sleep。 - CPU 密集型任务优先交给线程池:
Rayon可以减少手动调度成本。 - 保持显式错误处理:异步操作优先返回
Result,减少无意义的panic。
如果要用一句话概括选型思路,就是:线程适合直接并行执行,Arc + Mutex 适合必须共享状态的场景,mpsc 适合清晰的数据流转,Tokio 适合高并发 I/O,Rayon 适合数据并行计算。


