很多人把系统崩溃看成“毫无征兆”的瞬间事件,但对 Linux 来说,真正完全没有提示的情况并不多。内核、驱动和硬件一旦开始失稳,往往会先把异常写进 dmesg,只是这些信息常被忽略。
这篇文章不讲复杂的排障流程,而是先帮你建立一套“看日志抓前兆”的判断框架。只要把常见报错类型和关键字对应起来,你就能更快分辨问题属于立刻会停机的致命错误,还是正在积累、随时可能演变成崩溃的隐患。
为什么系统崩溃前要先看 dmesg
dmesg 记录的是内核环形缓冲区里的消息,很多最底层的问题都会先出现在这里,包括内核异常、驱动加载失败、硬件识别错误、内存故障和文件系统损坏。对于“系统卡死前到底发生了什么”这个问题,它通常比普通应用日志更接近现场。
实际排查时,可以先关注两类信息:一类是直接表明内核已经进入危险状态的致命报错;另一类是虽然系统还没停,但已经在提示设备、资源或服务出现异常的预警信号。
最危险的信号:Kernel Panic 与 Oops
如果 dmesg 里已经出现内核主动报错,说明问题通常不再是“可能崩”,而是“已经在崩溃边缘”了。
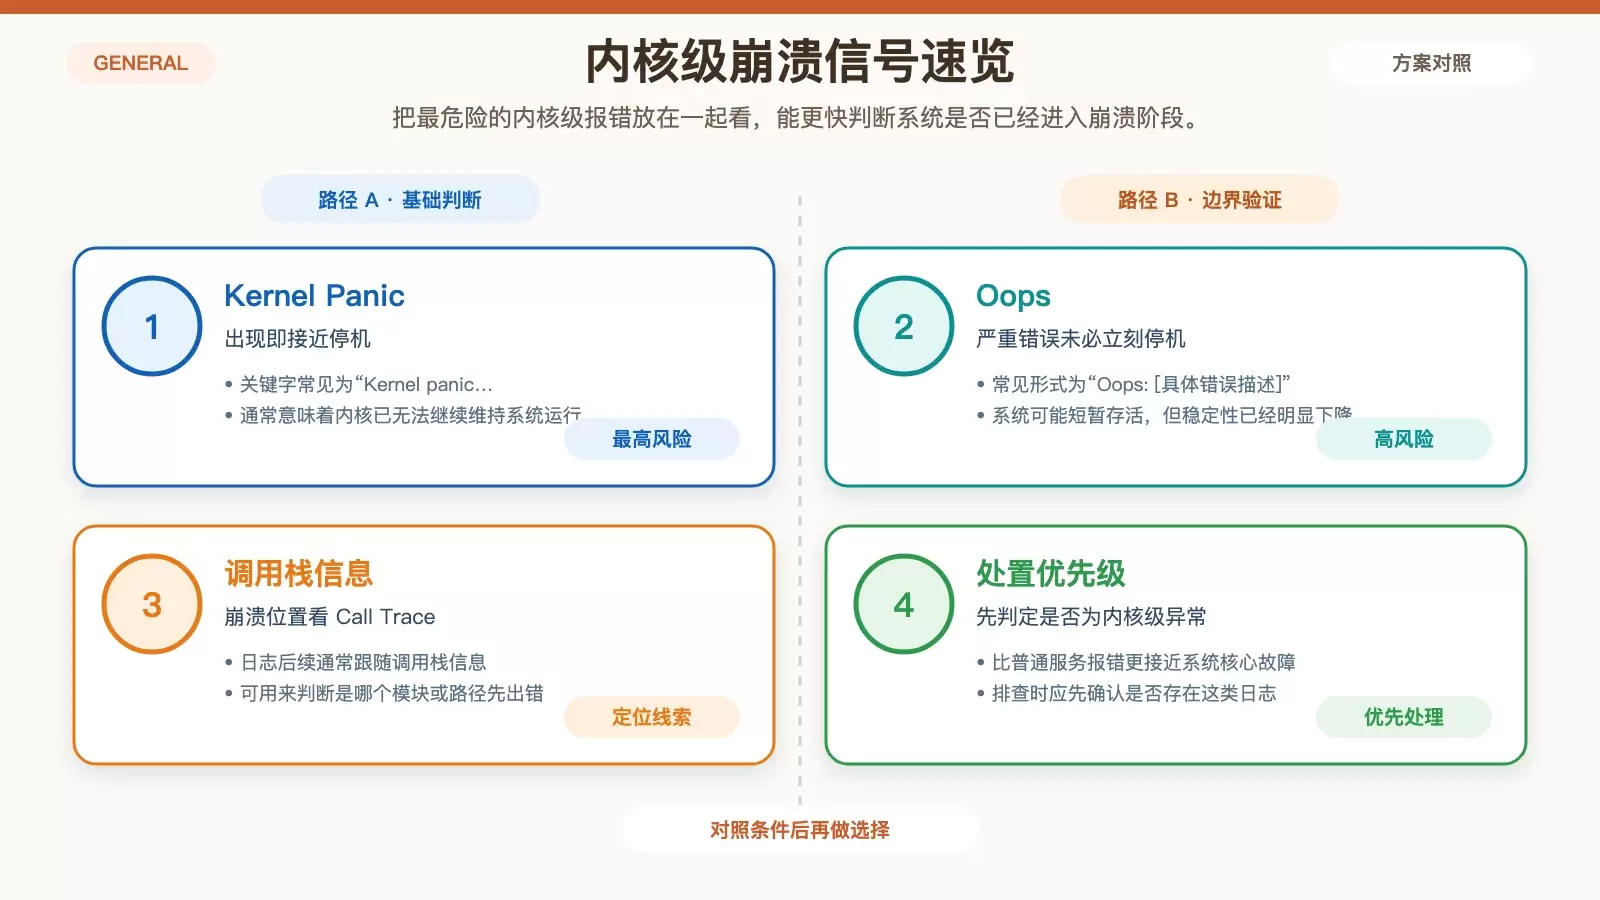
Kernel Panic:系统基本已经停摆
最典型的关键字是:
Kernel panic - not syncing
这表示内核遇到无法继续运行的错误,已经放弃维持系统状态。看到这类信息时,重点不在“是否严重”,而在于尽快结合后续调用栈定位触发点。
Oops:严重错误但未必当场宕机
另一类常见信号是:
Oops: [具体错误描述]
Oops 表示内核检测到了严重错误,某些情况下系统还会短暂继续运行,但稳定性通常已经明显下降。日志后面往往伴随 Call Trace,它能帮助你判断是哪个模块、驱动或内核路径先出的问题。
硬件与驱动报错,往往是崩溃前的第一波异常
不少系统故障并不是内核“自己坏了”,而是底层硬件状态异常,或者驱动与内核、固件之间不兼容,最后把系统拖进不稳定状态。
硬件识别失败
device not recognizedunable to enumerate device
这类信息说明设备枚举或识别过程出了问题。常见影响是设备不可用、反复重连,进一步可能触发驱动异常或 I/O 错误。
IOMMU、ACPI 与 PCI 相关异常
IOMMU: No translation found for addressACPI Error: AE_NOT_FOUNDPCI: no hotplug handler for device
这几类报错通常意味着平台固件、设备映射或热插拔处理链路存在问题。它们未必立即导致宕机,但会显著增加驱动不稳定、设备失联和启动异常的概率。
驱动被禁用或模块加载失败
driver xxx has been banned from the kernelERROR: Module yyy not foundmodule verification failedmodule verification failed: signature and/or required key missing - tainting kernel
如果驱动被内核拉黑,通常说明它已经多次触发故障;而模块缺失、签名校验失败,则更偏向部署或兼容性问题。尤其是出现 tainting kernel 时,代表内核状态已经被“污染”,后续再出现崩溃,排查难度会明显上升。
内存和文件系统异常,最容易演变成硬崩溃
相比单纯的网络或服务故障,内存与文件系统问题更接近系统生存基础。一旦这里持续报错,风险通常更高。
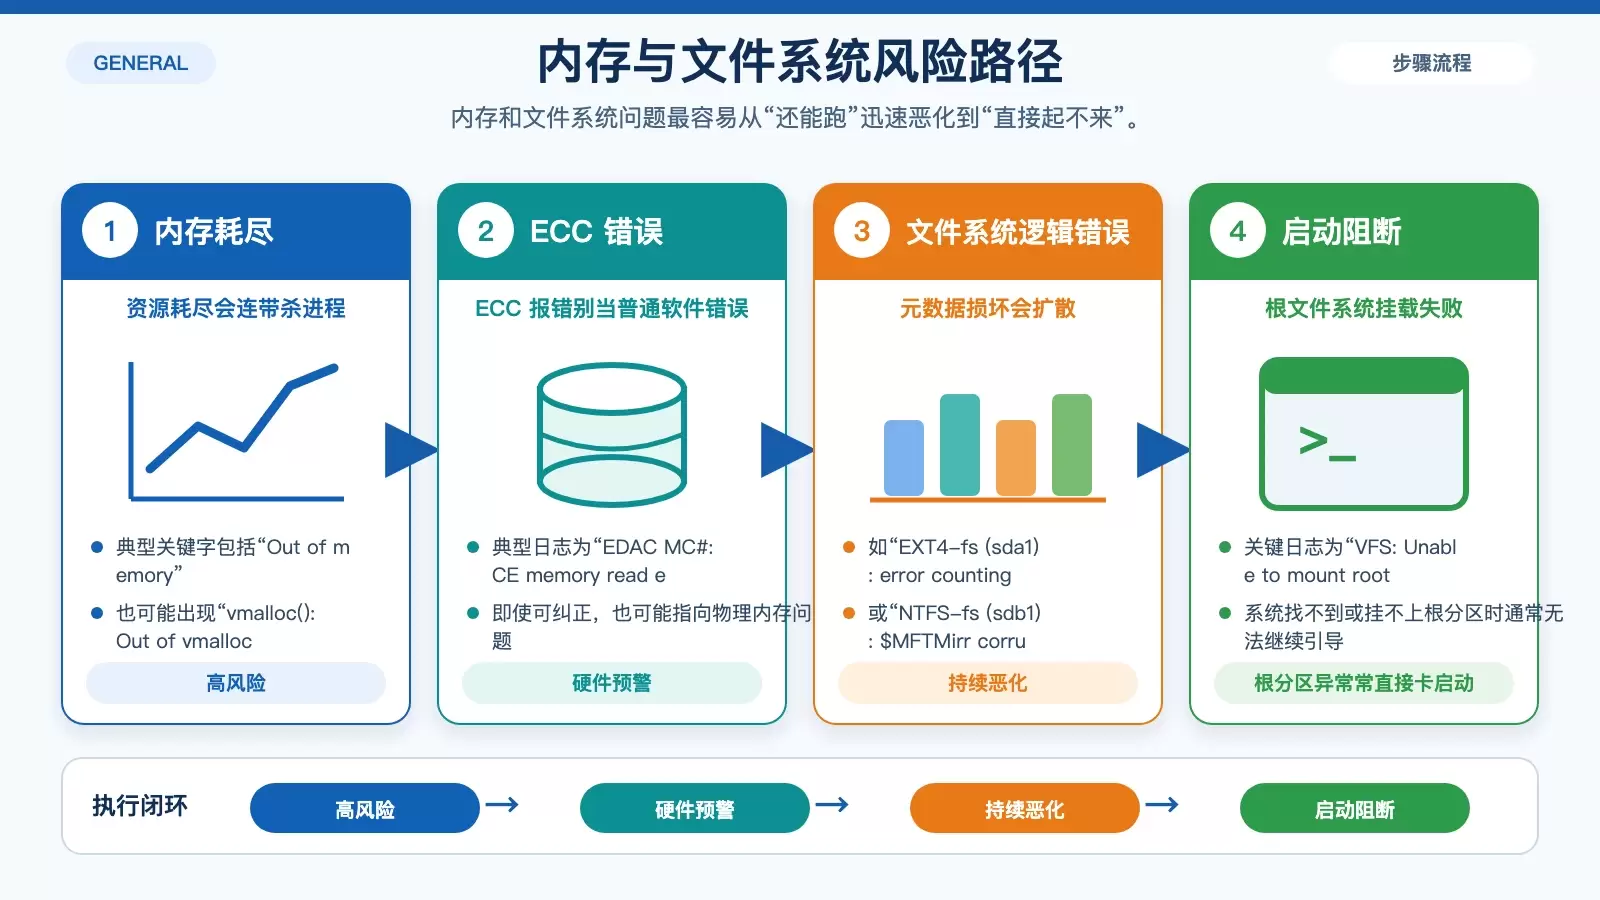
内存耗尽与地址空间不足
Out of memoryvmalloc(): Out of vmalloc area
这说明物理内存、内核虚拟地址空间或相关分配能力已经吃紧。若问题持续出现,进程会被杀掉,严重时甚至会连带触发系统级失稳。
ECC 报错可能指向物理内存故障
EDAC MC#: CE memory read error
这类日志往往不是普通软件错误,而是内存硬件层面的预警。即使当前只是可纠正错误,也值得尽快检查 DIMM、主板插槽或相关平台稳定性。
文件系统逻辑损坏
EXT4-fs (sda1): error counting free blocksNTFS-fs (sdb1): $MFTMirr corrupt
这说明文件系统元数据已经出现异常。起初可能只是部分目录或文件访问异常,但继续运行后,损坏范围可能扩大,最终影响启动和关键服务。
根文件系统无法挂载
VFS: Unable to mount root fs on unknown-block(0,0)
这是启动阶段非常关键的报错。系统连根分区都找不到或挂不上时,内核通常无法继续引导,表现就是直接卡死或启动失败。
网络、服务、资源冲突与温度电源问题怎么判断
这几类错误未必都来自同一个层面,但共同点是:它们经常不是最先被怀疑的原因,却能在关键时刻把系统推向不可用状态。
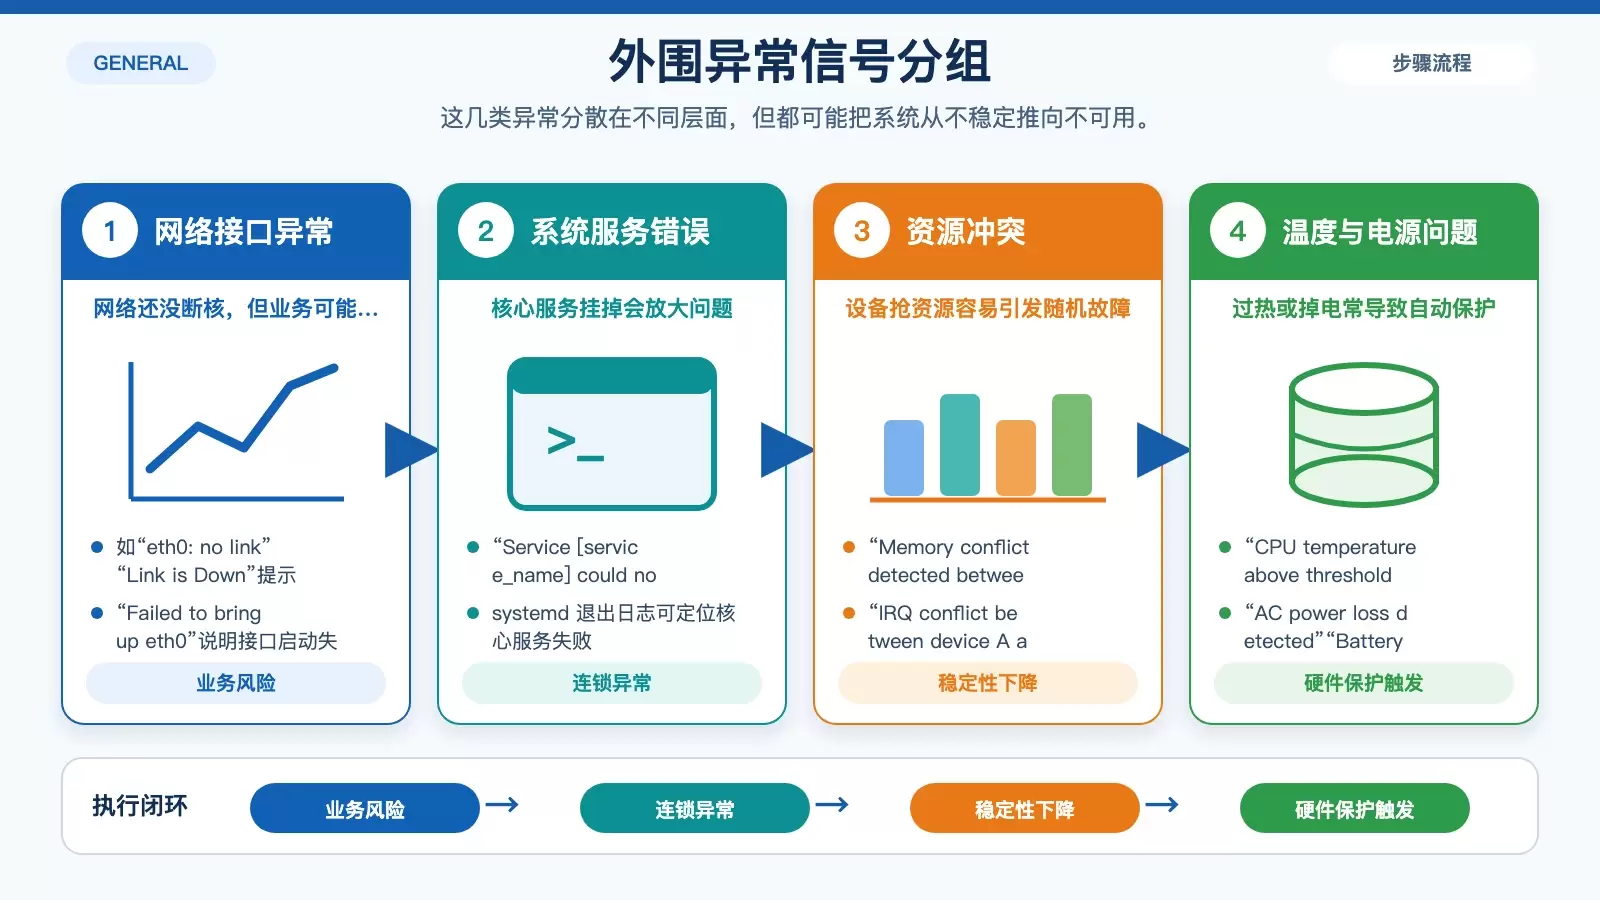
网络接口异常
eth0: no linkLink is DownFailed to bring up eth0RTNETLINK answers: File exists
对于依赖网络通信的服务器,这些信息意味着链路、接口初始化或路由配置已经出现问题。即使系统内核还活着,业务层面也可能已经接近“不可用”。
关键系统服务退出
Service [service_name] could not be startedSystemd[1]: [service_name].service: Main process exited, code=exited, status=1/FAILURE
如果失败的是 network、ssh 等核心服务,问题就不只是“某个功能不可用”,而可能是系统进入连锁异常的开端。
资源冲突会拖垮稳定性
Memory conflict detected between devicesIRQ conflict between device A and B
内存区域冲突或 IRQ 冲突说明多个设备正在争用关键资源。它们常见于硬件组合复杂、固件配置特殊或驱动支持不完整的环境中。
温度和供电异常不能忽视
CPU temperature above thresholdthermal throttling activatedAC power loss detectedBattery low
过热会触发降频,进一步可能导致自动关机;供电不稳则容易造成随机重启、磁盘异常甚至文件系统损坏。这类问题往往表面像“系统突然挂了”,本质却是硬件保护机制在接管。
看到这些 dmesg 信号后,优先级该怎么排
如果只是想快速判断风险高低,可以按下面的思路处理:
- 先看是否出现
Kernel panic、Oops、Call Trace,这是最直接的崩溃级信号; - 再看内存、文件系统、根分区挂载类报错,这些最容易让系统直接失去运行基础;
- 随后检查硬件识别、驱动加载、IOMMU/ACPI/PCI 异常,它们常是更深层问题的上游原因;
- 最后结合网络、systemd 服务、资源冲突、温度和供电信息,判断是否存在会持续放大故障的环境因素。
简单说,dmesg 不是只在系统已经崩掉后才有价值。很多时候,它更像一份提前发出的故障预警清单。能不能在日志里提早读出这些信号,往往决定了你是被动等宕机,还是能在系统彻底停摆前抢到排查窗口。


