在 Linux 上跑 JavaScript 服务时,最棘手的问题之一就是内存泄漏:进程看起来还能工作,但内存占用持续抬升,响应越来越慢,最后把服务拖垮。要把问题真正找出来,不能只盯着某一个工具,而是要按“观察现象、定位对象、回看代码、验证修复”这条线往下查。本文把这套排查路径拆开讲清楚,读完你可以判断泄漏是否存在、优先从哪里下手,以及哪些修复手段只是临时止血。
先确认:内存是不是在持续上涨
排查前先别急着改代码,第一步是确认内存增长是不是持续性的,而不是正常波动。Linux 下最直接的办法,就是先盯住目标进程的内存走势。
用 Linux 命令先看进程占用
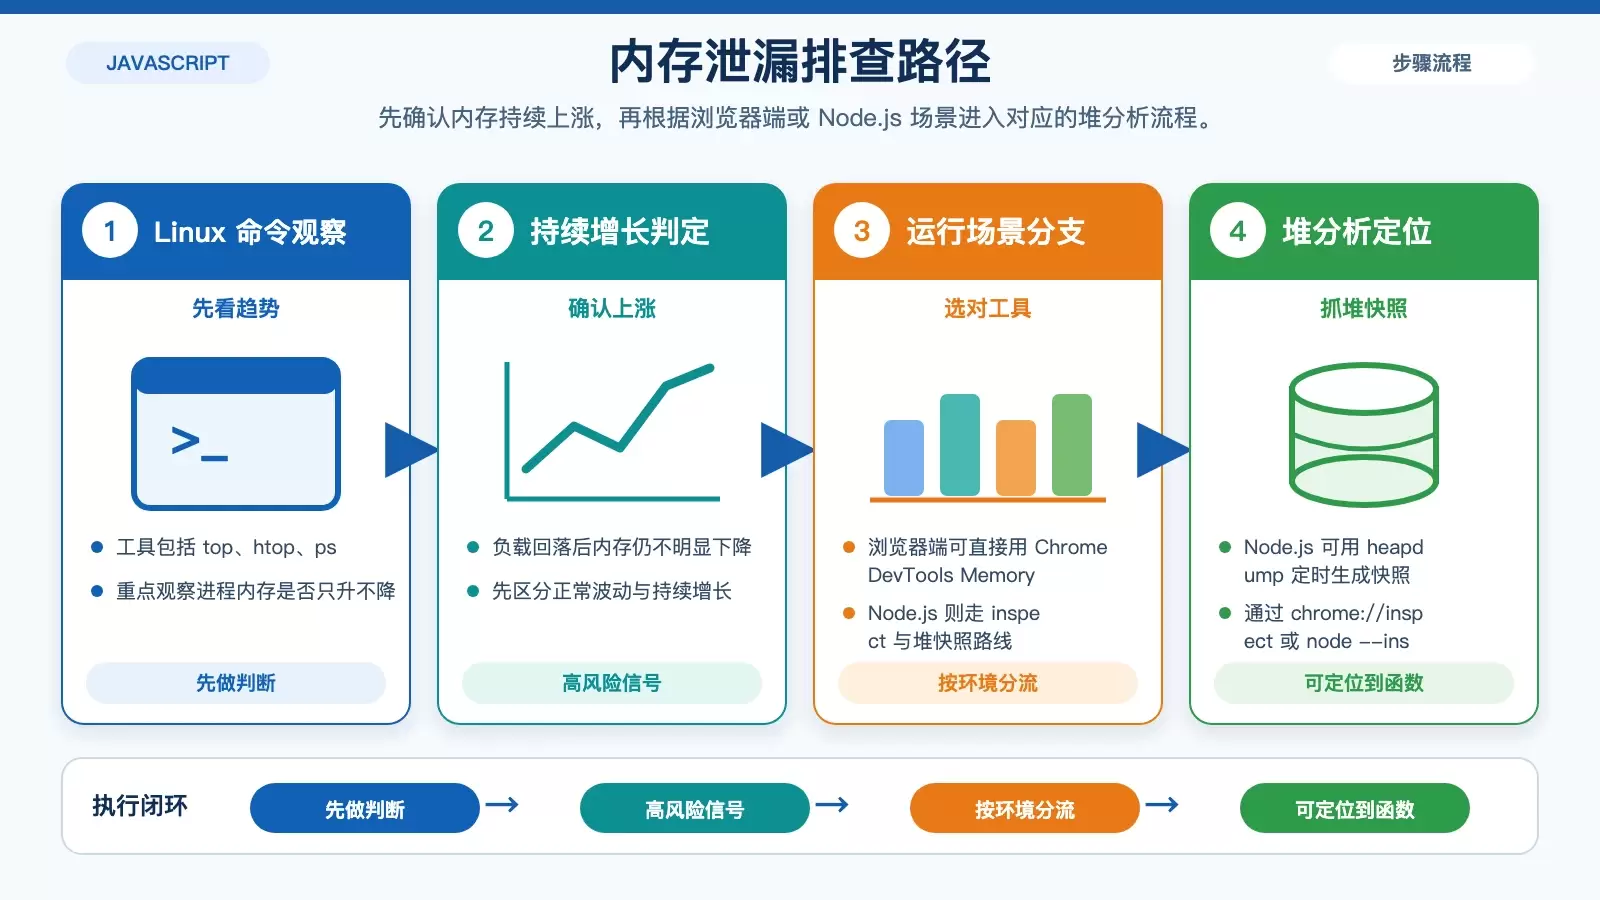
常用工具包括 top、htop 和 ps。它们不负责告诉你“为什么泄漏”,但能先回答一个关键问题:这个进程的内存,是不是只涨不回。
如果在一段业务运行周期内,内存占用持续上升,且负载回落后也没有明显下降,就要高度怀疑存在泄漏。这一步虽然简单,却能帮你避免在“正常缓存增长”和“真实泄漏”之间误判。
再定位:按运行场景选择内存分析工具
确认趋势后,下一步不是盲查代码,而是先用堆分析工具缩小范围。不同的 JavaScript 运行环境,适合的工具也不同。
浏览器端:直接看 Chrome DevTools Memory 面板
如果问题出在浏览器中的 JavaScript,最直接的办法是打开 Chrome DevTools 的 Memory 面板,拍堆快照、查看对象引用关系。通常对比几次快照之后,就能看到哪些对象没有被释放、哪些引用链还挂着。
Node.js:用 --inspect 和堆快照定位到函数级别
如果是 Node.js 应用,可以在启动时加上 --inspect 标志,例如:
node --inspect-brk随后再用 Chrome DevTools 连接目标进程,分析堆内存情况。更进一步的做法,是借助 heapdump 模块定时生成堆快照文件,再通过 chrome://inspect 或 node --inspect 对比分析。做到这一步,泄漏点通常已经能缩小到具体函数或对象生命周期。
重点排查:代码里最常见的泄漏热点
真正的内存泄漏,很多时候并不复杂,反而集中在少数几类高频错误上。代码审查之所以老生常谈,是因为大部分问题最后还是会回到“引用没有被正确释放”。
最常见的 5 类泄漏来源
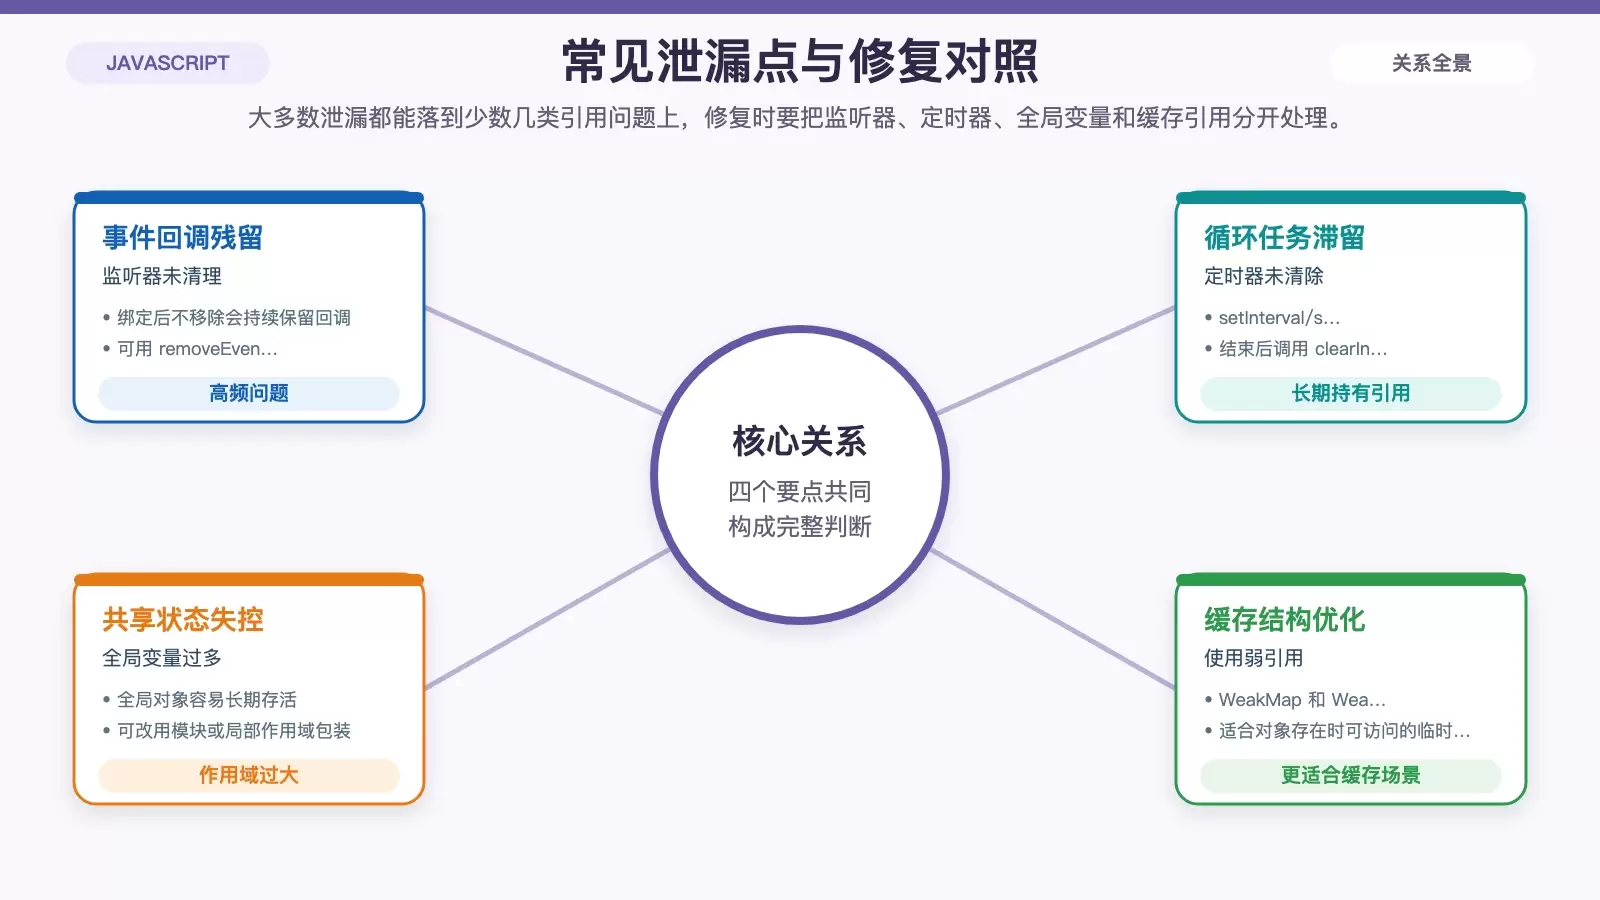
- 全局变量:挂在全局作用域上的对象会长期存活,容易一直占着内存不释放。
- 闭包保留外部引用:闭包写得不谨慎,可能把本该销毁的数据继续留在内存里。
- 事件监听器未移除:监听器绑定后没有清理,回调函数和相关对象会持续被引用。
- 定时器未清除:
setInterval/setTimeout忘记停止,执行链条会继续持有对象。 - DOM 已移除但引用仍在:元素虽然从页面删掉了,但 JavaScript 里还保留着引用,GC 无法回收。
把这些位置逐项过一遍,通常就能覆盖相当一部分实际泄漏场景,原文中提到的经验判断是:这类检查基本能命中 80% 的问题来源。
找到问题后,修复要对准引用关系
定位到泄漏点之后,修复思路通常也比较明确。核心目标只有一个:让不再需要的引用尽快断开,给 GC 回收机会。
优先清理监听器和定时器
事件监听器在不需要时要及时移除,可以直接使用 removeEventListener,或者借助框架生命周期钩子统一清理。
定时器同样如此,用完就要调用 clearInterval 或 clearTimeout。这类问题看起来细小,但往往最容易在长期运行的服务里积累出明显内存增长。
减少长期存活的引用
全局变量能不用就不用;确实需要共享状态时,更适合放进模块作用域,或者通过更明确的局部封装管理生命周期。
对于缓存或临时关联对象,优先考虑 WeakMap 和 WeakSet。它们不会阻止垃圾回收,尤其适合“对象存在时可访问、对象销毁后自动释放”的场景。
辅助线索也别放过:日志、依赖和检测库
很多人排查泄漏时只盯着堆快照,忽略了外围线索。实际上,日志、第三方库版本和自动检测工具,往往能明显缩短定位时间。
先翻日志,找异常堆积点
应用日志里常常会暴露真正的诱因,比如某个异步操作持续失败,导致资源不断堆积;或者某个第三方库报错后,中间对象没有释放。比起纯靠猜测,先看错误和警告信息,通常更快接近根因。
按需使用内存检测库
Node.js 社区有一些现成工具,比如 memwatch-next 和 node-memwatch,可以在检测到堆内存异常增长时触发回调,用来做预警或辅助观测。不过这些库本身也可能带来兼容性和维护问题,接入前需要评估运行环境。
检查依赖版本,避开已知问题
并不是所有泄漏都出在业务代码里,旧版本依赖也可能是根因。一些 npm 包已经在后续版本中修复过内存问题,因此定期执行下面的命令很有必要:
npm outdated升级时重点看 changelog,尤其关注带有 “memory leak” 或 “memory fix” 标记的条目。
最后验证:用压测放大问题,并准备临时兜底
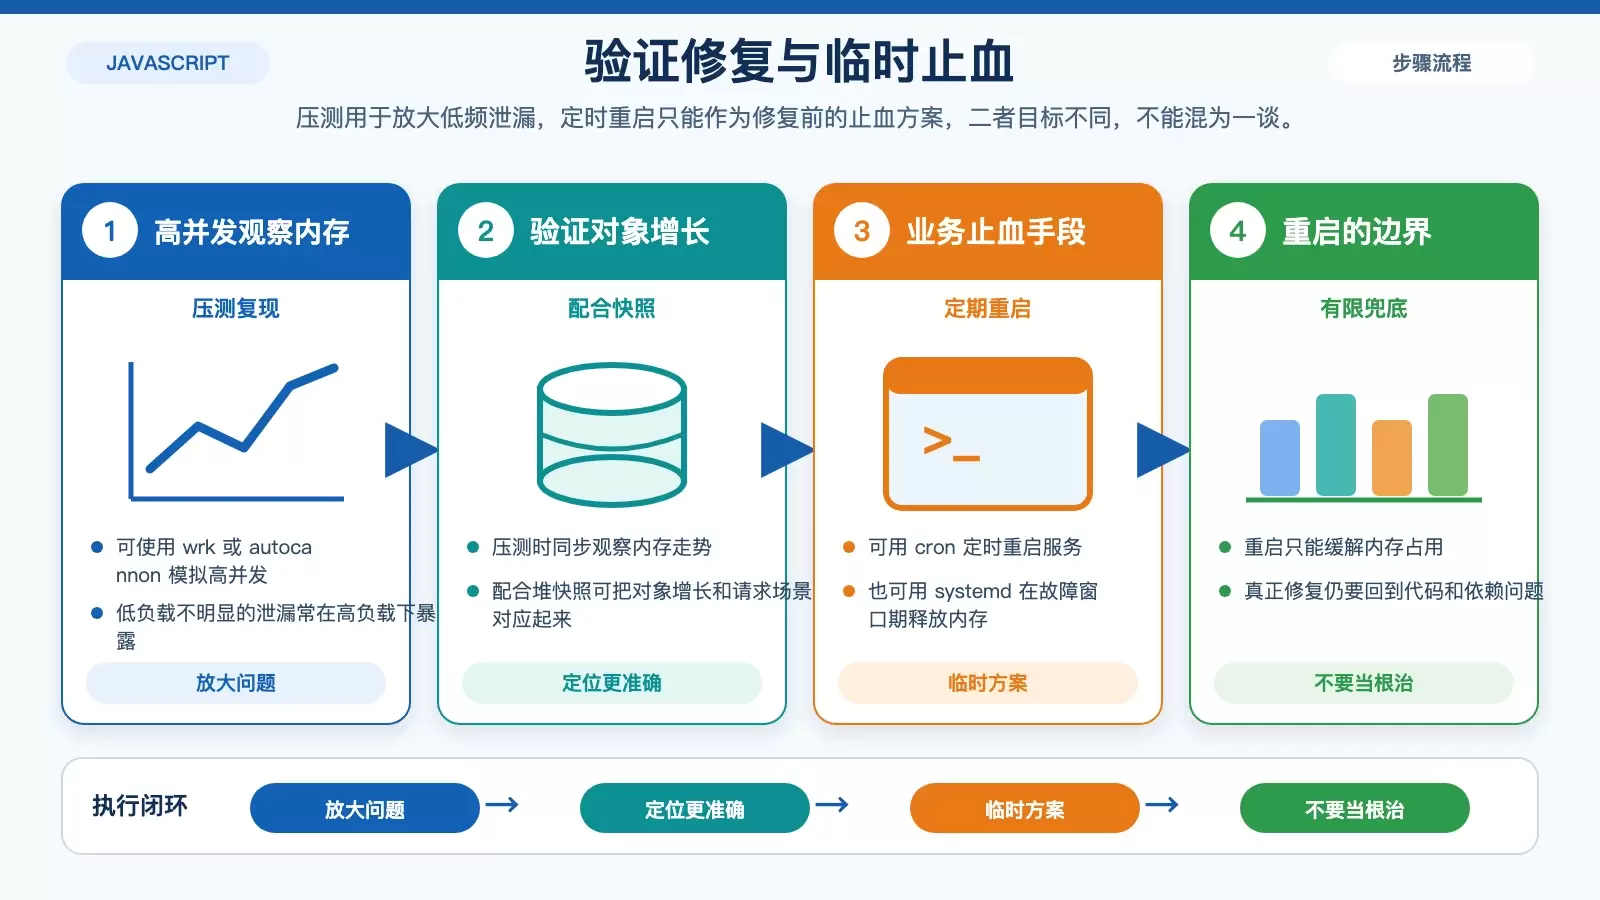
泄漏修复不能只靠“看起来好了”,还要通过高负载把问题重新逼出来。与此同时,如果线上风险已经很高,也要准备一个临时止血方案。
用压测复现低频泄漏
可以使用 wrk、autocannon 等工具模拟高并发请求,持续观察内存走势。很多泄漏在低负载下不明显,但在请求量上来之后会快速放大。
压测时如果能同步采集堆快照,通常更容易把“内存上涨”与“具体对象增长”对应起来,定位效率会更高。
修复前的临时方案:定期重启服务
如果泄漏原因短时间内还查不清,或者修复需要走完整发布流程,可以先用 cron 或 systemd 定时重启服务,强制释放内存。这当然不是根治方案,但在故障窗口期内,能先把业务稳定性保住。
排查顺序比工具堆砌更重要
Linux 上的 JavaScript 内存泄漏,大多不是靠“某个神器”一次解决,而是靠一套清晰顺序逐步收窄范围:先看内存曲线,再抓堆快照,再审查代码中的引用关系,最后用日志、依赖版本和压测结果交叉验证。绝大多数问题,最终都能落回那几个常见原因:引用没断开、对象生命周期失控,或者旧依赖里埋了已知 bug。
只要按这个顺序排查,哪怕问题一开始看起来很散,也能一步步把泄漏点揪出来。


