Rust 编译阶段能帮你挡住不少问题,但一旦进入运行时,崩溃、逻辑偏差、内存异常和性能瓶颈,往往还是要靠调试手段逐层定位。本文按“先快速观察、再深入定位、最后做验证和分析”的思路,整理 Linux 环境下几套常用 Rust 调试方法,方便你根据问题类型选择合适工具,而不是在 println!、断点和性能报告之间来回试错。
命令行调试:先用 rust-gdb 和 rust-lldb 进入现场
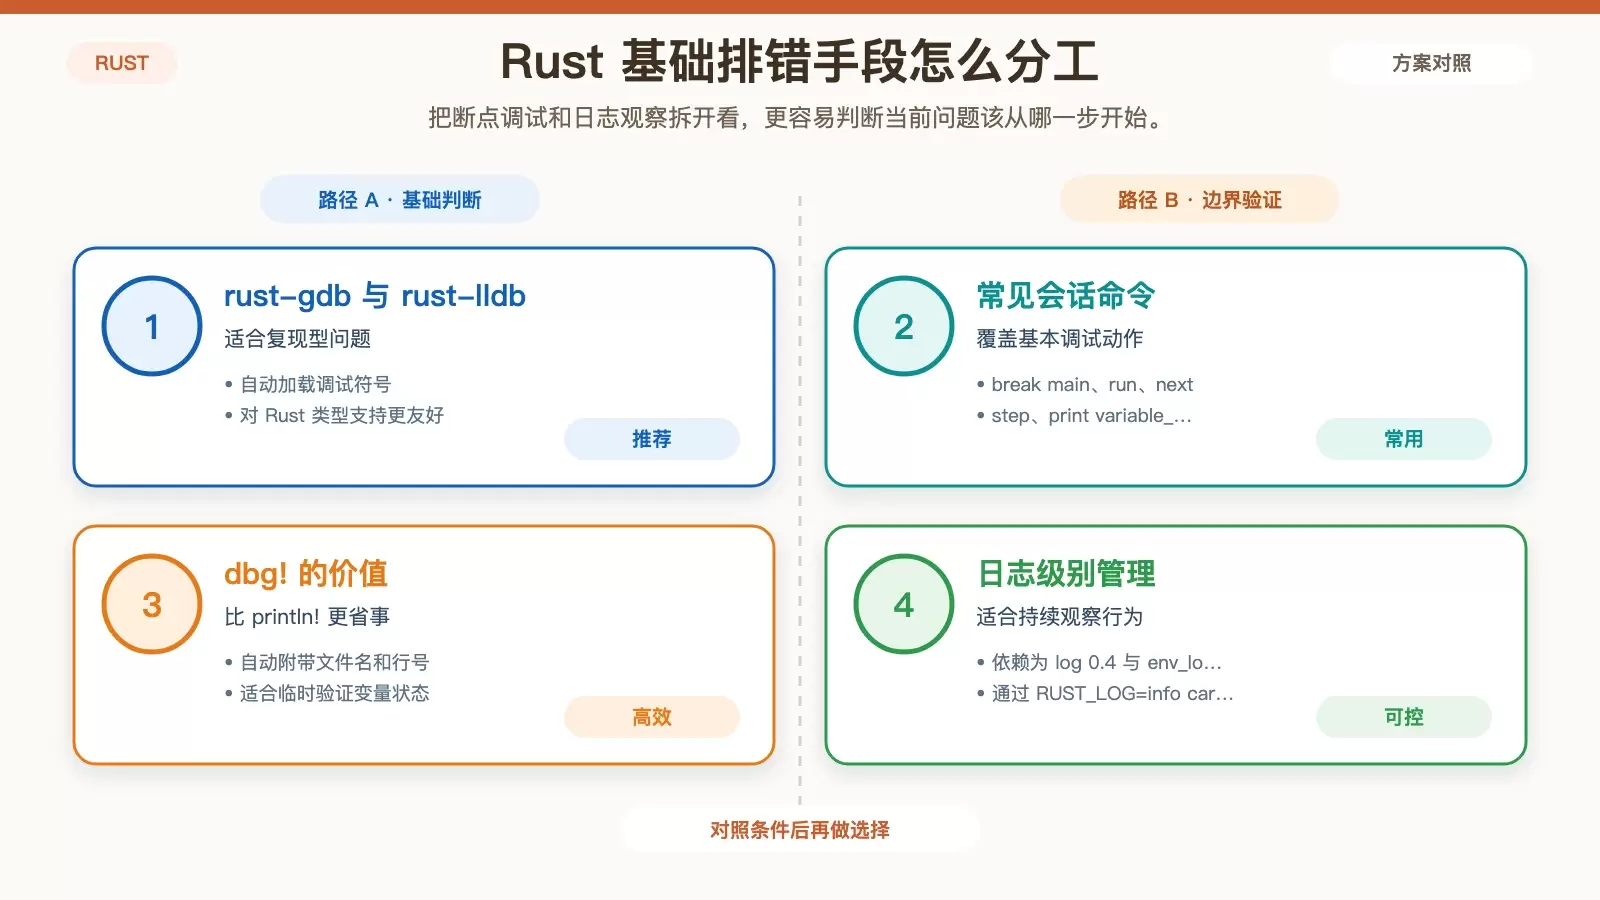
如果直接拿原生 GDB 或 LLDB 调试 Rust 程序,常见问题是符号解析不够理想,对 Rust 的结构体、枚举等类型支持也不够顺手。这时更合适的入口是 Rust 社区提供的两个包装器:rust-gdb 和 rust-lldb。
它们会自动加载调试符号,并提供更适合 Rust 项目的调试体验。先安装 GDB 和 LLDB,例如在 Ubuntu 上可以执行:
sudo apt install lldb gdb随后直接启动调试会话:
rust-gdb target/debug/your_program
rust-lldb target/debug/your_program
进入会话后,下面这些命令基本覆盖了多数基础排查场景:
break main:设置断点run:启动程序next:逐行执行step:进入函数print variable_name:查看变量值backtrace:查看调用栈
如果问题已经能稳定复现,命令行调试通常是最快的切入方式。它尤其适合定位某个函数内部状态变化、确认 panic 前最后一段执行路径,或者检查某个变量是否在预期时间点被错误修改。
快速观察程序行为:从 println! 过渡到 dbg! 和结构化日志
当你只是想先验证一个想法,println! 依然是最直接的办法。但如果你想把“临时打印”做得更高效一些,dbg! 往往更值得优先使用。
为什么 dbg! 更适合临时排查
dbg! 不只是打印变量值,还会自动附带文件名和行号,例如 [src/main.rs:2] variable = 42。这意味着你在多处插入调试输出时,不需要自己再补前缀,也更容易回头清理。
需要可控日志级别时,用 log + env_logger
如果排查已经从“临时看看变量”升级到“持续跟踪程序行为”,就应该换成更正式的日志方案。原文推荐的是 log + env_logger 组合,这套方案简单、常见,也足够应付多数服务端或命令行程序。
先在 Cargo.toml 中加入依赖:
[dependencies]
log = "0.4"
env_logger = "0.9"
然后在 main.rs 中初始化:
env_logger::init();运行程序时,通过环境变量切换日志级别:
RUST_LOG=info cargo runinfo、error、debug 等级可以按需要调整。对于不好下断点、但又需要观察多轮执行行为的问题,这种方式通常比一串零散的 println! 更容易管理。
图形界面调试:VS Code 配合 rust-analyzer 怎么配
如果你更习惯在编辑器里看断点、变量监视和调用栈,VS Code 配合 rust-analyzer 是目前比较成熟的一条路线。它适合处理分支较多、调用层次较深的逻辑问题,也方便你在多个源码文件之间来回跳转。
安装好扩展后,可以创建 .vscode/launch.json:
{
    "version": "0.2.0",
    "configurations": [
        {
            "type": "lldb",
            "request": "launch",
            "name": "Debug Rust",
            "program": "${workspaceFolder}/target/debug/your_program",
            "args": [],
            "cwd": "${workspaceFolder}"
        }
    ]
}
配置完成后,在 VS Code 左侧打开调试视图,选择 Debug Rust 即可启动。断点、变量监视和调用栈查看这些能力都能直接使用,适合在你已经知道问题大致范围,但还需要更细致地观察执行路径时介入。
把问题前移:断言和测试比事后排查更省时间
很多运行时问题,其实不必等到线上或手工测试阶段才发现。Rust 的断言和测试框架,适合把一部分逻辑错误提前拦住。
三个常用断言宏分别适合什么场景
Rust 常见的断言宏有三个:
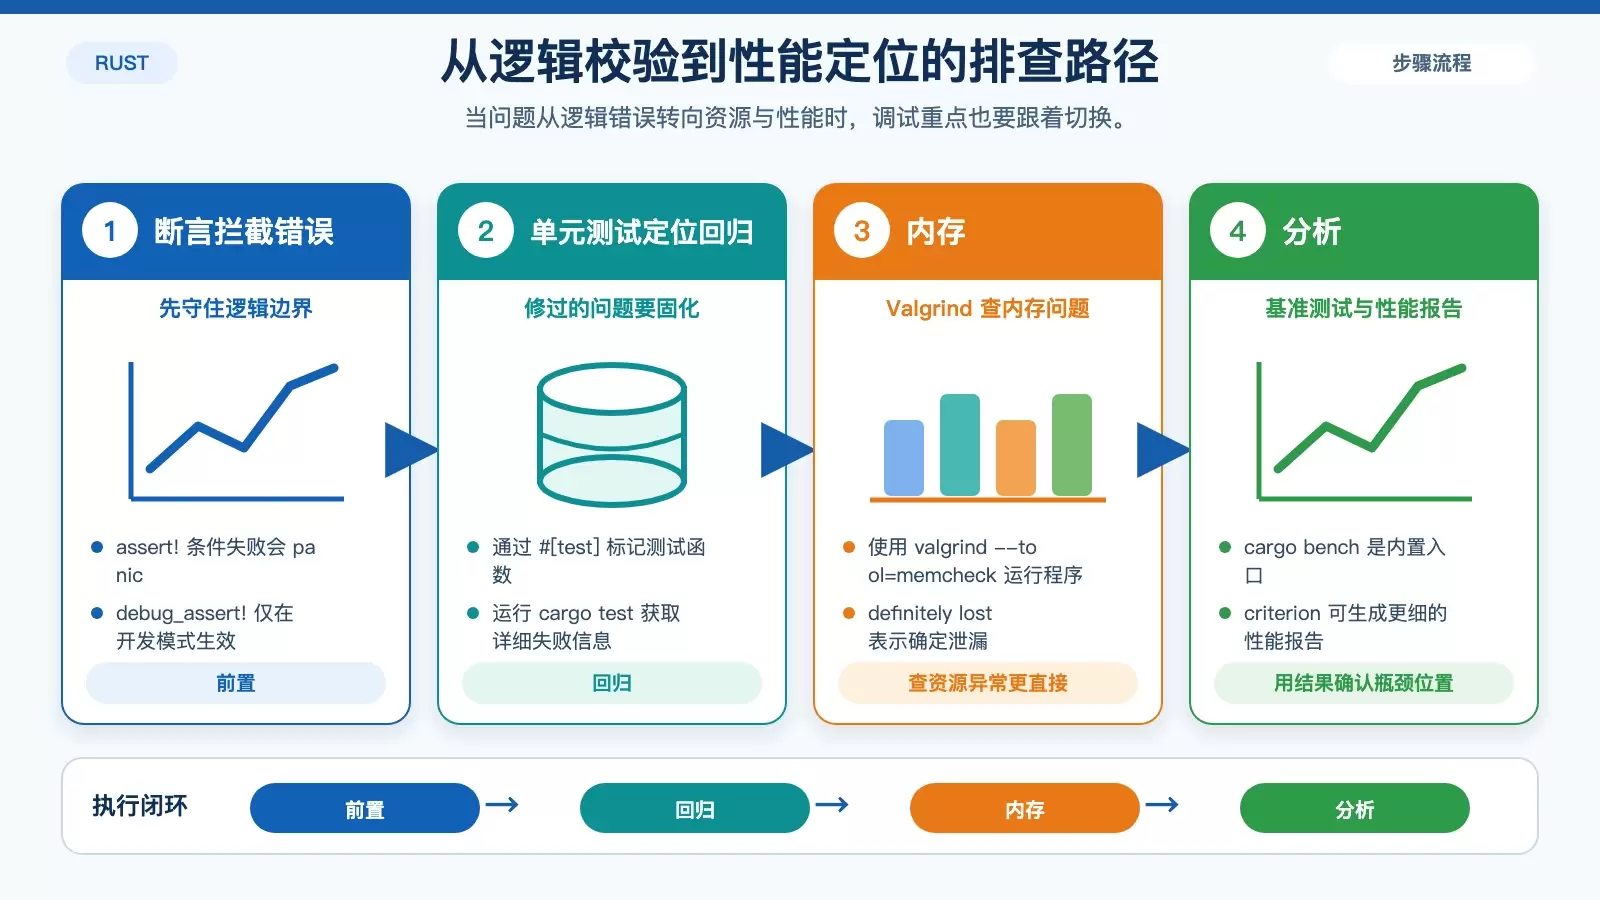
assert!:条件为假时触发 panicassert_eq!:比较两个值是否相等debug_assert!:只在开发模式下生效,不影响生产代码
例如:
fn add(a: i32, b: i32) -> i32 {
    assert_eq!(a + b, 5, "加法结果错误");
    a + b
}
这类断言适合用来守住函数的输入输出预期,尤其是在你已经明确某个条件不应该被破坏的时候。
单元测试如何配合 cargo test 定位回归问题
比断言再往前一步,就是把问题写成测试。通过 #[test] 标记测试函数后,运行 cargo test 就可以自动验证核心逻辑。测试失败时,Rust 会给出详细错误信息,通常足够你快速定位回归点。
#[cfg(test)]
mod tests {
    use super::*;

    #[test]
    fn test_add() {
        assert_eq!(add(2, 3), 5);
    }
}
如果某个 bug 修复过一次,就很适合顺手补上一条测试,防止同类问题再次出现。
遇到内存错误和性能瓶颈时,换用专项工具
并不是所有问题都适合靠断点和日志解决。内存泄漏、非法访问这类顽固问题,或者“程序没错但就是慢”的情况,往往需要专项工具。
Valgrind 适合查什么问题
针对内存泄漏、非法内存访问等问题,Valgrind 依然是 Linux 下常见的排查工具。可以直接这样运行程序:
valgrind --tool=memcheck target/debug/your_program输出结果会指出内存错误位置,例如 definitely lost 表示确定存在内存泄漏。这类报告对处理那些复现不稳定、但又确实存在资源问题的 bug 很有帮助。
性能分析时,cargo bench 和 criterion 怎么选
cargo bench 是 Rust 自带的基准测试入口;如果你需要更细的性能数据和更完整的报告,原文推荐使用 criterion。
示例基准测试代码如下:
use criterion::{criterion_group, criterion_main, Criterion};

fn bench_add(c: &mut Criterion) {
    c.bench_function("add", |b| b.iter(|| add(2, 3)));
}

criterion_group!(benches, bench_add);
criterion_main!(benches);
运行 cargo bench 后,可以借助结果判断热点到底出在算法、数据结构,还是某段调用频率过高的逻辑上。对于“功能没问题,但延迟和吞吐不达标”的情况,这一步比肉眼读代码更可靠。
需要更深的线索时,再让编译器输出更多信息
有些问题表面上像运行时故障,实际需要更多编译期上下文才能判断。这时可以考虑让 rustc 输出更详细的信息。原文提到,像 -Z verbose、-Z backtrace 这样的标志,可以帮助你看到更完整的编译信息或崩溃回溯。
示例配置如下:
[profile.dev]
debug = true
rustflags = ["-Z", "backtrace"]
这样在程序发生 panic 时,可以直接得到调用栈信息,更快追到崩溃源头。需要注意的是,这类高级选项更适合在你已经用过基础调试手段、但仍缺少关键线索时再启用,而不是一开始就全部打开。
结语:别靠猜,按问题类型选工具
Rust 调试没有单一万能方案。能稳定复现的问题,优先上 rust-gdb 或 rust-lldb;想先观察行为,用 dbg! 或日志;逻辑边界不清,就补断言和测试;遇到内存与性能问题,再切到 Valgrind 和基准测试工具。把这些方法按场景组合起来,调试过程才会从“碰运气”变成“拿证据说话”。


