Rust 本身在内存安全上有很强的约束,但这并不意味着程序就不会出现“内存长期不释放”这类问题。尤其是在 Linux 环境里,涉及全局缓存、手动分配、跨 FFI 边界或复杂生命周期时,单靠肉眼读代码往往不够。
如果你正想判断某个 Rust 程序到底有没有泄漏、泄漏发生在堆分配阶段还是业务流程里,比较稳妥的做法不是只盯着一种工具,而是按场景分层排查。下面就把几种常用路线拆开讲清楚:先用通用工具做全量检查,再用堆分析工具看变化趋势,最后回到 Rust 代码和运行时事件里做精确定位。
为什么 Rust 还需要做内存泄漏检测
Rust 的所有权和借用机制可以避免大量经典内存错误,但“没有未定义行为”不等于“没有内存泄漏”。例如:
- 对象被有意或无意地长期持有,导致堆内存持续增长;
- 使用
Box::leak、std::mem::forget或手动分配逻辑后,没有按预期回收; - 和 C/C++ 库交互时,分配与释放责任不清;
- 程序本身不是泄漏,而是存在峰值过高或长期驻留内存的问题。
也因此,排查时最好先区分你要解决的是哪一类问题:是“确定有没有泄漏”,还是“找出堆内存为什么涨”,或者“定位具体代码路径哪里没有释放”。
先用 Valgrind 做全量泄漏检查
在 Linux 平台上,Valgrind 仍然是最经典的内存调试工具之一。它的价值在于覆盖面广,不只可以看泄漏,还能辅助发现越界访问等问题,适合先做一轮基础排查。
安装 Valgrind
sudo apt-get install valgrind运行 Rust 程序
valgrind --leak-check=full target/debug/your_rust_program加上 --leak-check=full 后,Valgrind 会输出更完整的泄漏信息,包括可疑内存块的分配情况。对于“怀疑程序退出后还有未释放内存”的场景,这通常是第一步。
如果你的目标是先确认问题是否存在,而不是马上做性能级别的堆分析,那么 Valgrind 的优先级通常最高。它的缺点也很明确:运行开销较大,复杂服务型程序的分析过程会比较慢。
要看堆内存变化,重点用 heaptrack 和 massif
当问题不只是“有没有泄漏”,而是“为什么内存一直涨”或“峰值为什么这么高”时,单看泄漏报告往往不够。这时候更适合用堆分析工具去观察分配、释放和驻留趋势。
heaptrack:看分配与释放热点
heaptrack 是专门跟踪堆内存分配与释放的工具,比较适合分析哪些路径在频繁申请内存、哪些对象释放不及时。
安装 heaptrack
sudo apt-get install heaptrack运行 heaptrack
heaptrack target/debug/your_rust_program程序跑完后,可以用 hp2ps 或 kcachegrind 查看结果。它的优势不是简单给出“泄漏/不泄漏”的判断,而是把堆分配行为可视化,方便你从调用热点入手排查。
massif:看峰值和长期驻留
massif 是 Valgrind 自带的堆分析工具,特别适合用来判断内存峰值出现在哪个阶段,以及哪些内存在运行过程中长期不下降。
运行 massif
valgrind --tool=massif target/debug/your_rust_program运行完成后,可以使用 ms_print 查看结果。相比 Valgrind 的泄漏检查模式,massif 更强调“内存曲线怎么变化”,这对排查缓存膨胀、任务堆积、批处理峰值异常特别有用。
回到代码层,重点检查 std::alloc 和手动内存路径
如果工具已经提示存在可疑内存增长,下一步通常不是继续堆更多分析器,而是回到代码里看那些偏底层、偏手动的内存管理逻辑。
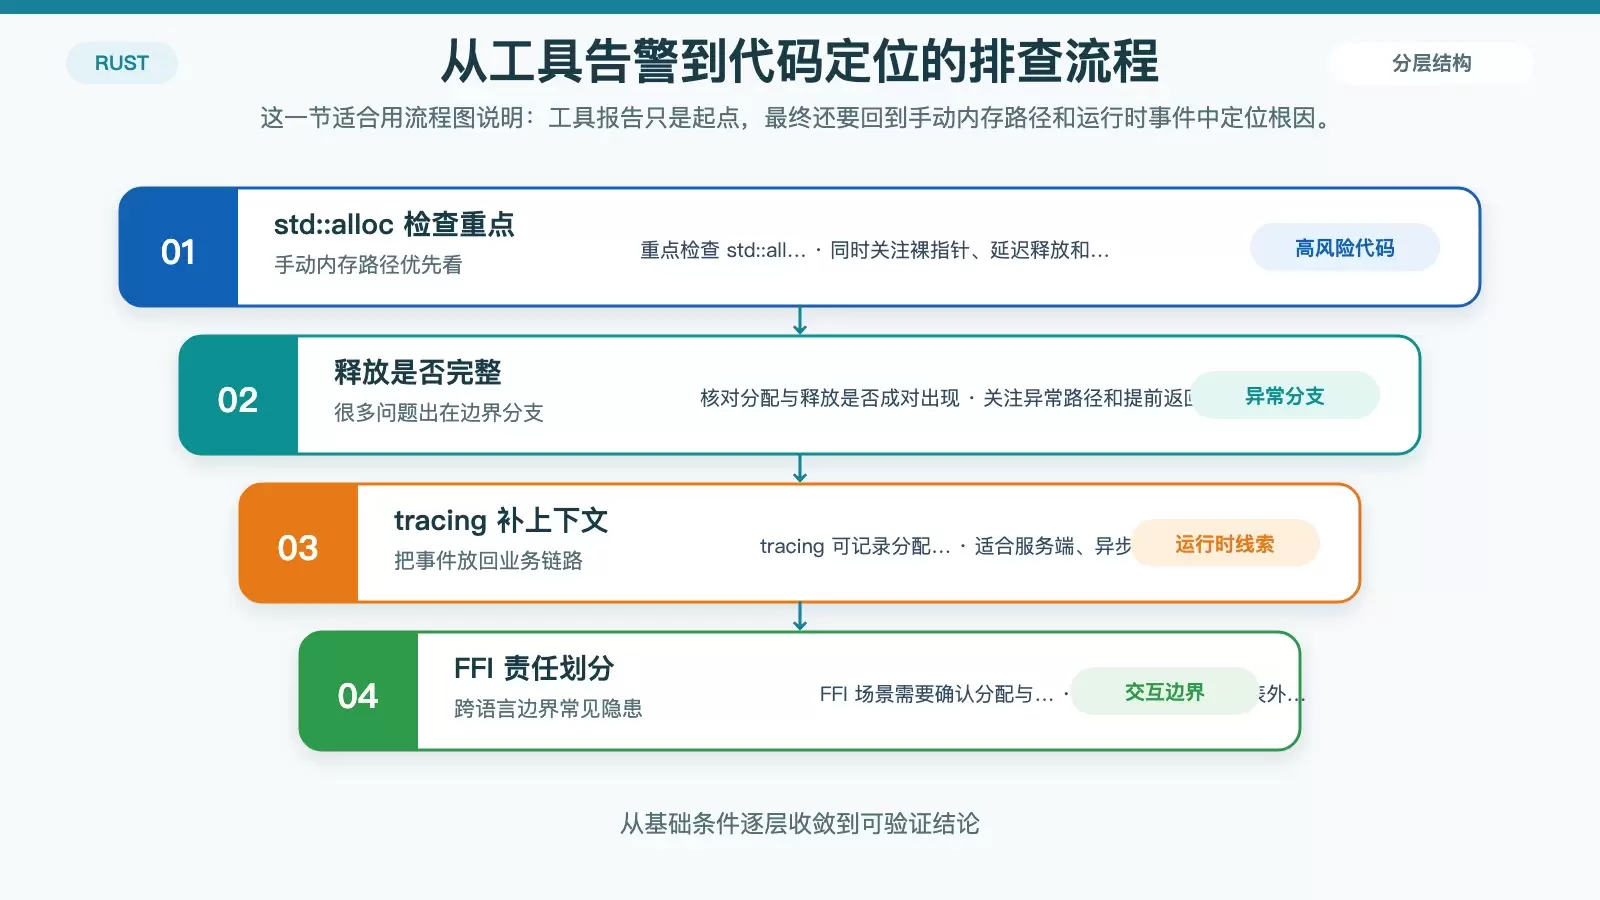
Rust 标准库提供了 std::alloc 模块,允许开发者手动管理内存。虽然大多数业务代码不会直接碰这部分,但一旦项目里用了它,排查时就需要重点关注:
- 分配和释放是否成对出现;
- 异常路径或提前返回时是否遗漏释放;
- 是否存在手动持有裸指针、延迟释放或跨模块交接所有权的情况。
这一步的核心不是“去手写更多分配代码”,而是把所有手动内存路径当成高风险区域逐一核对。很多看似“Rust 不该泄漏”的问题,最后都出在这里,或者出在 FFI 交互边界。
复杂业务场景下,用 tracing 补足运行时线索
当程序结构比较复杂,只靠离线分析结果还不足以还原现场时,tracing 很有价值。它不是传统意义上的泄漏检测器,但可以把“什么时候分配、什么时候释放、哪条业务链路触发了这些操作”串起来。
添加依赖
在 Cargo.toml 中添加:
[dependencies]
tracing = "0.1"
tracing-subscriber = "0.3"
示例代码
use tracing::{info, span};

fn main() {
    tracing_subscriber::fmt::init();
    span!(level = "info", "allocating memory");
    let _ptr = Box::new(42);
    drop(_ptr); // 显式释放内存
    span!(level = "info", "deallocating memory");
}
运行程序后查看日志输出,就能追踪分配和释放发生的时机。对服务端程序、异步任务或长生命周期进程来说,这类事件线索往往比单次运行的静态报告更有帮助。
需要注意的是,tracing 更适合“定位源头”,而不是直接替代 Valgrind、heaptrack 这类工具。它擅长补上下文,不擅长单独完成判定。
开发阶段可以用 miri 做额外检查
miri 是 Rust 的 MIR 解释器,主要用于检查未定义行为和内存安全问题。在开发期,它可以作为额外的安全检查手段,帮助提前发现一些潜在隐患。
安装 miri
rustup component add miri运行 miri
cargo +nightly miri runmiri 会执行程序并检查潜在的内存安全问题,其中也覆盖到部分内存泄漏相关场景。它更适合开发和测试阶段使用,而不是替代线上问题排查工具。
怎么选工具:按问题类型组合使用
如果只是想快速建立一套实用流程,可以直接按下面的思路选:
- 先怀疑程序存在泄漏:优先用
valgrind --leak-check=full; - 想看堆分配热点和释放情况:用
heaptrack; - 想分析内存峰值和长期驻留:用
massif; - 想把泄漏点和业务链路对应起来:加上
tracing; - 想在开发阶段补做安全检查:用
miri。
实际项目里,单一工具往往不够。比较稳妥的路线通常是:先用 Valgrind 判断问题是否成立,再用 heaptrack 或 massif 看堆行为,最后回到 std::alloc、FFI 和业务路径里结合 tracing 精确定位。这样既能减少误判,也更容易把分析结果落到具体代码修改上。


