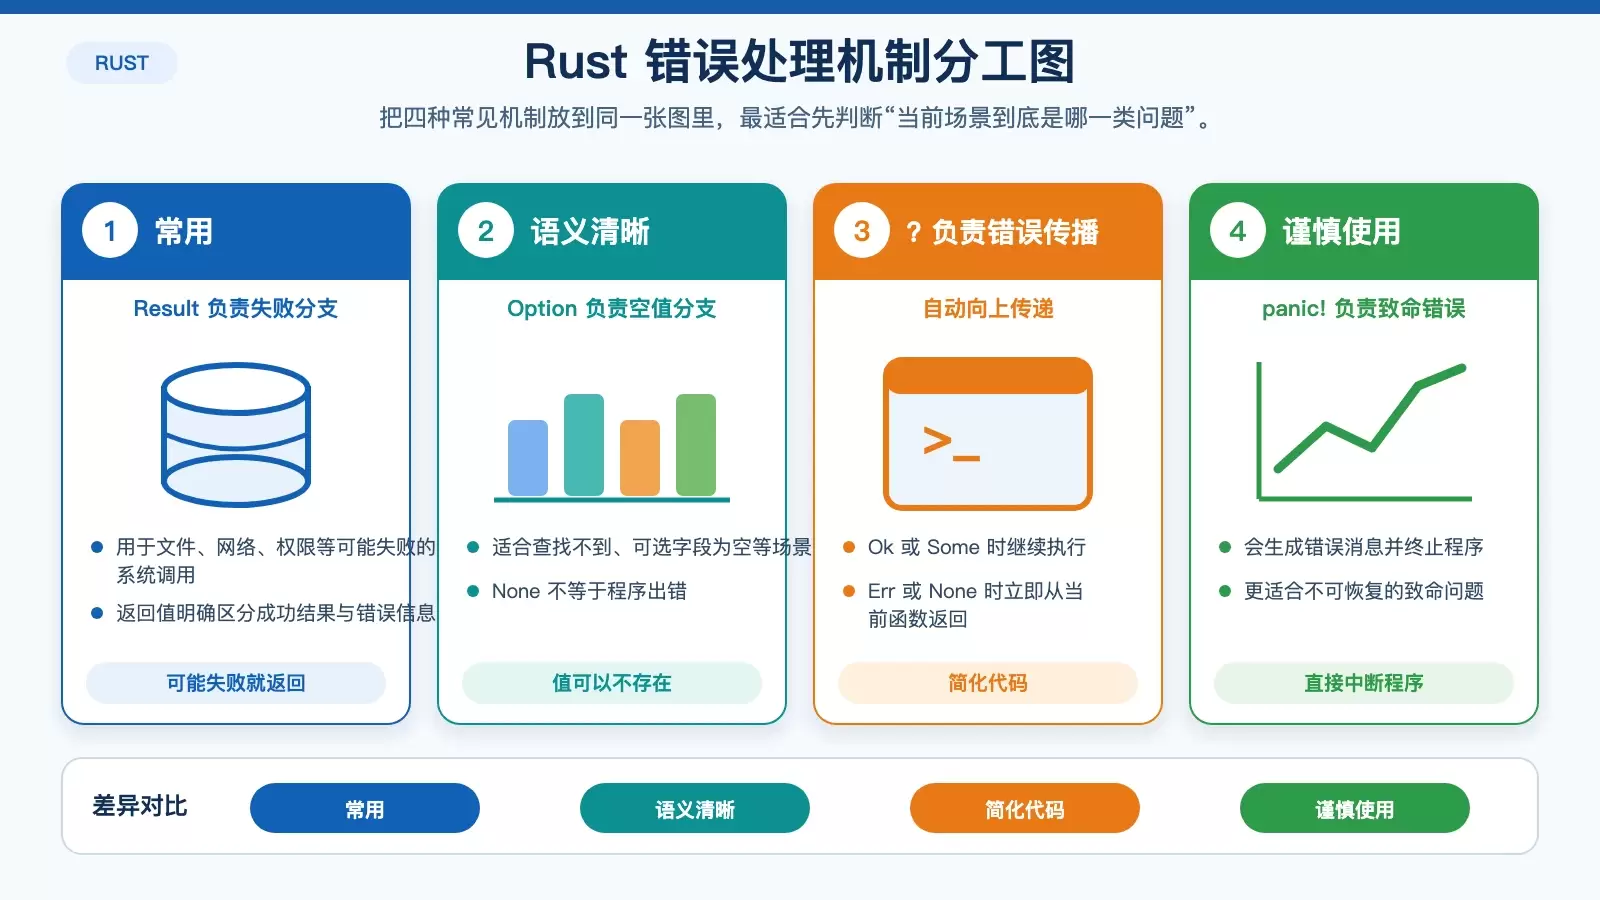
在 Linux 上写 Rust,最常见的不是“怎么捕获异常”,而是“这个错误到底该返回、忽略,还是直接终止程序”。Rust 没有把这件事藏在运行时,而是要求你在类型层面说清楚:可能失败就用 Result,可能不存在就用 Option,确实无法恢复时再考虑 panic!。顺着这几个工具的分工来看,你会更容易判断一段后端代码该怎么写,既不丢错误信息,也不过度中断程序。
Result:处理真正可能失败的操作
在 Rust 里,凡是“操作可能失败,但失败本身是正常情况”的场景,通常都应该返回 Result。它是一个枚举,包含两个变体:Ok(T) 和 Err(E)。
这类设计在 Linux 环境里尤其常见,因为文件读写、网络请求、权限检查等系统调用,本来就可能因为路径不存在、权限不足或资源不可用而失败。Rust 标准库已经把这些情况包装成了返回值,而不是留给运行时兜底。
fn read_file(path: &str) -> Result {
    std::fs::read_to_string(path)
}
这段代码的重点不是“怎么读文件”,而是函数签名已经明确告诉调用方:读取成功时会得到 String,失败时会得到 std::io::Error。调用者必须处理这个分支,代码行为也因此更可预期。
Option:处理值可能不存在的情况
不是所有“拿不到结果”的情况都应该算错误。很多时候,程序只是遇到了一个“没有值”的正常分支,这时更适合用 Option。
Option 同样是枚举,只有两个变体:Some(T) 和 None。它强调的不是“执行失败”,而是“结果可能为空”。
fn find_element(arr: &[i32], value: i32) -> Option {
    arr.iter().position(|&x| x == value)
}
这里查找数组元素时,如果没找到,返回 None 就足够了。因为“找不到”并不一定代表程序异常,更像是一种业务上允许出现的结果。把这种场景和 Result 区分开,代码语义会更清楚。
操作符:把错误传播写得更直接
当函数内部连续调用多个可能失败的操作时,手动写 match 会很快变得冗长。Rust 提供的 操作符,就是用来简化这类错误传播的。
它可以接在 Result 或 Option 后面使用:
- 如果值是
Ok或Some,继续向下执行,并取出内部值; - 如果值是
Err或None,则立即从当前函数返回对应结果。
fn read_file_and_process(path: &str) -> Result<(), std::io::Error> {
    let content = read_file(path);
    println!("File content: {}", content);
    Ok(())
}
这类写法在 Linux 后端程序里非常常见,尤其适合文件处理、配置加载、套接字读写等链式操作。它的价值不只是少写几行代码,更重要的是保留了错误向上传递的路径,同时避免把主逻辑埋进一层层分支里。
panic!:只留给无法恢复的致命错误
panic! 和前面几种机制最大的区别在于:它不是把错误交给调用者处理,而是直接终止当前程序。
因此,panic! 更适合那些“继续运行已经没有意义”的场景,比如严重的内部状态错误、违反程序核心假设,或者明确希望在开发阶段尽早暴露问题。
fn main() {
    match read_file("nonexistent.txt") {
        Ok(_) => println!("File read successfully"),
        Err(e) => panic!("Error reading file: {}", e),
    }
}
不过,如果这是一个面向用户的命令行工具、服务端程序,或者需要长期运行的 Linux 进程,那么遇到普通 I/O 错误就直接 panic!,通常并不是最稳妥的选择。更常见的做法是返回错误、记录日志,或者在边界层统一处理,而不是让整个进程直接退出。
Linux 环境下怎么选更合适
把这几种机制放回实际开发场景里,选择会更容易判断:
- 文件、网络、权限、系统调用可能失败:优先用
Result; - 数据可能不存在,但这属于正常分支:优先用
Option; - 函数只是把失败继续上抛:优先配合
简化传播; - 程序状态已经不可恢复,继续运行会带来更大问题:再考虑
panic!。
Rust 标准库已经为大量 Linux 常见操作提供了基于 Result 的接口,所以很多时候你不需要自己发明错误模型,只要顺着标准库的返回类型继续组织代码即可。
再进一步:thiserror 和 anyhow 适合用在什么地方
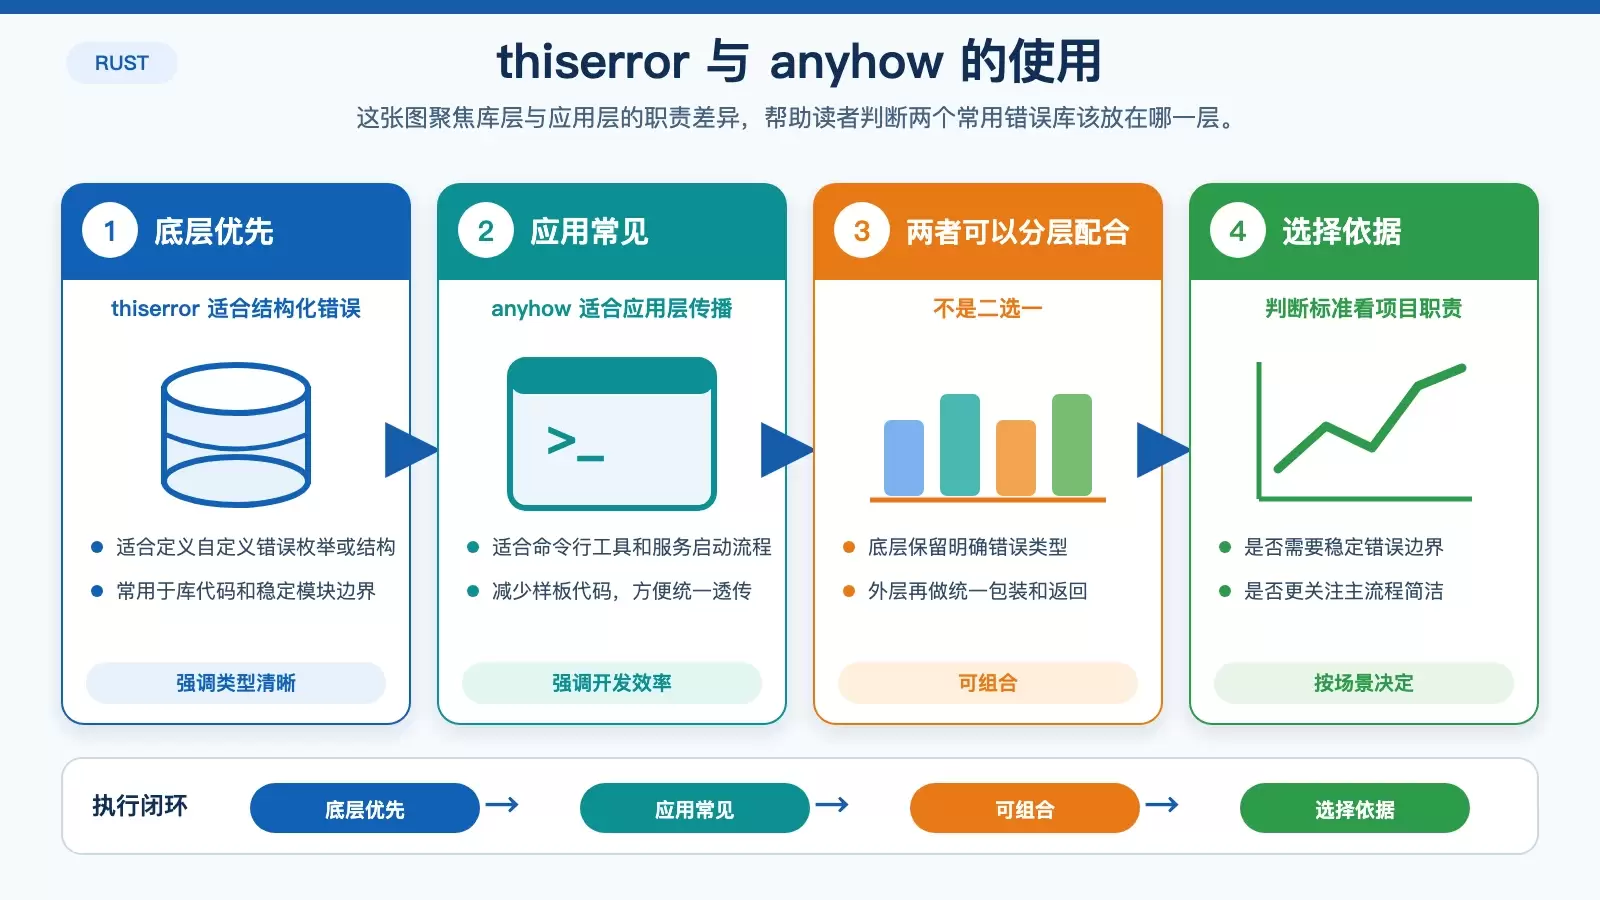
当项目规模继续扩大,只靠标准库错误类型往往不够用,这时社区常见的两个库就会派上用场:thiserror 和 anyhow。
thiserror:更适合定义清晰的自定义错误类型,常用于库代码或需要稳定错误边界的模块;anyhow:更适合应用层快速组织错误传播,减少样板代码,常见于命令行工具、服务启动流程等场景。
两者并不是互斥关系。很多 Rust 项目会在底层库中用 thiserror,在最外层应用入口用 anyhow 做汇总和透传,这样既保留结构化错误信息,也能保持主流程简洁。
小结
Rust 的错误处理并不是单纯替代异常机制,而是把“失败是否正常、值是否存在、错误是否可恢复”这几类问题拆开处理。对 Linux 开发来说,这种方式和系统调用的天然不确定性很契合。
如果只记一条经验,可以把它概括为:能预期的失败用 Result,可能为空的返回用 Option,向上传递时用 ,确实没法继续时才用 panic!。这个边界划清楚之后,Rust 代码通常会同时变得更稳、更容易维护。


