Rust 项目跑在 Linux 上时,性能问题往往不是单点造成的:有些损耗来自编译配置,有些埋在数据结构和并发写法里,也有些其实卡在操作系统默认限制上。与其一开始就改大段业务逻辑,更稳妥的做法是按“编译器、代码、系统、分析工具”四个层面逐步排查,并用实际测量结果判断每一步是否值得保留。
下面这份清单适合用作一次完整的性能梳理流程。你可以先从最容易验证的构建参数入手,再处理热点代码和系统瓶颈,最后用剖析工具确认优化是否真正生效。
先把编译器优化吃满
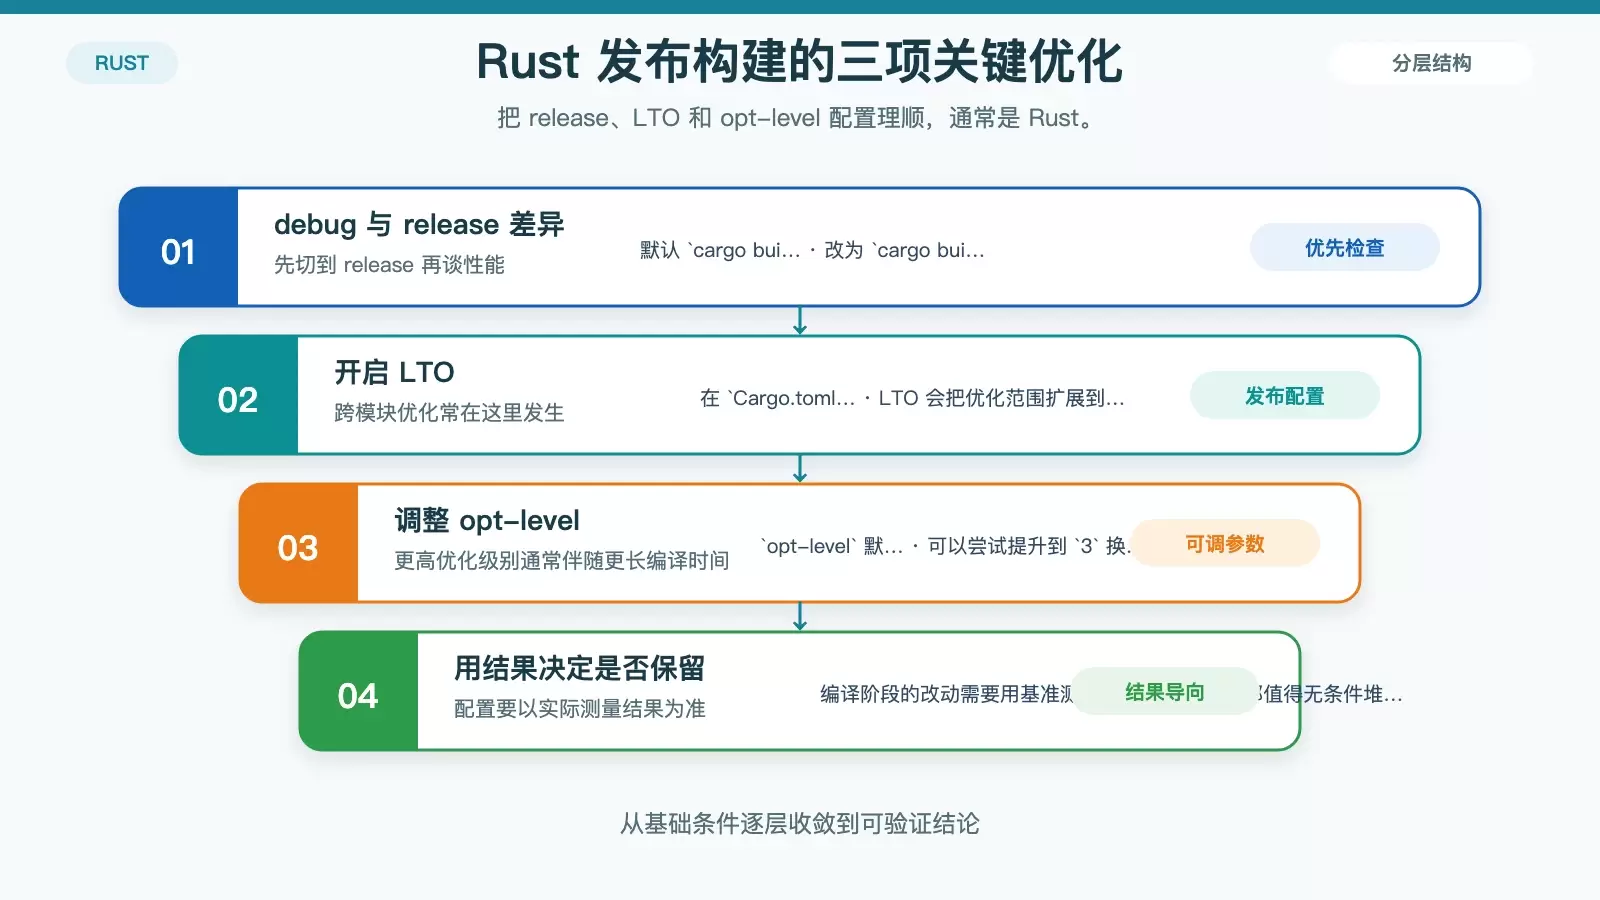
很多 Rust 程序在开发阶段表现一般,并不是算法有问题,而是压根还没有使用面向生产环境的编译配置。上线前,至少要先确认下面三项。
1. 默认构建别停留在 debug
cargo build默认使用 debug 模式,会保留调试信息且基本不开性能优化。对 CPU 密集型任务来说,debug 和 release 的差距通常非常明显。
cargo build --release如果你还在用 debug 结果评估程序快慢,得到的结论大概率会偏差很大。
2. 在发布配置中开启 LTO
LTO(链接时优化)会把优化范围从单个模块扩展到链接阶段,适合跨模块调用较多的项目。常见做法是在 Cargo.toml 的 [profile.release] 中加入:
[profile.release]
lto = true
这类配置通常会增加编译时间,但能换来更好的最终执行效率,尤其适合稳定发布版本。
3. 视情况把 opt-level 从 2 提到 3
opt-level 默认是 2。如果你更关注运行性能而不是编译速度,可以继续上调到 3:
[profile.release]
opt-level = 3
是否值得这样做,取决于你的构建时长是否还能接受,以及基准测试是否确实带来了收益。
代码层面优先处理热点路径
编译器优化解决的是“已有代码怎么生成得更好”,而决定上限的仍然是代码本身。真正有体感的性能提升,通常来自高频路径上的细节处理。
减少重复分配和扩容
频繁扩容会带来额外的内存分配与数据拷贝。对于容量可预估的场景,优先使用 Vec::with_capacity 和 String::with_capacity 提前分配空间。
这类优化在循环构造结果集、批量拼接字符串、日志聚合等高频代码里尤其有效。
优先使用迭代器和闭包表达计算
Rust 的迭代器并不只是“写法更简洁”。在很多情况下,编译器更容易对迭代链做内联、向量化和其他优化,实际效果可能优于手写循环。闭包也有助于减少额外的函数调用开销。
这里的关键不是盲目把所有循环改成链式写法,而是优先在热点计算路径上比较哪种表达方式更利于编译器优化。
热点区尽量降低锁竞争
如果热点代码大量依赖 Mutex 或 RwLock,线程之间就可能因为争锁产生上下文切换,吞吐量和延迟都会明显变差。能用 Atomic 类型或无锁数据结构解决的问题,尽量不要交给粗粒度锁。
特别是在多线程计数、状态位同步、任务队列等场景里,锁竞争往往比单次计算本身更贵。
只在可控边界内使用 unsafe
unsafe 的确可能绕开一部分安全检查,换来额外性能,但它不该成为常规优化手段。更合适的做法是:只有在收益明确、边界清晰、可验证的场合才使用 unsafe,并把作用范围压到最小。
同时要写清楚注释,说明这里依赖了什么前提。性能优化不能以破坏可维护性和内存安全为代价。
把并行模型和任务类型对上
多核机器上,单线程程序通常很难把硬件吃满。数据并行任务可以考虑 rayon,异步 I/O 或高并发服务则更适合 tokio 或 async-std。
重点不在于“用了并行就一定更快”,而在于任务是否足够独立、拆分成本是否低,以及同步开销会不会反过来抵消收益。
系统层面的瓶颈也要一起看
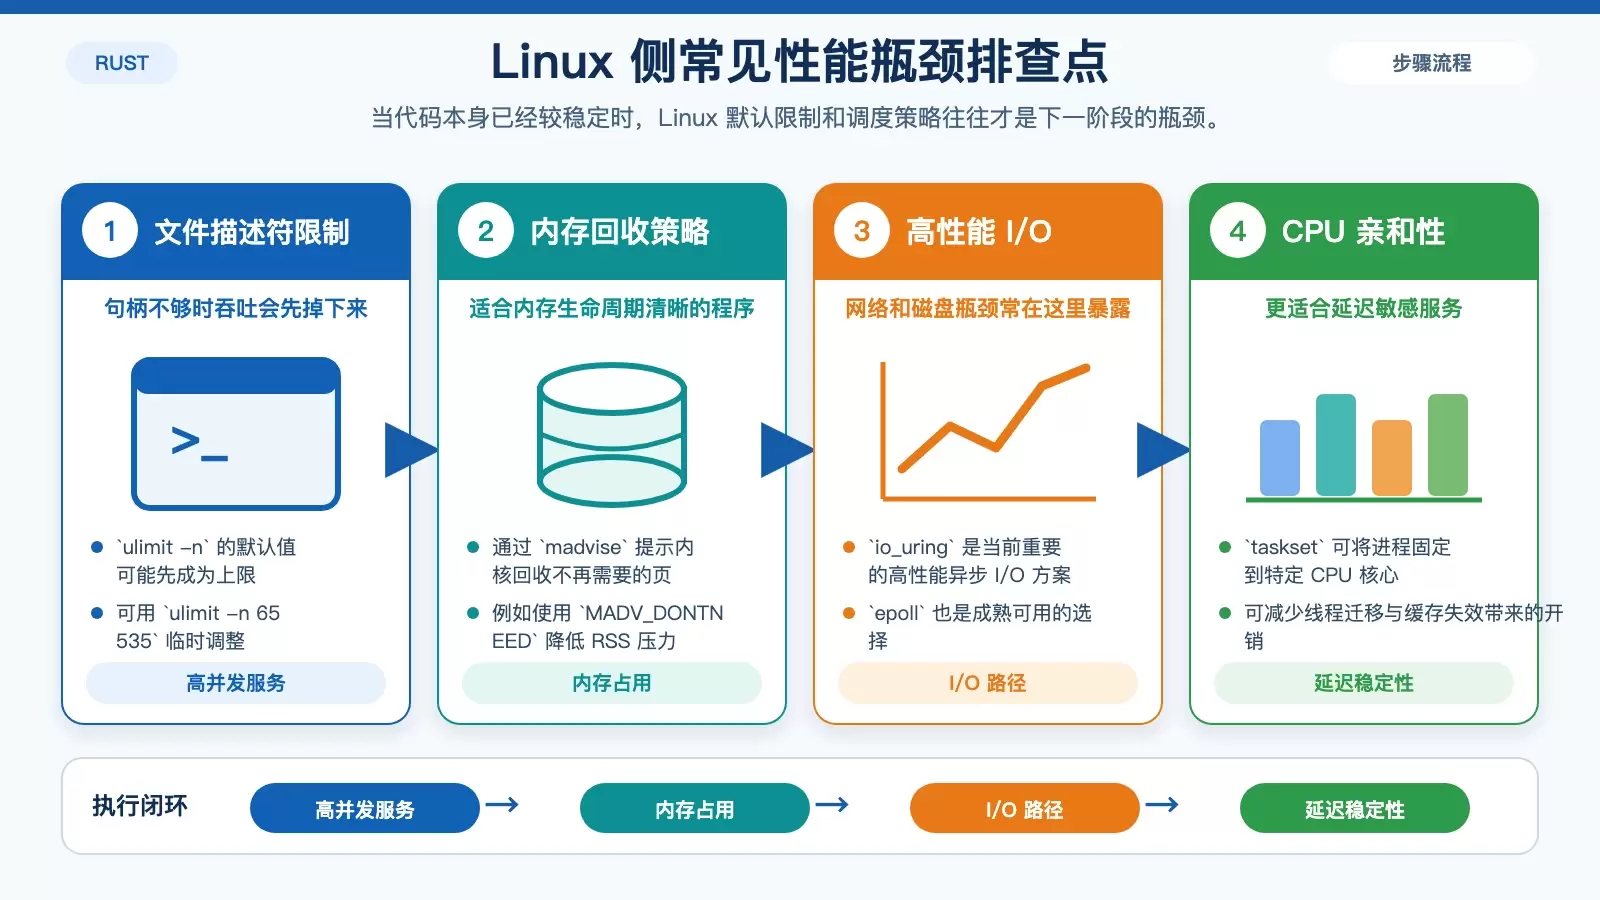
当代码和编译参数都已经调整过后,性能问题可能并不在 Rust 本身,而是 Linux 默认配置限制了程序发挥。下面几项在服务端场景中很常见。
文件描述符上限别拖后腿
高并发服务容易先撞上 ulimit -n 的默认值。临时调整可以直接执行:
ulimit -n 65535如果需要长期生效,则应在 /etc/security/limits.conf 中做永久设置。对于连接数多、文件句柄占用高的服务,这一步经常是必要条件。
用 madvise 改善内存回收策略
某些内存区域在阶段性使用后,可以通过 madvise 告诉内核这些页不再需要,例如使用 MADV_DONTNEED。这样做有机会降低 RSS 占用,减轻整体内存压力。
这更适合对内存布局和生命周期有清晰控制的程序,而不是所有应用都应该默认启用的技巧。
I/O 模型尽量靠近 Linux 的高性能路径
在 Linux 上,io_uring 是当前非常重要的高性能异步 I/O 方案,epoll 也是成熟可靠的选择。对于高吞吐或高并发程序,尽量避免阻塞式读写长期占住线程。
如果瓶颈集中在网络或磁盘访问,切换 I/O 模型往往比单纯微调 Rust 语法更有效。
延迟敏感场景可以绑定 CPU 核心
线程频繁迁移会带来缓存失效与调度开销。对延迟敏感的服务,可以用 taskset 将进程固定到特定 CPU 核心,减少线程漂移:
taskset这类策略对稳定延迟分位值通常比对峰值吞吐更有帮助,适合结合监控数据评估效果。
没有测量,优化就没有依据
性能优化最容易犯的错,是凭感觉修改代码。更可靠的流程是先定位热点,再选择手段,最后重新验证。Linux 和 Rust 生态里已经有足够好用的工具。

perf:先确认热点到底在哪里
perf 是 Linux 自带的性能分析工具,适合先做整体摸底。
perf record
perf report
通过 perf record 采样、再用 perf report 查看热点,可以快速判断问题更像是 CPU 消耗、函数热点,还是内存访问带来的停顿。
valgrind / callgrind:把函数调用成本摊开看
valgrind 不只用来查内存泄漏。借助 callgrind,你还可以分析函数调用关系和时间消耗,找出到底是哪一层调用堆叠把性能拉低了。
这类工具适合做更细粒度的函数级分析,尤其在逻辑复杂、调用链较深时很有帮助。
cargo flamegraph:用火焰图看清调用堆栈
cargo flamegraph 可以直接生成火焰图,把调用频率和热点堆栈可视化。相比纯文本报告,它更适合快速识别“最大的火苗”到底在哪一层。
当你已经知道程序慢,但还不知道是哪个调用路径最值得下手时,火焰图通常是很高效的入口。
把优化当成一个可验证的循环
Rust 在 Linux 上的性能优化,最有效的方式不是一次性堆满所有技巧,而是按顺序迭代:先测量,再调整编译配置;接着处理热点代码;必要时再深入系统层;最后回到工具验证结果。
只要这个循环跑通,你就能更清楚地区分哪些改动是真提升,哪些只是增加了复杂度。对生产项目来说,这比单纯追求“更快”更重要。


