先看系统日志:判断是不是 Linux 层面先出了问题
先按崩溃时间对齐系统事件,确认是否有内核、驱动、磁盘、内存或服务异常。
/var/log/syslog
/var/log/messages
dmesg
优先搜异常、错误、警告及进程退出记录。
应用日志才是主战场:先确认 Node.js 项目把日志写到了哪里
若是 Node.js 服务,先确认日志输出位置、轮转方式、日志级别,重点看是否保留错误栈。常见方案有 winston、morgan,并确认日志写到文件、标准输出还是集中日志系统。
跑在 Apache 或 Nginx 后面时,要把访问日志和错误日志对着看
对照访问日志与错误日志,判断请求是否到达、返回的是 500、502、504 还是其他状态,并区分失败发生在反向代理、应用处理还是上游通信。

别忽略浏览器控制台:很多运行时错误第一时间就暴露在这里
前端问题先开开发者工具:按 F12 或右键“检查”,查看 Console。重点排查运行时错误、资源加载失败、接口异常后的前端报错,以及资源路径、跨域、依赖加载问题。
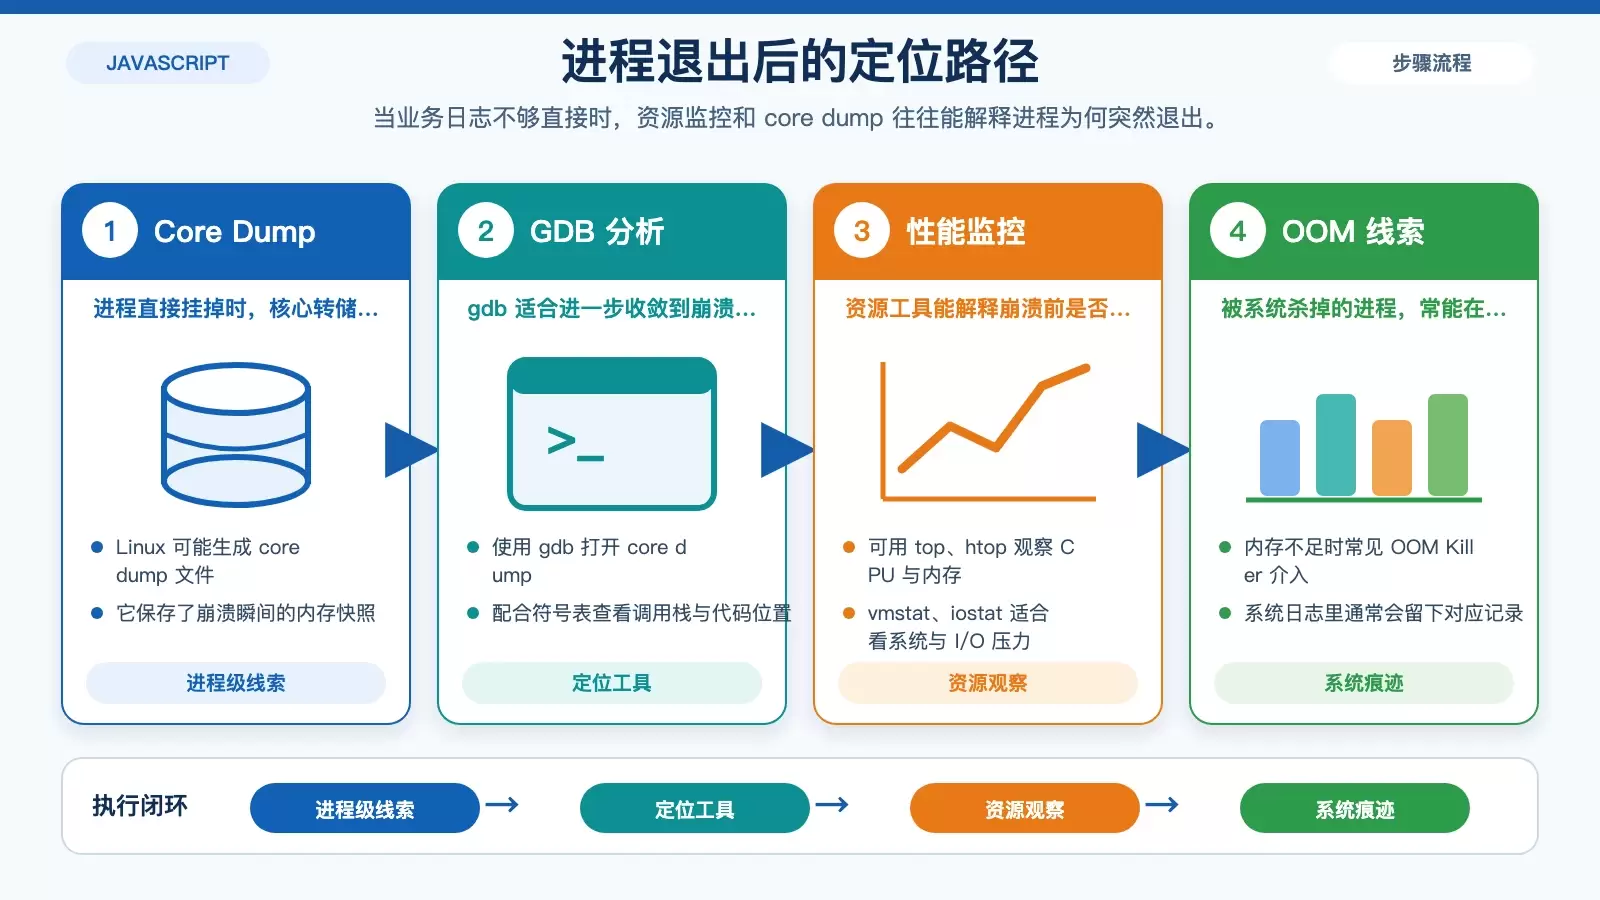
进程直接挂掉时,可以用 core dump 做“事后取证”
若进程直接退出且普通日志不足,检查 core dump。它能保留崩溃瞬间状态,适合排查进程级崩溃或底层依赖异常。可用 gdb 查看调用栈和崩溃位置。
gdb资源监控能解释“为什么脚本会被系统杀掉”
若没有明确业务报错但进程反复退出,检查资源争抢:
top
htop
vmstat
iostat
重点看内存飙升后被 OOM Killer 杀掉、CPU 打满导致超时、I/O 阻塞拖垮响应,并与系统日志交叉验证。
接入 Sentry、Rollbar 之类服务时,优先利用现成的错误上下文
若已接入 Sentry、Rollbar,先看崩溃时间、错误消息、堆栈、请求上下文、用户环境、版本信息和出现频率,再回查 Linux 同时段日志确认是否伴随系统异常。
最后的排查方法:一切都围绕时间戳和关键词收敛
完整步骤:先确定崩溃时间,再依次对照系统日志、应用日志、Web 日志、浏览器 Console、core dump、资源监控和错误追踪服务。优先关注异常、错误、警告、进程退出、重启、超时、OOM、磁盘、驱动、网络波动等关键词,最终收敛到先出错的层级。


