在 CentOS 做 Java 开发时,编译慢往往不是工具太复杂,而是默认流程没有把多核 CPU 用起来。本文按“环境准备、Makefile 组织、并行参数选择、编译后验证”四步展开,保留可直接复用的命令和示例,帮助你快速判断:你的项目是否适合用 make -j N 来换取更短的构建时间。
先把编译环境准备好
要在 CentOS 上用 make 驱动 Java 编译,至少需要 make 和 javac。如果系统还没安装,可以直接执行下面这条命令:
sudo yum install make java-1.8.0-openjdk-devel这里使用的是 OpenJDK 8 开发包,也就是 java-1.8.0-openjdk-devel。如果你的项目依赖其他 JDK 版本,包名需要替换成对应版本。这个步骤的重点不是固定用哪一版,而是确保系统里同时具备编译器和构建工具。
用 Makefile 管理 Java 编译流程
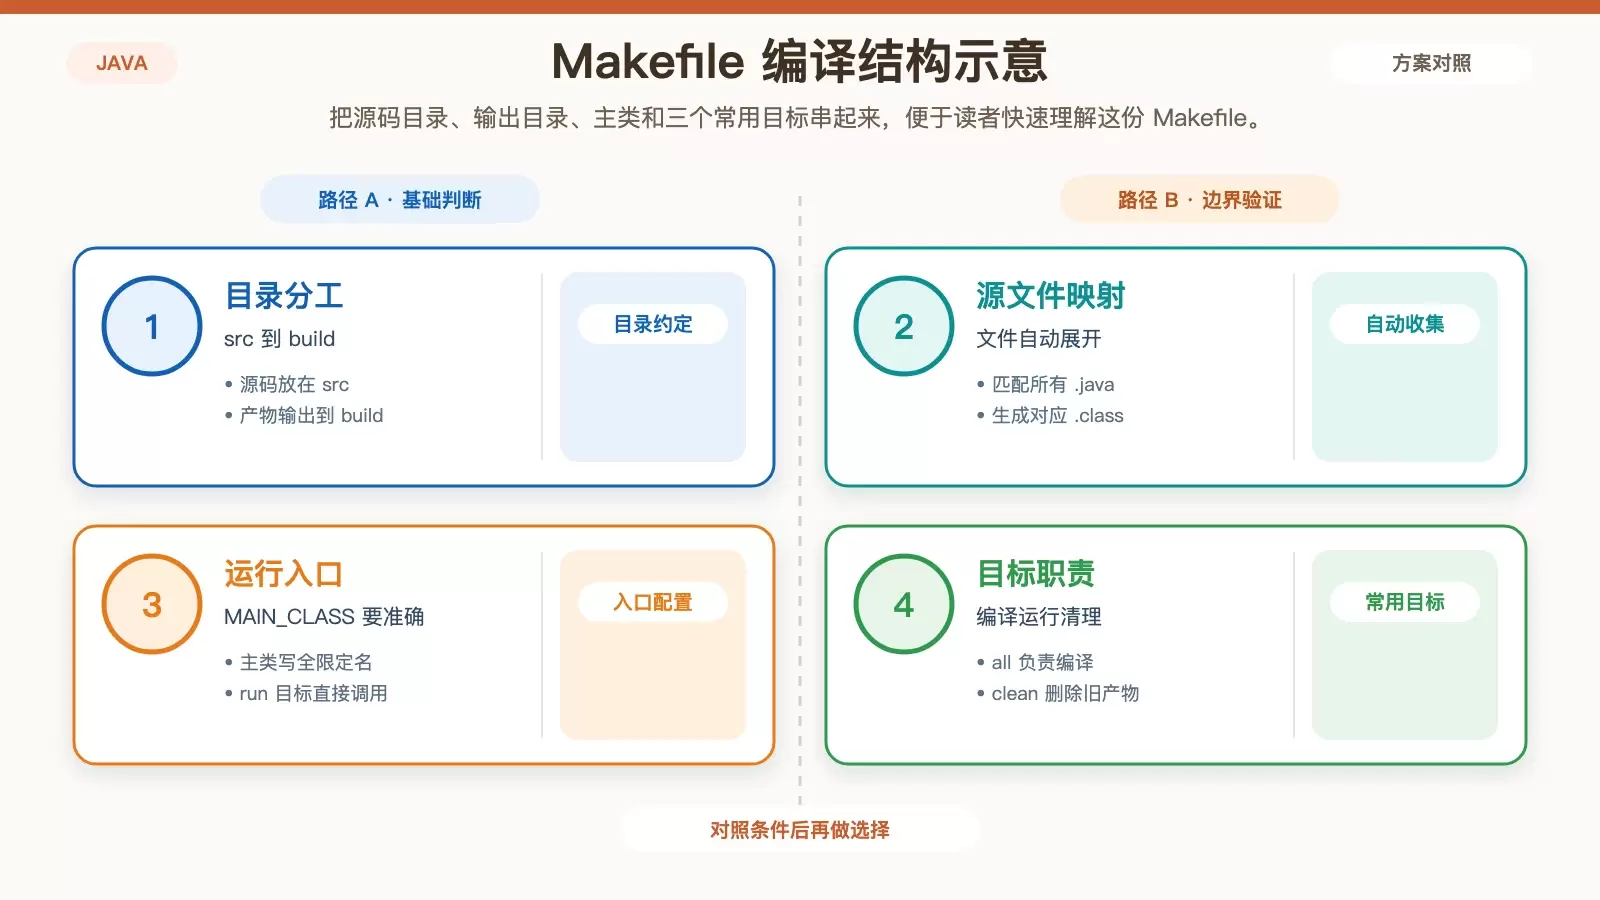
make 本身不会主动识别 Java 项目结构,它需要通过 Makefile 知道源码在哪、输出到哪、运行哪个主类。对于一个源文件放在 src、编译结果输出到 build 的简单项目,可以先用下面这个示例:
# 定义Java源文件目录和目标目录
SRC_DIR = src
BUILD_DIR = build

# 定义Java源文件
SRC_FILES = $(wildcard $(SRC_DIR)/*.java)

# 定义目标类文件
CLASS_FILES = $(patsubst $(SRC_DIR)/%.java, $(BUILD_DIR)/%.class, $(SRC_FILES))

# 定义主类
MAIN_CLASS = com.example.Main

# 编译选项
JAVA_COMPILE_OPTS = -d $(BUILD_DIR) -sourcepath $(SRC_DIR)

# 默认目标
all: $(CLASS_FILES)

# 编译规则
$(BUILD_DIR)/%.class: $(SRC_DIR)/%.java
	javac $(JAVA_COMPILE_OPTS) $< -o $@

# 运行主类
run: all
	java -cp $(BUILD_DIR) $(MAIN_CLASS)

# 清理目标
clean:
	rm -rf $(BUILD_DIR)
这份配置做的事情并不复杂,但足够支撑一套基础流程:
这个 Makefile 解决了什么问题
它会自动收集 src 目录下的 .java 文件,按规则生成对应的 .class 文件,并统一输出到 build 目录。这样做的好处是,后续你不需要手工一条条写编译命令,而是把编译、运行、清理都收敛到固定入口。

你需要改哪些地方
最关键的是 MAIN_CLASS,它必须改成你项目里实际的主类全限定名,否则 make run 阶段无法正确启动程序。除此之外,如果源码目录不是 src,或者输出目录不是 build,也需要同步调整 SRC_DIR 和 BUILD_DIR。
真正提速的关键:使用 make -j 并行编译
环境和规则准备好之后,真正决定速度提升的,就是 -j 参数。执行方式很直接:
make -j 4这里的 4 表示同时启动 4 个并行任务,让多个编译动作一起运行,而不是串行排队。对多核机器来说,这通常比默认单线程构建更能发挥硬件能力。
线程数应该怎么选
并行数并不是越大越好。原理上,它应该接近 CPU 的逻辑核心数。比如:
- 4 核 8 线程的机器,可以尝试
-j 8 - 8 核 16 线程的机器,可以尝试
-j 16 - 不确定机器规格时,可以先参考
nproc的输出结果
如果把数值设得远高于逻辑核心数,系统会把更多时间花在线程调度和上下文切换上,性能不一定继续上涨,反而可能下降。所以比较稳妥的做法,是从 CPU 核心数或略高一点的值开始试。
这种方法适合什么场景
并行编译在源文件数量上来之后更容易体现价值。原文给出的经验是,项目有几十个源文件时,编译时间可能从十几秒缩短到几秒。具体提升幅度会受 CPU、磁盘、依赖关系和项目结构影响,但如果你现在的瓶颈就是“文件多、编译排队长”,那 make -j N 往往是成本很低的一步优化。
编译完成后怎么运行和验证
构建结束后,可以直接用下面的命令验证结果:
make run这会调用:
java -cp $(BUILD_DIR) $(MAIN_CLASS)如果你的主类还是示例里的 com.example.Main,那么最终运行效果就等同于执行 java -cp build com.example.Main。如果你已经替换过主类名,就要确保 Makefile 中的 MAIN_CLASS 与实际入口保持一致。
另外,清理旧产物也已经包含在示例中。执行 make clean 后,build 目录会被删除,适合在重新整理构建结果或排查历史编译残留时使用。
这套方法值不值得上
如果你的 Java 项目已经开始出现“每次改完都要等一会儿才能编译完”的情况,那么在 CentOS 下引入 Makefile 并配合 make -j N,通常是非常直接的一次提速。它不要求你重构项目,也不需要额外引入复杂工具,核心只是把现有编译步骤组织起来,再把并行能力交给 make。
这类思路也不只适用于 Java。只要某个构建过程能被 Makefile 描述清楚,make -j 的并行机制同样可以用于 C/C++,甚至用来调度 Python 项目的其他工具链。对于追求日常构建效率的开发者来说,这是很容易见效的一步优化。



