Linux 上的 Java 性能优化,通常不是只改一个启动参数就能见效。更常见的做法,是先判断瓶颈落在 JVM、磁盘与文件系统、系统资源限制,还是代码与缓存策略,再按影响面逐层处理。下面按网站读者更常见的排查顺序整理一遍,既方便快速落地,也便于后续验证优化是否真的有效。
先从 JVM 参数入手,解决最常见的运行时瓶颈
如果应用本身运行在 Linux 上,但经常出现吞吐不稳、GC 抖动或启动后性能忽高忽低,第一步通常应先看 JVM 参数。相比直接改业务代码,这一层调整成本更低,也更容易快速观察收益。
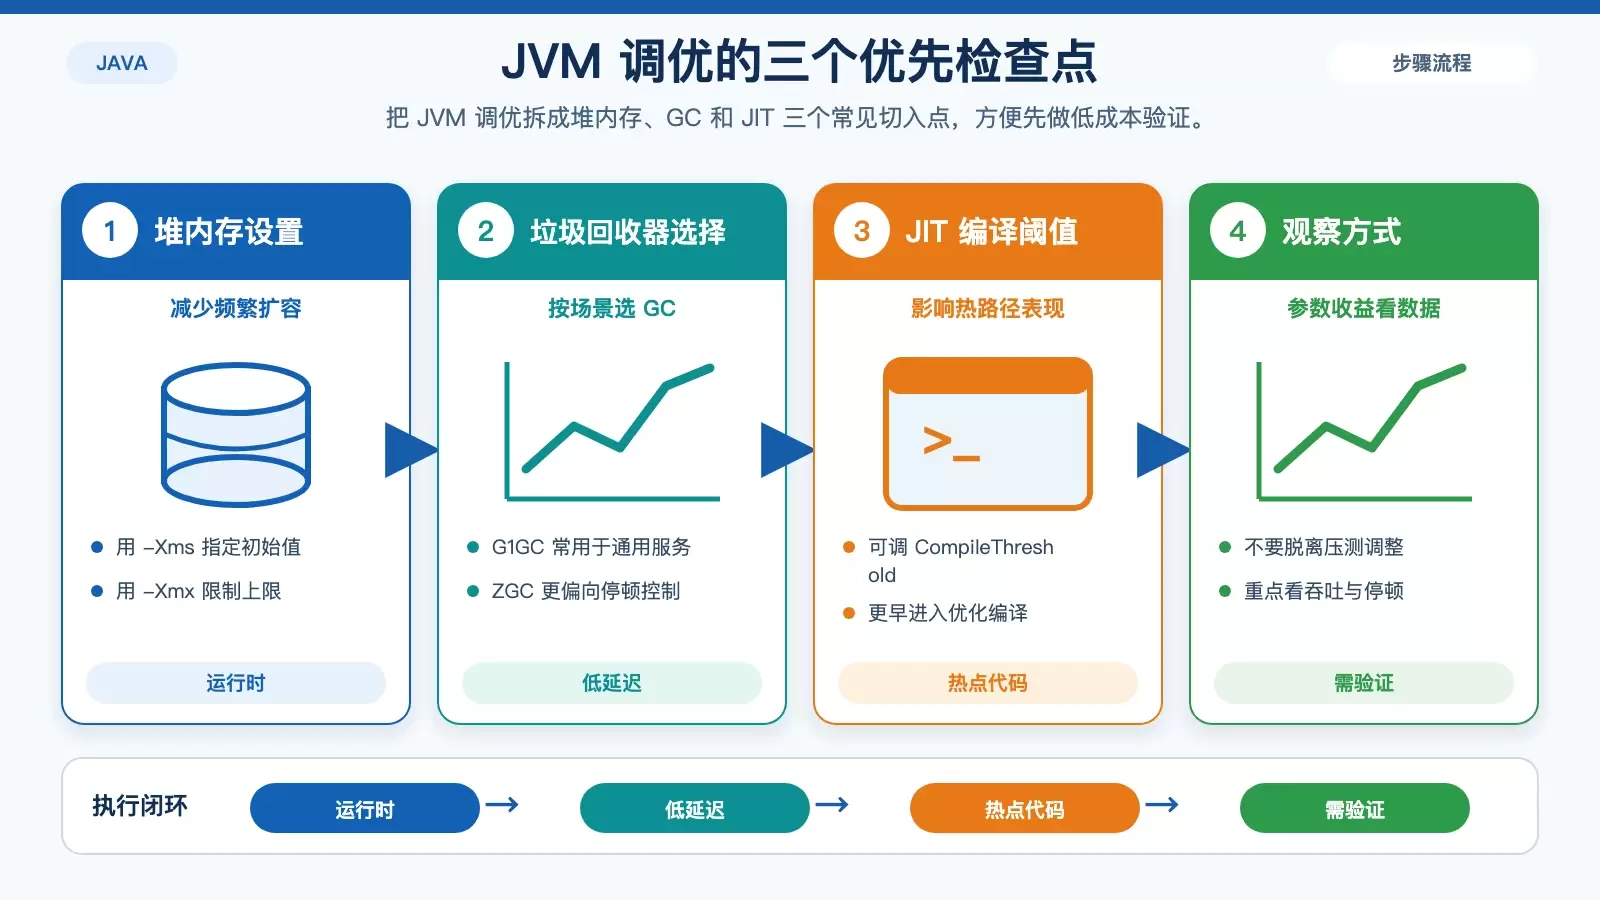
堆内存大小要与实际负载匹配
堆设置过小,会导致对象频繁触发回收;设置方式不合理,则可能在运行中不断扩容,带来额外开销。常见做法是用 -Xms 和 -Xmx 明确指定初始堆和最大堆,让内存分配更稳定。
ja va -Xms512m -Xmx2g MyApplication这类参数没有统一最优值,关键还是看应用负载、对象生命周期以及机器内存余量。
根据场景选择垃圾回收器
不同 GC 的目标并不一样。对响应时间敏感、希望减少停顿的业务,G1GC 或 ZGC 往往比默认方案更值得优先评估。尤其在并发量较高、堆较大的服务上,GC 选择对尾延迟的影响很直接。
ja va -XX:+UseG1GC MyApplicationJIT 编译阈值也可能影响热路径表现
JIT 会把热点代码编译成本地机器码,但触发时机并不是固定不变的。通过 -XX:CompileThreshold 调整编译阈值,可以更早让热点方法进入优化编译阶段,减少解释执行时间。
ja va -XX:CompileThreshold=1000 MyApplication不过这类参数更适合在有明确性能观测的前提下调整,不能脱离压测结果单独判断收益。
磁盘、文件系统与系统限制,往往决定服务上限
当 Java 程序涉及日志写入、临时文件、索引、缓存落盘或频繁网络连接时,Linux 层面的资源限制很容易成为真正瓶颈。很多程序看起来是“Java 慢”,实际上卡在 IO 或内核参数上。
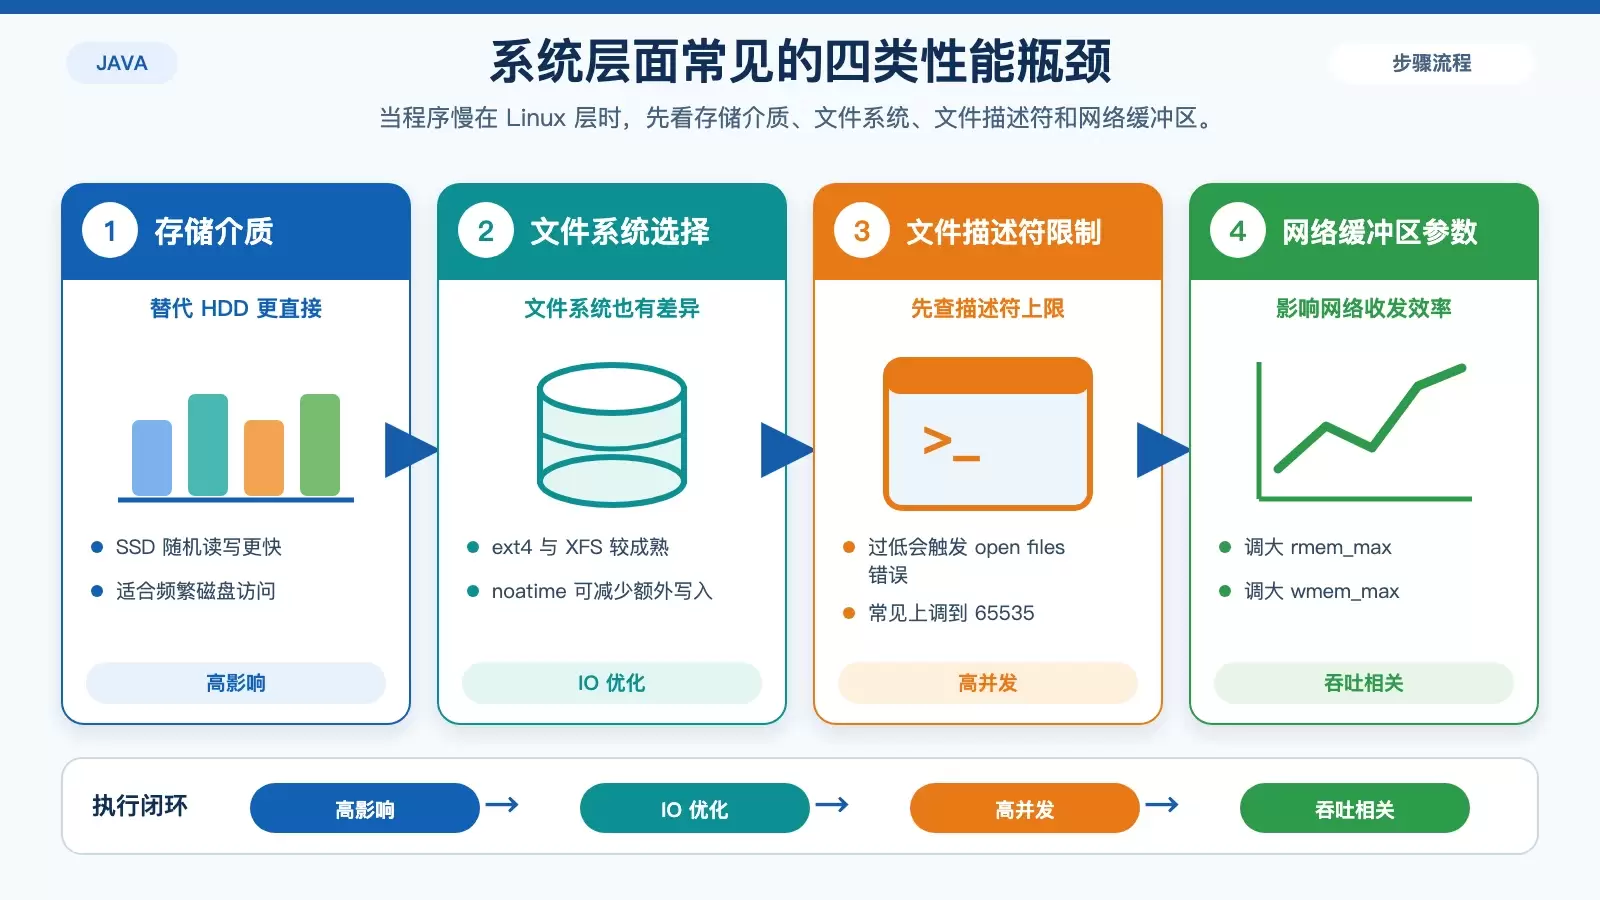
先确认底层存储和文件系统是否合适
如果仍在使用 HDD,频繁随机读写场景下性能损失会很明显。换用 SSD 往往是最直接、最稳定的提升手段,尤其适合有大量磁盘访问的 Java 服务。
文件系统方面,ext4 和 XFS 都是 Linux 下较成熟的高性能方案。若再配合类似 noatime 的挂载参数,可以减少不必要的访问时间更新,进一步降低 IO 开销。
高并发服务先看文件描述符限制
连接数一上来,文件描述符不够往往比 CPU 打满来得更早。出现 too many open files 这类错误时,优先检查并提高限制值,通常比盲目扩容应用线程更有效。
ulimit -n 65535对于长连接、网关、消息处理和高并发 Web 服务,这一项尤其关键。
网络缓冲区参数也会影响吞吐
如果应用网络通信频繁,例如 RPC、HTTP 服务或消息传输系统,TCP 缓冲区大小会影响数据收发效率。适当调大内核参数,常能改善高吞吐场景下的表现。
sysctl -w net.core.rmem_max=16777216
sysctl -w net.core.wmem_max=16777216
这类调整更适合结合实际流量特征与监控数据来做,重点看吞吐、重传和延迟变化。
代码、缓存与并发模型,是持续优化的核心区域
当 JVM 和系统层已经相对稳定后,剩下的性能空间通常主要藏在代码实现和访问路径里。这里的优化不一定最省事,但往往决定长期效果。
减少对象创建,降低 GC 压力
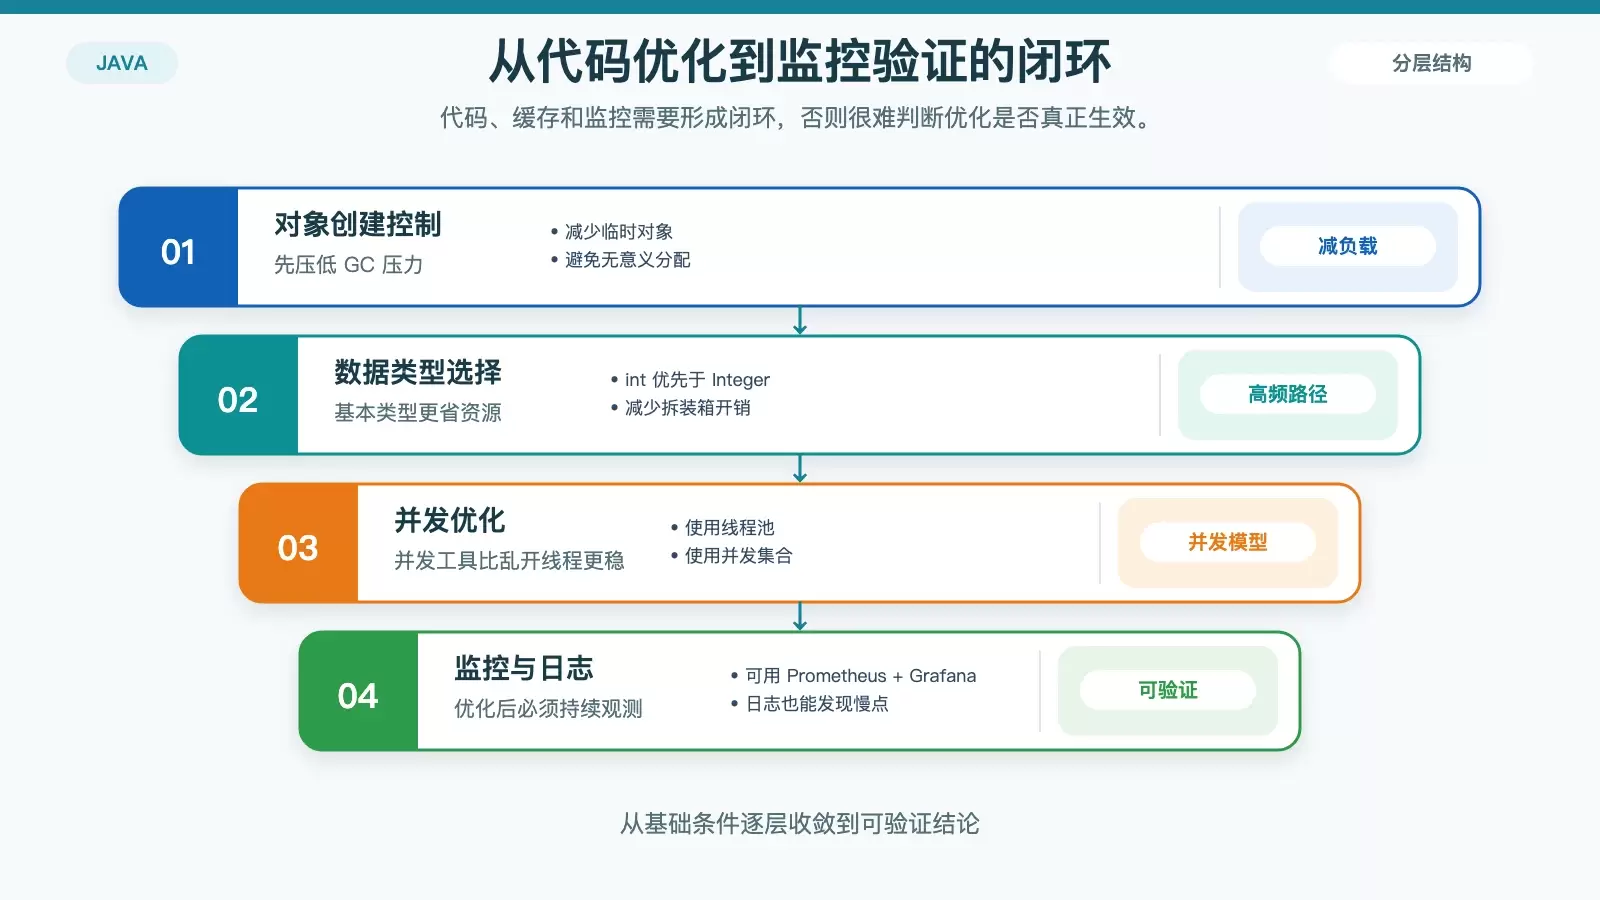
频繁创建生命周期很短的临时对象,会让垃圾回收更加频繁。对热点路径而言,复用对象、使用对象池,或者避免无意义的中间对象,通常都能带来更稳定的内存表现。
能用基本类型时,尽量别引入额外装箱
像 int 和 Integer 之间的差异,不只是语法层面问题。包装类型会引入更多对象分配,还可能带来拆箱与装箱成本。在高频计算或大批量数据处理时,这类开销会逐步放大。
并发工具要用对,而不是线程越多越快
Linux 服务器资源再充足,线程模型设计不合理也会拖慢整体吞吐。合理使用 ja va.util.concurrent 包中的线程池、并发集合等工具类,通常比手写粗放式多线程更稳,也更容易控制资源占用。
缓存能减少重复访问成本
如果瓶颈落在数据库查询、远程服务调用或重复读取静态内容上,那么缓存比单纯调 JVM 更有效。内存缓存可以直接缩短访问链路,常见方案包括 Ehcache 和 Redis。
面向静态资源时,CDN 也属于非常实用的一类“缓存优化”。图片、JS、CSS 交给 CDN 分发后,既能减轻源站压力,也能提升用户侧加载速度。
没有分析与监控,优化很容易变成猜参数
真正可复用的性能优化,离不开工具支撑。只凭感觉调参数,往往会把问题从一个位置挪到另一个位置,而不是真正解决瓶颈。
先用分析工具定位热点
常见的 Java 性能分析工具包括 JProfiler、VisualVM 和 YourKit。它们的定位侧重点略有不同:
- JProfiler:功能较完整,适合深入排查 CPU、内存和调用链问题。
- VisualVM:JDK 自带,部署门槛低,适合日常观察运行状态。
- YourKit:商业工具,内存泄漏和性能分析能力都比较强。
如果还没有形成系统化排查流程,通常可以先从 VisualVM 这类轻量工具开始,再视问题复杂度选择更专业的分析方案。
持续监控,才能验证优化是否真的有效
优化之后如果没有持续观测,很难确认收益是否稳定。Prometheus 配合 Grafana,能比较直观地观察 CPU、内存、GC 等关键指标变化,用来判断系统是否真正变快、是否引入了新的波动。
此外,日志分析同样重要。很多慢请求、异常调用、慢查询,并不会直接在 JVM 参数里暴露出来,反而更容易从应用日志中先看到征兆。
Linux 下优化 Java 性能,重点是按层定位而不是一次性全改
把 Java 程序跑快,没有单一万能方案。更有效的思路是先看 JVM 参数,再检查磁盘与系统限制,接着回到代码、并发和缓存设计,最后用分析工具和监控结果验证每一步是否带来正向收益。
从实际经验看,真正明显的性能提升往往不是来自某一个“大招”,而是多个细节叠加后的结果。只要定位准确,Linux 环境下的 Java 服务通常还有不少可挖的优化空间。


