
Linux 下的 C++ 性能优化,往往不是把某个参数开到最大就能解决的问题。真正有效的做法,是先确认瓶颈落在哪一层,再分别从代码、编译器、系统和分析工具入手,逐步验证优化是否带来真实收益。看完这篇,你可以建立一条更清晰的排查路径:哪些地方最容易出性能问题,哪些命令适合直接上手,以及怎样避免“优化了很多却没提速”的常见误区。
代码层优化:先解决最容易放大的性能问题
对 C++ 程序来说,代码层通常是最值得优先投入的部分。因为算法、数据结构和内存访问方式一旦选错,后面即使叠加编译器选项或系统调优,收益也会很有限。
算法和数据结构决定性能上限
这是最根本的一层优化。选对算法和数据结构,带来的提升往往不是几个百分点,而可能是一个数量级以上的差距。尤其是在大数据量、频繁查询、重复遍历等场景里,时间复杂度和空间布局会直接决定程序是否还能继续扩展。
循环优化要盯住重复计算
循环通常是热点最集中的区域。优化时应优先减少循环体内不必要的计算,再根据场景考虑循环展开、循环融合等手段,以减少指令数量和分支开销。相比零散地改语法,针对热点循环做处理更容易看到稳定收益。
内联适合高频小函数
对于调用非常频繁、函数体又很短的小函数,可以使用 inline 关键字,或者借助编译器选项促使内联展开。这样做的价值在于减少函数调用开销,但也要注意,内联并非越多越好,过度内联可能让代码体积膨胀,反而影响指令缓存命中率。
减少动态内存分配与缓存未命中
频繁的 new/delete 往往代价不低,尤其在高并发或高频对象创建场景里更明显。能使用栈内存时尽量使用栈内存;如果对象生命周期和数量有规律,可以考虑对象池来降低分配成本。
与此同时,数据结构设计还要兼顾 CPU 缓存友好性。访问模式连续、局部性良好的代码,更容易减少缓存未命中;而结构分散、随机跳转频繁的访问方式,通常会拖慢整体执行效率。
并行化是多核机器上的常规优化手段
如果任务本身可拆分,就可以考虑使用多线程或多进程,将工作分散到多个核心上执行。这类方法对计算密集型任务尤其有效,但前提是拆分后的同步、锁竞争和数据共享成本没有抵消并行收益。
编译器优化:把 GCC/Clang 的自动优化能力用起来
在代码结构基本合理的前提下,编译器优化往往是性价比很高的一步。很多程序在不改业务逻辑的情况下,只通过正确的编译选项就能拿到可观提升。
先从 -O2 或 -O3 开始
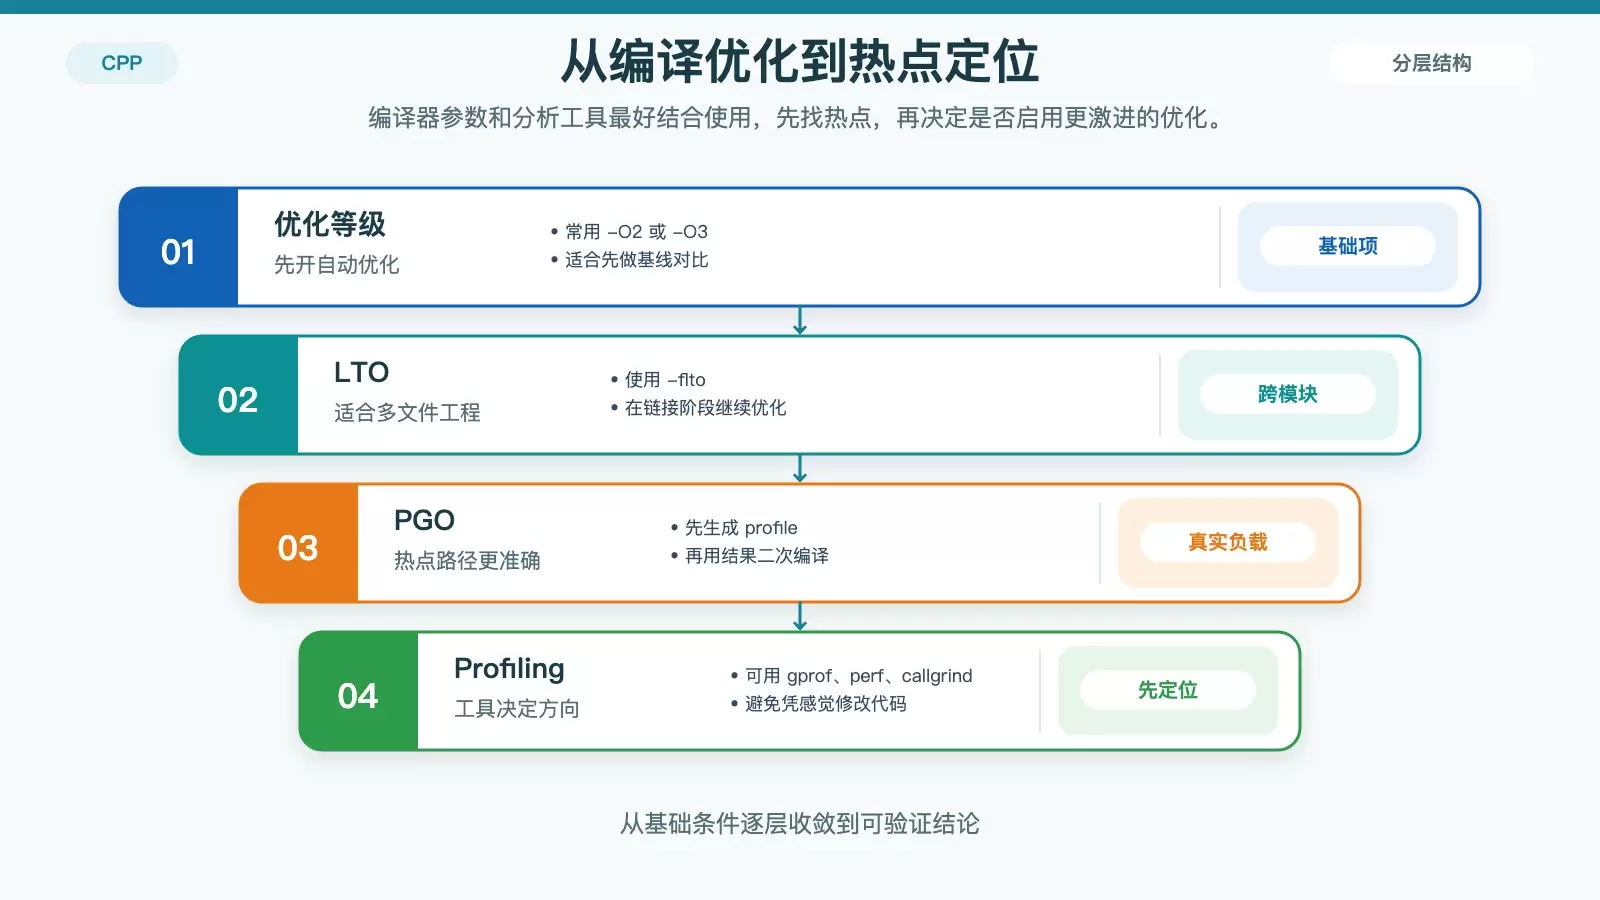
常见的基础做法,是在编译时启用 -O2 或 -O3。它们会触发一系列自动优化,包括指令重排、公共子表达式消除、循环相关优化等。一般来说,-O2 更稳健,-O3 则更激进,适合在测试后确认收益。
g++ -O3 -o myprogram myprogram.cpp链接时优化适合跨模块提速
如果项目由多个源文件组成,只靠单个编译单元内的优化有时不够。启用链接时优化(LTO)后,编译器可以在链接阶段继续做跨模块分析和优化,这对大型工程尤其有价值。
g++ -flto -o myprogram myprogram.cppPGO 适合热点路径明显的程序
Profile Guided Optimization(PGO)属于更进一步的优化方式。它先根据真实运行过程收集 profile 数据,再用这些数据进行二次编译,让编译器把优化重点放到真正的热点路径上,而不是只靠静态猜测。
g++ -fprofile-generate -o myprogram myprogram.cpp
./myprogram
g++ -fprofile-use -o myprogram myprogram.cpp
这类方法特别适合业务流程稳定、请求分布相对固定的程序,因为采样结果越接近真实负载,最终优化效果通常越可靠。
系统层调优:减少 I/O、内存与调度带来的额外损耗
当程序本身已经没有明显低级问题时,系统层面的配置就会开始影响最终表现。这里的重点,不是“把系统参数调得越激进越好”,而是让操作系统行为更贴近程序的运行特点。
文件系统与存储介质会影响 I/O 成本
如果程序依赖大量磁盘读写,优先使用 SSD 往往比细枝末节的代码改动更有效。挂载文件系统时加入 noatime 参数,也能减少访问时间更新带来的额外磁盘 I/O。
控制交换倾向,优先使用物理内存
Linux 的内存管理策略会影响延迟表现。适当降低 vm.swappiness,例如设置为 10,可以让系统更倾向于使用物理内存,减少进入交换分区的概率。对延迟敏感型程序来说,这一步通常值得检查。
sysctl vm.swappiness=10CPU 亲和性有助于减少缓存抖动
对于持续运行、线程模型稳定的程序,可以尝试用 taskset 将进程绑定到固定 CPU 核心。这样有助于减少频繁迁核带来的上下文切换与缓存失效问题。
taskset -c 0,1 ./myprogram网络程序还要考虑内核参数与库选择
如果瓶颈出在网络通信,除了调整 TCP 相关内核参数,也可以评估高性能网络库,例如 libuv。这类优化更偏场景化,适合高连接数、高吞吐或低延迟要求明显的服务端程序。
先做 Profiling:用工具找到真正的热点
性能优化最常见的误区,就是还没定位瓶颈就开始修改代码。结果往往是花了很多时间,却只优化了不重要的路径。相比凭经验猜测,先做 profiling 更可靠,也更节省时间。
gprof:快速查看热点函数
gprof 是 GNU 工具链中常见的性能分析工具,适合快速查看函数级别的热点分布。它能帮助你先回答一个基本问题:时间主要耗在哪些函数里。
g++ -pg -o myprogram myprogram.cpp
./myprogram
gprof myprogram gmon.out > analysis.txt
perf:更贴近 Linux 内核与 CPU 事件
perf 是 Linux 下非常实用的分析工具,既能看函数热点,也能进一步观察 CPU 事件、采样分布和指令级行为。对于需要深入排查缓存未命中、分支预测失误等问题的场景,它比单纯的函数级统计更有参考价值。
perf record ./myprogram
perf report
Valgrind/callgrind:适合分析调用关系与内存行为
如果你想看更细的调用链,或者同时关注内存层面的行为,可以使用 Valgrind 配合 callgrind。生成的调用图还能通过 kcachegrind 做可视化查看,更容易发现调用路径上的异常放大点。
valgrind --tool=callgrind ./myprogram
kcachegrind callgrind.out.pid
补充技巧:减少系统调用与阻塞等待
除了前面几类主线方法,还有一些常见但容易被忽略的细节,同样会对性能产生持续影响。
尽量减少系统调用次数
系统调用本身就有上下文切换成本。如果程序频繁进行零散 I/O,通常可以通过合并请求、批量处理或调整缓冲策略来降低调用次数,从而减少额外开销。
异步 I/O 适合提升吞吐量
在 I/O 密集场景下,异步 I/O 能避免主线程长期阻塞。像 libaio 这样的库,适合在对吞吐量有明确要求的服务中使用,但是否值得引入,还要看程序模型是否能承接随之增加的复杂度。
别忽视编译器差异
不同编译器,例如 GCC 和 Clang,各自都有不同的优化实现与特性支持。同一份代码在不同编译器上的表现可能并不一致,因此在关键项目里,对比不同工具链的构建结果也很有必要。
结语:优化顺序比优化技巧更重要
Linux 下优化 C++ 性能,真正有效的方法通常不是堆技巧,而是先定位、再验证、再逐层收敛。一般可以按“profiling 找热点、代码层修正、编译器优化、系统调优”的顺序推进,这样更容易判断每一步是否带来真实收益。
最后要记住,优化前一定先做 profiling,避免过早优化。只有围绕真实瓶颈展开的调整,才更可能把时间花在最值得的地方。


