很多人在 CentOS 上跑 Rust 程序时,第一反应是语言性能没有预期高,但实际问题往往出在构建方式、资源配置或运行时选择上,而不是 Rust 本身。更稳妥的做法,是按编译、代码、系统、运行时四个层次逐步排查:先确认二进制是否以正确方式构建,再看热点代码和并发模型,最后结合 Linux 环境做针对性调整。这样处理,既能更快找到瓶颈,也更容易判断哪类优化最值得投入。
先确认是不是编译方式拖慢了程序
Rust 的执行效率,很多时候从编译阶段就已经定型。如果程序是在错误的构建模式下测试出来的,再往下分析代码和系统参数,方向就可能偏掉。
先更新工具链,并确保使用 Release 模式
第一步先检查工具链版本。通过 rustup update 升级到最新稳定版,通常就能拿到编译器和标准库里的现成优化。这一步成本很低,但经常被忽略。
更关键的是构建模式。性能测试必须基于:
cargo build --releaseRelease 模式会默认开启 opt-level=3,生成的二进制和 Debug 版本相比,速度差距往往非常明显。很多“Rust 在服务器上怎么这么慢”的判断,实际上只是拿 Debug 产物做了运行测试。
在 Cargo.toml 里补齐关键优化项
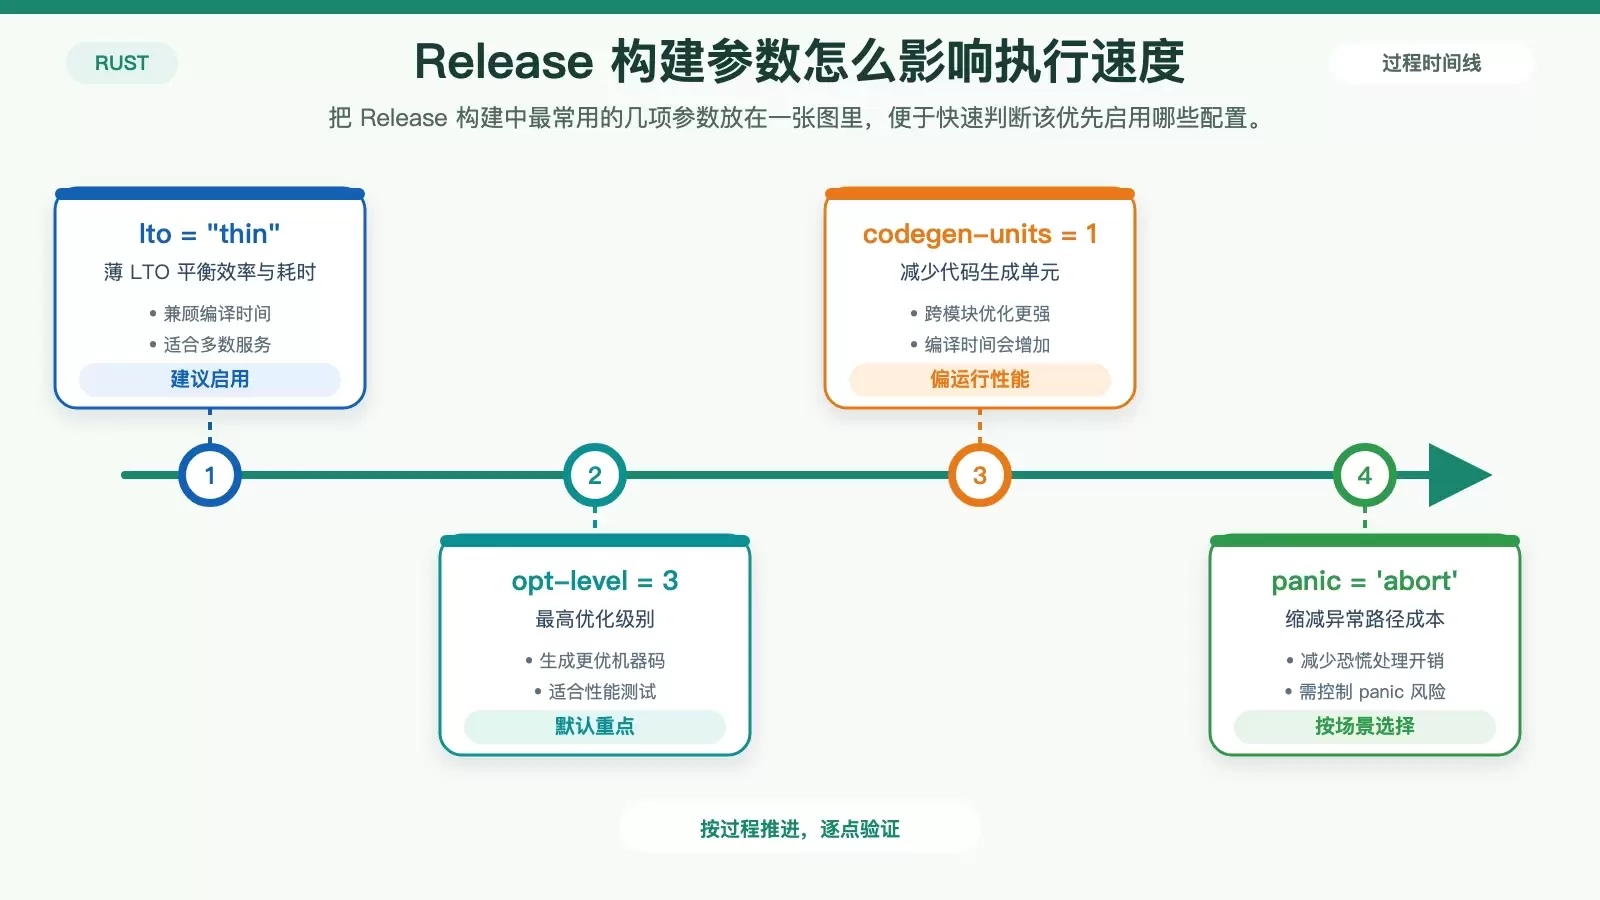
如果已经使用了 Release 模式,仍然觉得性能没有跑出来,可以继续细化 Cargo.toml 中的发布配置。在 [profile.release] 下,下面几项最值得优先考虑:
lto = "thin":启用薄链接时优化,在编译时长和执行性能之间通常比较均衡;opt-level = 3:最高优化级别,虽然是默认值,但显式写出来更便于确认配置;codegen-units = 1:减少代码生成单元,提升跨模块优化机会,代价是编译更慢;panic = 'abort':降低恐慌处理带来的额外开销,适合能控制 panic 风险的程序。
这类参数不会替代代码优化,但对于长时间运行、性能敏感的服务程序,通常能带来比较稳定的收益。
性能敏感场景可以继续尝试 PGO
如果应用已经进入进一步压榨性能的阶段,可以考虑 Profile-Guided Optimization(PGO)。它的思路是先通过 perf 收集程序真实运行时的热点数据,再让编译器按这些数据重新优化目标代码。
原文中给出的构建方式是:
cargo build --release --profile=pgo这类方法更适合热点集中、负载模型比较稳定的服务或计算程序。它不是通用银弹,但当普通 Release 优化已经接近上限时,PGO 往往是还能继续往前走的一步。
代码层面重点看内存、迭代和并行方式
编译参数解决的是“生成什么样的机器码”,代码层面解决的则是“程序本来就在做什么”。如果数据结构、内存分配和并发模型选得不合适,再强的编译器也很难完全补回来。
先减少不必要的分配和拷贝
Rust 在内存管理上已经很克制,但应用代码仍然可能因为频繁扩容或多余拷贝拖慢运行速度。比较直接的做法包括:
- 对可预估大小的集合使用
Vec::with_capacity; - 对字符串缓冲使用
String::with_capacity; - 在只读传参场景下优先使用
&str,避免把String来回传递造成不必要复制。
这些调整看起来不大,但会直接影响分配次数和缓存命中情况,尤其是在高频调用路径中,累计效果很明显。
合理使用迭代器,并在合适场景引入并行
不少开发者为了“可控”,会把所有逻辑都写成手工 for 循环。但 Rust 的迭代器和闭包本身就是按零成本抽象设计的,像 map、filter 这类接口,编译后通常可以得到与手写循环相近的机器码,有时还更利于优化。
如果任务本身具有数据并行特征,比如数组遍历、批量计算、矩阵处理,就可以进一步考虑 rayon。很多情况下,只要把:
.iter()替换为:
.par_iter()就能让程序开始利用多核 CPU。前提是任务确实适合并行,且单次工作量足够覆盖线程调度带来的成本。
锁竞争和热点函数要用工具定位
高并发程序里,一个很常见的性能损耗点是锁竞争。问题不一定出在“有没有锁”,而是锁是否落在高频路径上、是否把多个线程都卡在同一处。对于这类场景,可以优先评估无锁数据结构,例如 crossbeam 的 AtomicCell,或直接使用 std::sync::atomic 提供的原子操作。
至于真正的热点代码,不建议靠经验猜。更有效的办法是用 perf 或 flamegraph 先把热点找出来,再决定是缓存计算结果、减少重复调用,还是改写关键路径。优化动作越靠近真实瓶颈,收益越稳定。
CentOS 系统参数要跟上程序负载
如果程序已经是 Release 构建,代码层面也没有明显低级问题,但一到线上就变慢,接下来就该检查 CentOS 的系统限制和硬件适配了。很多 I/O 或高并发场景的瓶颈,其实先出现在操作系统这一层。
先看文件描述符和网络内核参数
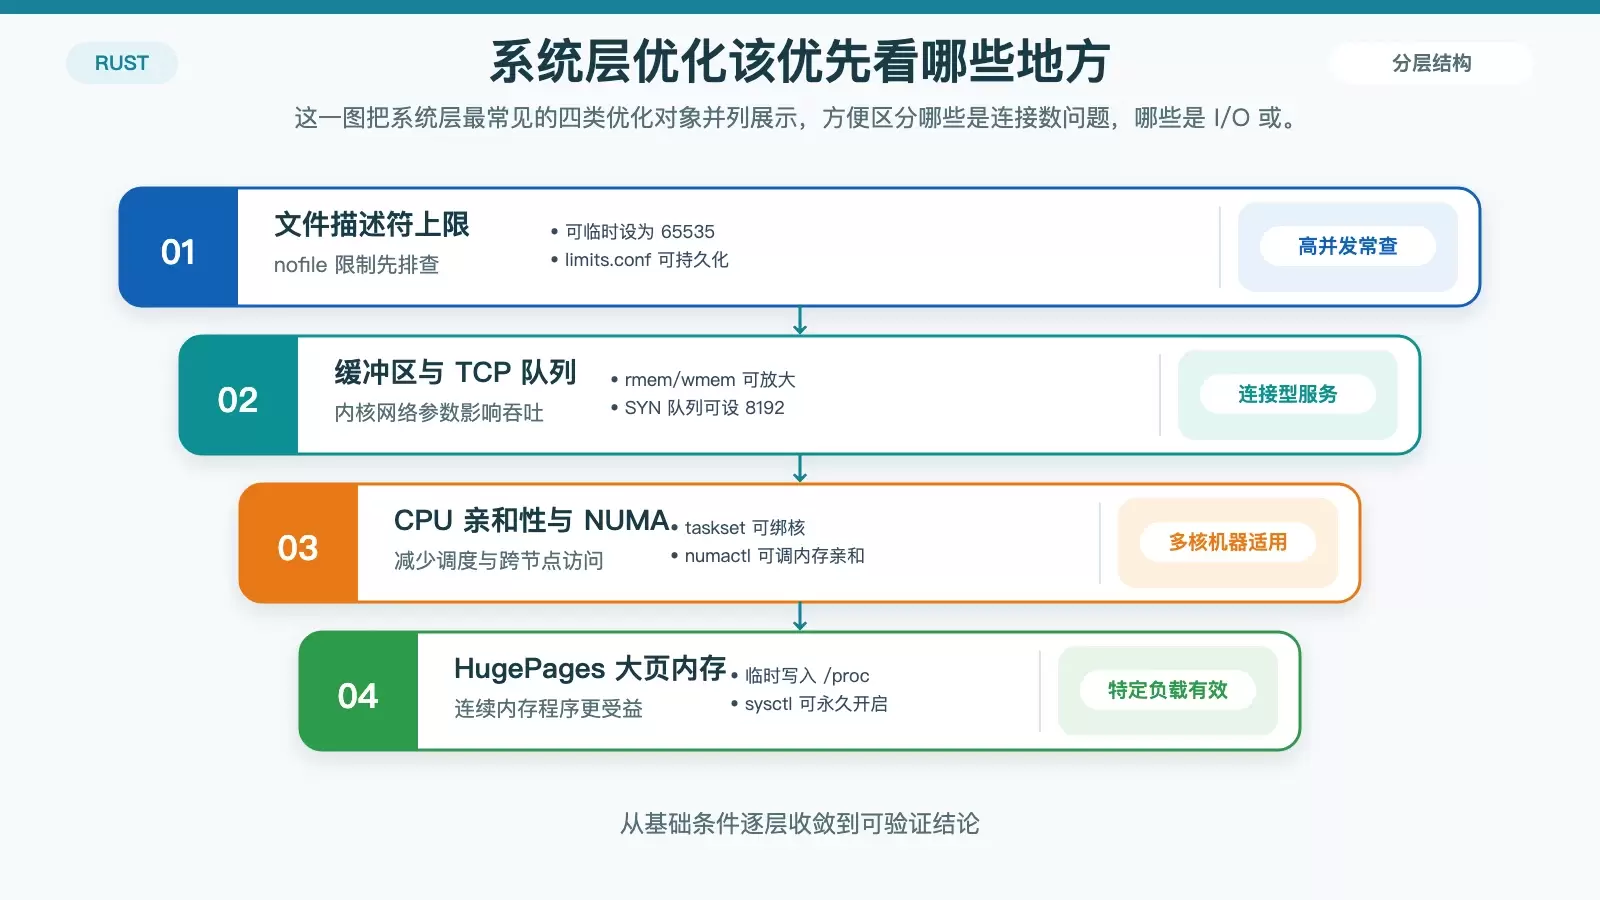
对网络服务、日志处理或其他 I/O 密集型程序来说,文件描述符限制很容易成为上限。临时调整可以使用:
ulimit -n 65535如果需要长期生效,则要在 /etc/security/limits.conf 中加入类似配置:
* soft nofile 65535网络参数则通常放在 /etc/sysctl.conf 中。原文提到几项较常见的优化值:
net.core.rmem_max=16777216:接收缓冲区最大值;net.core.wmem_max=16777216:发送缓冲区最大值;net.ipv4.tcp_tw_reuse=1:允许复用 TIME-WAIT 连接;net.ipv4.tcp_max_syn_backlog=8192:增大 SYN 队列长度。
这些参数更适合高连接数或高吞吐场景,是否调整、调整到什么程度,仍要结合实际业务负载验证。
I/O、CPU 亲和性和 NUMA 也会影响实际表现
如果程序依赖频繁磁盘读写,例如数据库、索引服务或日志系统,那么存储设备的延迟往往比代码细节更先决定上限。把设备从机械盘切换到 SSD,通常是最直接、最容易感知的改善。
CPU 资源调度方面,也可以通过绑定核心减少上下文切换。例如:
taskset -c 0,1 ./your_program在 NUMA 架构机器上,还可以配合 numactl 调整进程与内存的亲和关系,尽量让计算和内存访问落在更接近的位置,降低跨节点访问带来的开销。
大页内存适合连续内存需求明显的程序
对于数据库、高性能计算或其他需要大量连续内存的应用,大页内存(HugePages)值得纳入排查清单。临时开启方式是:
echo 1 > /proc/sys/vm/nr_hugepages如果希望永久生效,可以在 /etc/sysctl.conf 中增加:
vm.nr_hugepages=1024它的核心价值在于减少 TLB 未命中,提高内存访问效率。不过这项优化是否有效,与程序的内存访问模式关系很大,适合在明确存在大块内存需求时再启用。
运行时优化决定高并发场景的上限
当构建、代码和系统配置都已经比较到位,剩下的瓶颈往往集中在运行时层面,特别是分配器和 I/O 模型。这两部分在单机压测和线上高并发环境里的表现差异,通常非常明显。
多线程程序可以评估替换内存分配器
Linux 默认的 malloc 并不算差,但在多线程负载下,未必是表现最好的选择。原文提到 jemalloc 和 tcmalloc 都值得评估,其中 jemalloc 在多线程场景里经常更稳。
给出的设置方式包括通过环境变量:
export MALLOC_CONF=backend:jemalloc或者在 Cargo.toml 中配合 build.rs 做配置。是否值得替换,取决于你的程序是不是分配频繁、线程数较多,以及分配器是否已经成为实际瓶颈。
I/O 密集型服务要优先考虑异步模型
网络服务、文件处理等 I/O 密集型任务,常见瓶颈不是 CPU 算力不够,而是线程被阻塞等待 I/O 返回。这时候,异步 I/O 往往比继续堆线程更有效。
tokio 和 async-std 都是比较成熟的方案。它们通过非阻塞 I/O,让单线程可以同时处理大量连接。如果你的 Rust 程序本身就面向高并发访问,这通常不是可选优化,而是架构层面需要尽早做出的决定。
排查顺序比零散调参更重要
把 Rust 程序在 CentOS 上跑快,关键不在于一次塞进多少优化选项,而在于按顺序定位问题。通常应该先确认是否用了 cargo build --release 以及合适的发布配置,再检查内存分配、并行方式和锁竞争,之后才是文件描述符、内核参数、SSD、CPU 亲和性、大页内存这些系统层手段。
如果程序已经进入高并发或性能敏感阶段,再进一步评估 perf、flamegraph、PGO、jemalloc、tokio 这类工具和方案,会比盲目调参更有效。换句话说,Rust 在 CentOS 上“慢”通常不是单点问题,真正有效的加速方式,是把构建、代码、系统和运行时串成一条完整的排查链路。



