Linux 里的 Java 日志管理,难点通常不在“怎么打日志”,而在生产环境里怎样让日志长期可用:既能稳定写入文件,不把磁盘打满,也能在排障、审计和回溯时迅速找到线索。下面按实际落地顺序梳理一遍,从框架选择、Log4j2 配置到 logrotate 轮转,再补上监控、安全和备份这几个容易被忽略的环节。
先明确目标:日志系统要解决什么问题
在 Linux 服务器上运行 Java 程序时,日志管理通常围绕几个核心目标展开:
- 选择合适的日志框架,保证项目接入成本、性能和维护方式都可控。
- 把日志级别、格式、输出位置和轮转策略提前配置好,避免线上排查时临时补洞。
- 让日志稳定输出到文件,而不是只停留在控制台。
- 控制日志文件增长,避免长期运行后占满磁盘。
- 为后续监控、分析、审计和备份预留空间。
常见的 Java 日志方案里,Log4j、Logback、SLF4J 都很成熟。具体选哪一个,没有统一答案,主要看项目规模、团队习惯以及对性能和配置灵活性的要求。本文后续用 Log4j2 做示例,重点不在比较框架优劣,而是把 Linux 环境下的一套日志管理流程串起来。
用 Log4j2 建立基础配置
添加依赖
如果项目使用 Maven,可以先在 pom.xml 中加入 Log4j2 依赖:
        org.apache.logging.log4j
        log4j-core
        2.14.1


        org.apache.logging.log4j
        log4j-api
        2.14.1
这里保留了 2.14.1 版本号,方便与现有项目配置保持一致。实际使用时,至少要确认依赖版本、部署环境和团队规范一致,否则后面排查配置生效与否会比较费劲。
配置输出目标、日志级别与轮转条件
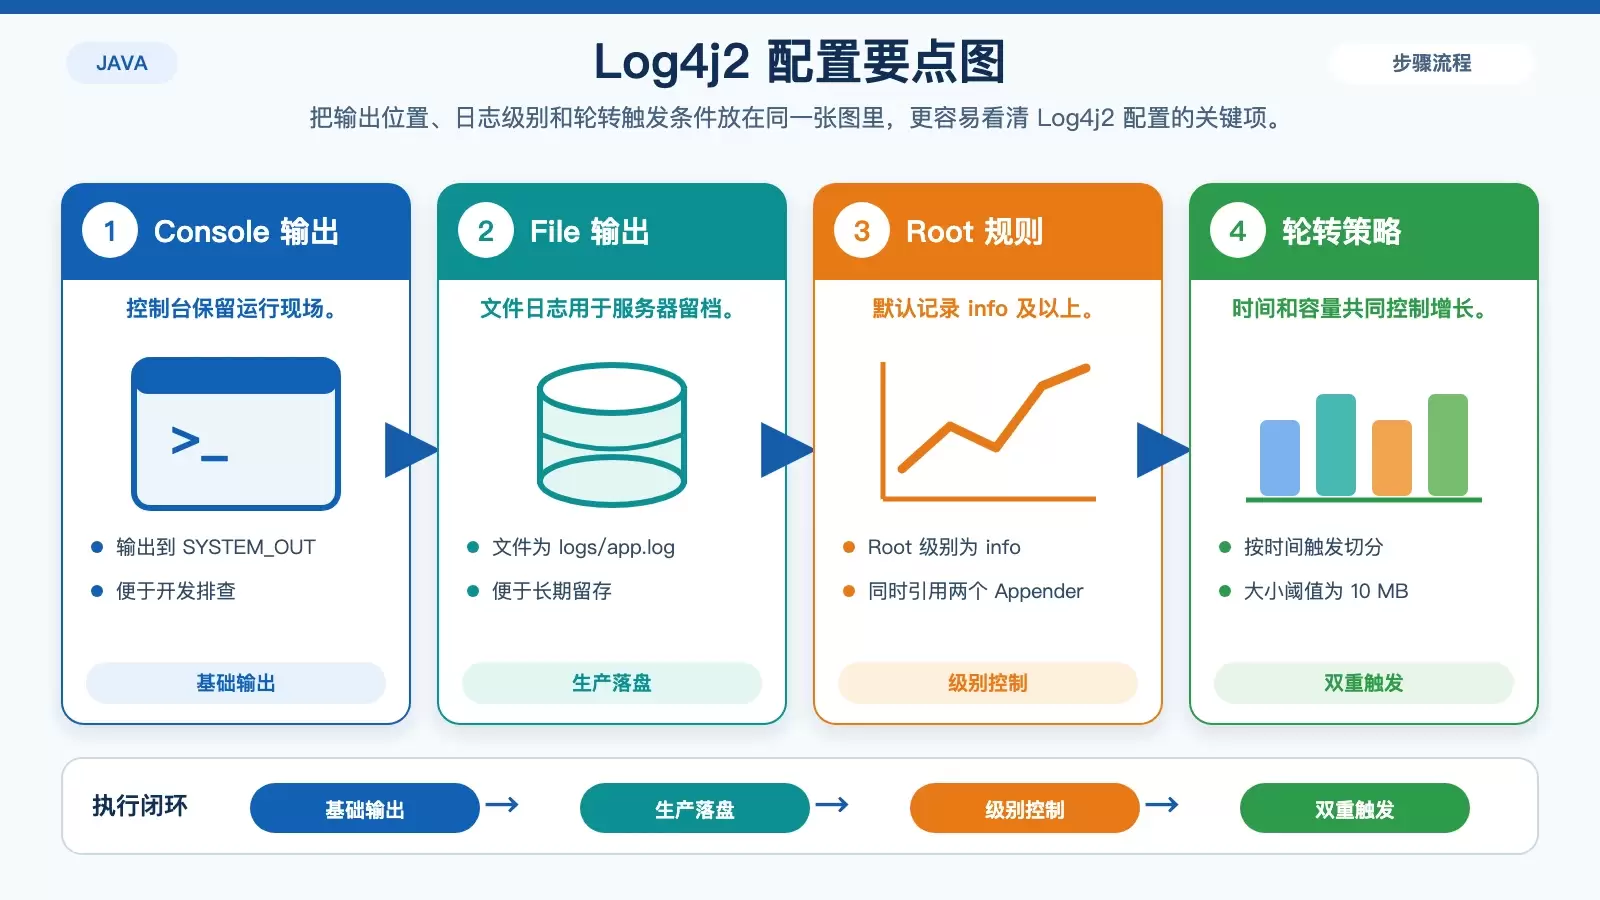
依赖加入后,在 src/main/resources 下创建 log4j2.xml。这一步的重点,是一次性把控制台输出、文件落盘、日志格式和轮转触发条件写清楚:
这份配置里有几项最值得注意:
Root level="info":默认记录info及以上级别,适合大多数生产环境起步配置。Console和File同时存在:既方便开发和容器场景下看标准输出,也保留文件日志供 Linux 服务器长期留存。fileName="logs/app.log":明确把日志写入文件,避免应用重启后只能从终端历史里找线索。TimeBasedTriggeringPolicy与SizeBasedTriggeringPolicy size="10 MB":同时按时间和大小触发轮转,降低单文件过大的风险。
日志格式里保留了时间、级别、类名、行号和消息内容,这些信息在定位线上异常时非常关键。尤其是类名和行号,看起来会让日志长一些,但能明显缩短排障时间。
Java 代码里怎么规范使用日志
配置文件准备好之后,代码里就需要统一通过 Logger 输出日志,而不是用零散的控制台打印。示例代码如下:
import org.apache.logging.log4j.LogManager;
import org.apache.logging.log4j.Logger;

public class MyApp {
    private static final Logger logger = LogManager.getLogger(MyApp.class);

    public static void main(String[] args) {
        logger.info("Application started.");
        // Your application logic here
        logger.error("An error occurred.", new Exception("Test exception"));
        logger.info("Application finished.");
    }
}
这段代码展示的不是语法本身,而是几个基本习惯:
- 用
LogManager.getLogger(MyApp.class)为类创建独立 Logger,后续检索时更容易按类定位问题。 - 启动、结束、异常这些关键节点要有明确日志,便于还原程序执行路径。
- 异常日志不要只写一句文本,像示例里这样把
Exception("Test exception")一起带上,排查价值才高。
实际项目里,还可以继续细分 DEBUG、INFO、WARN、ERROR 的使用边界。比如调试信息尽量放在 DEBUG,面向运行状态的关键信息放在 INFO,潜在风险放在 WARN,真正影响业务的故障再记为 ERROR。级别边界清楚,后续过滤、告警和分析才有意义。
在 Linux 上用 logrotate 接管日志轮转
仅靠应用把日志写进文件还不够,Linux 服务器还需要考虑日志文件如何长期管理。一个直接做法,就是结合系统自带的 logrotate 做统一轮转。
可以创建配置文件 /etc/logrotate.d/myapp,内容如下:
/path/to/logs/app.log {
    daily
    missingok
    rotate 7
    compress
    notifempty
    create 640 root adm
}
这组配置的含义比较明确:
daily:每天轮转一次,适合更新较频繁的应用日志。missingok:日志文件不存在时不报错,避免任务执行被无意义中断。rotate 7:保留最近 7 份历史日志,控制存储占用。compress:历史日志压缩保存,节省磁盘空间。notifempty:空日志不轮转,减少无效文件。create 640 root adm:轮转后创建新的日志文件,并指定权限和属主属组。
这样设置后,日志文件就不会无限增长,同时历史日志也能按天归档。对于一台机器上跑多个服务的场景,logrotate 的优势尤其明显,因为它可以把不同应用的日志保留周期、压缩方式和权限策略统一起来管理。
需要注意的是,日志框架自身也能做轮转,logrotate 也能做轮转。二者并不是一定要同时叠加,关键是提前确定由谁主导,避免策略重叠后出现文件切换混乱、日志丢段或定位困难的问题。
监控、日志安全与备份不能放到最后补
日志真正的价值,不只是“留在磁盘里”,而是出了故障之后能快速看懂、查到、追溯到。因此除了写文件和轮转,还需要补齐下面几个环节。
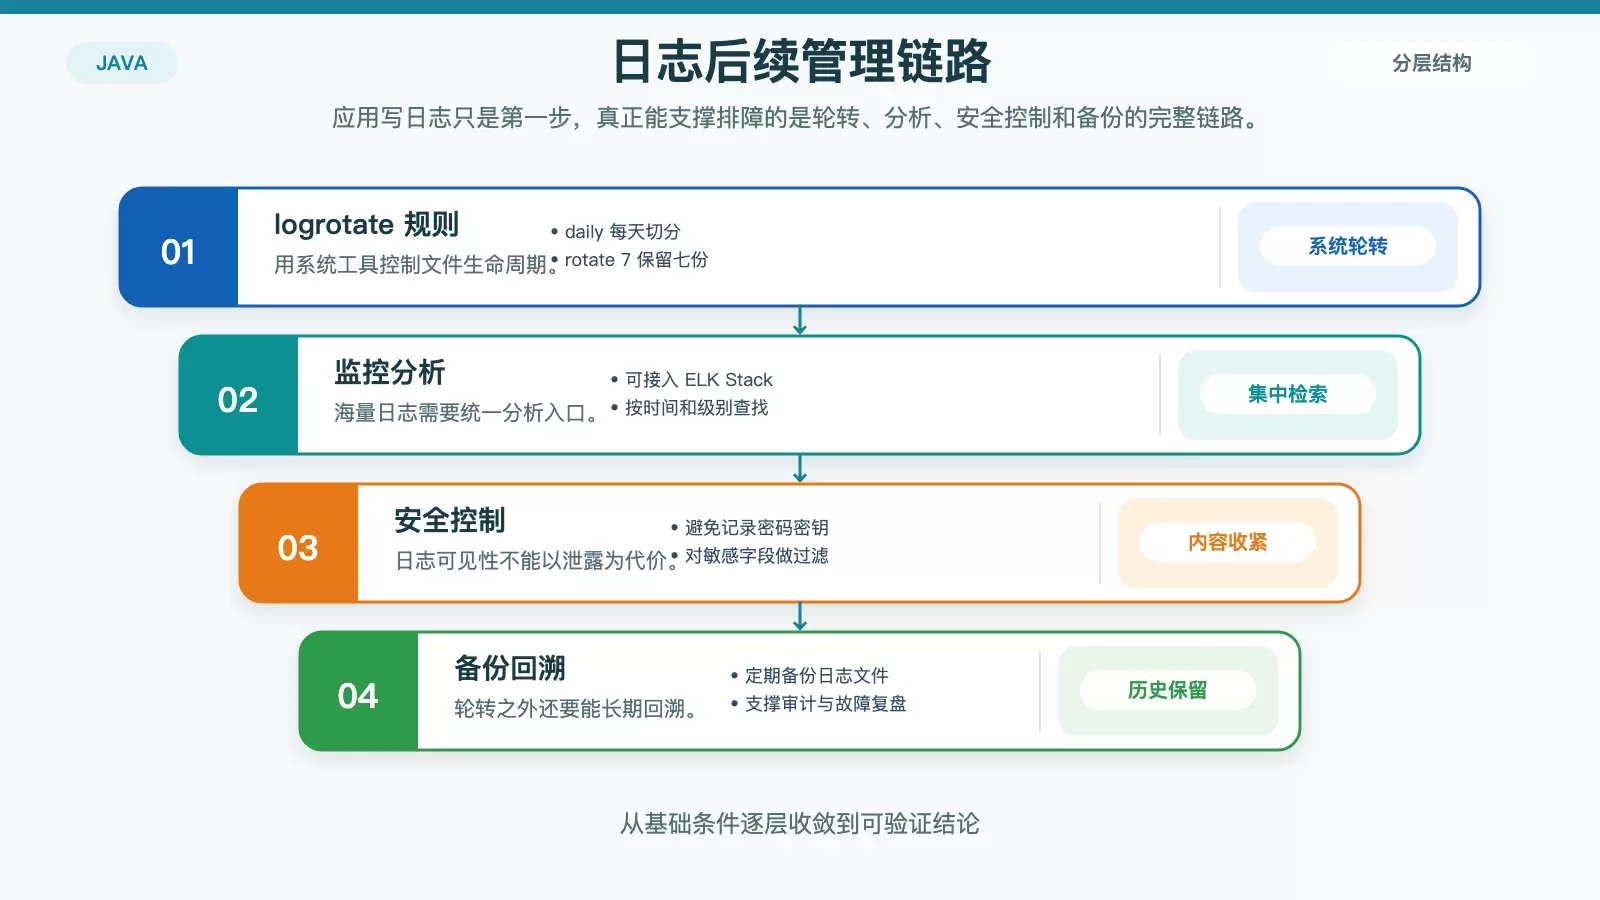
集中监控和分析
当服务数量增加、日志量上来之后,单机上直接翻文件会越来越低效。这时可以考虑引入 ELK Stack,也就是 Elasticsearch、Logstash、Kibana 这一类集中式日志分析平台,用来做统一采集、检索和可视化分析。
它的意义在于:出现异常时,不需要登录多台机器逐个查找文件,而是可以直接按时间、服务、关键字或错误级别缩小范围,从海量日志中快速定位问题。
注意敏感信息泄露
日志里经常会带出请求参数、异常上下文甚至业务字段,如果不加控制,密码、密钥、令牌等敏感信息就可能被直接写入日志。比较稳妥的做法,是在日志级别和输出内容上同时收紧:
- 避免把完整凭据、密钥、口令直接打印出来。
- 对可能包含隐私或认证信息的字段做过滤或脱敏。
- 把高噪声、低价值的调试日志限制在开发或临时排障阶段。
日志系统本身是排障工具,但如果记录内容失控,也会变成合规和安全风险源。
保留备份与历史回溯能力
对于需要审计、故障复盘或长期追踪问题的业务,定期备份日志文件也很必要。原因很简单:轮转只能控制当前机器上的文件生命周期,不能替代独立备份。遇到磁盘损坏、误删文件或需要回溯更长时间范围时,没有备份就很难补救。
更实际的做法是,把“日志输出、轮转、集中分析、备份”看成一条连续链路,而不是几个孤立动作。链路完整了,日志才真正能服务于运维、排障和审计。
一套更稳妥的落地思路
如果把全文压缩成一套可执行的方法,顺序其实很清楚:先根据项目情况确定日志框架,再把级别、格式、文件输出和轮转规则配置好;接着在代码中规范使用 Logger;最后结合 Linux 的 logrotate、集中分析平台、敏感信息控制和备份策略,补齐生产环境所需的管理能力。
对于 Linux 中的 Java 程序来说,日志管理从来不是单一配置项,而是一组相互配合的机制。只要把这些环节提前设计好,日志就不会只是“程序顺手打出来的文本”,而会成为定位故障、观察运行状态和支持审计回溯的基础设施。


