在 Linux 环境里,C++ 代码一旦交付到用户侧,就很难真正做到“看不见、拆不开”。更现实的思路是把保护措施做成分层方案:先判断核心资产是什么,再在编译、封装、混淆和运行时几个环节逐步抬高逆向门槛。下面按常见做法梳理它们各自能解决什么问题、代价在哪里,以及脚本化方案该怎么落地。
先从低成本手段做起:隐藏符号与代码混淆
如果当前目标是先挡住基础级别的分析与反编译,最先可以考虑的是编译器可见性控制和代码混淆。这两类方法部署成本相对低,适合先作为第一层保护。

用 -fvisibility=hidden 降低暴露面
GCC 提供的 -fvisibility=hidden 选项,可以在编译阶段隐藏符号,减少外部能直接看到的函数名和变量名。它并不等于真正意义上的加密,但对很多依赖符号信息的初级逆向方式确实有抑制作用。
这类方案的价值,在于先把“看见什么”这件事控制住。攻击者即便拿到产物,也没法轻松从导出符号里还原出完整的接口语义。
代码混淆适合保护可执行逻辑结构
如果仅隐藏符号还不够,可以继续叠加混淆工具。代码混淆通常会改写变量名、函数名、控制流,甚至插入垃圾代码,让反编译后的结果更难阅读和整理。
例如 obfuscator-llvm 就是常见的基于 LLVM 的混淆工具。它的意义不在于“让代码消失”,而在于把原本容易理解的逻辑,变成难以快速验证和复原的形式,尤其适合需要保护算法流程的场景。
把关键逻辑从主程序中剥离出来
当需要保护的不是全部代码,而是少量核心算法、授权校验或商业规则时,把关键逻辑单独封装,通常比全量加密更实用。
将核心算法封装进动态库
一种常见做法是把核心逻辑打包成动态链接库,也就是 .so 文件,然后对库文件本身再做额外保护。运行时由主程序动态加载这个库,并调用其中的函数。
这样处理后,即使主程序被分析,最关键的实现也不会直接躺在主可执行文件里。对攻击者来说,分析路径会被拆成两段:既要看主程序怎么调度,也要继续研究动态库本身。
第三方工具适合做额外一层封装
除了自己做拆分,也可以借助第三方工具,例如文中提到的 source-to-binary 一类工具。这类工具通常会先把源码转成二进制,再继续做一层加密或封装。
它的思路很直接:即便攻击者已经拿到二进制文件,也不意味着马上就能看到有效机器码,还得先越过外层保护。对希望减少自研成本、快速加上一层外壳的项目来说,这是一条省事路线。
不依赖外部平台时,脚本化流程怎么做
如果你不想引入专门的商业工具,也可以自己搭一个轻量流程。它的优势不在于安全强度特别高,而在于容易接入现有构建脚本,适合作为内部交付、测试文件保护或基础级防窥方案。
示例:用 xxd 和 base64 处理源码
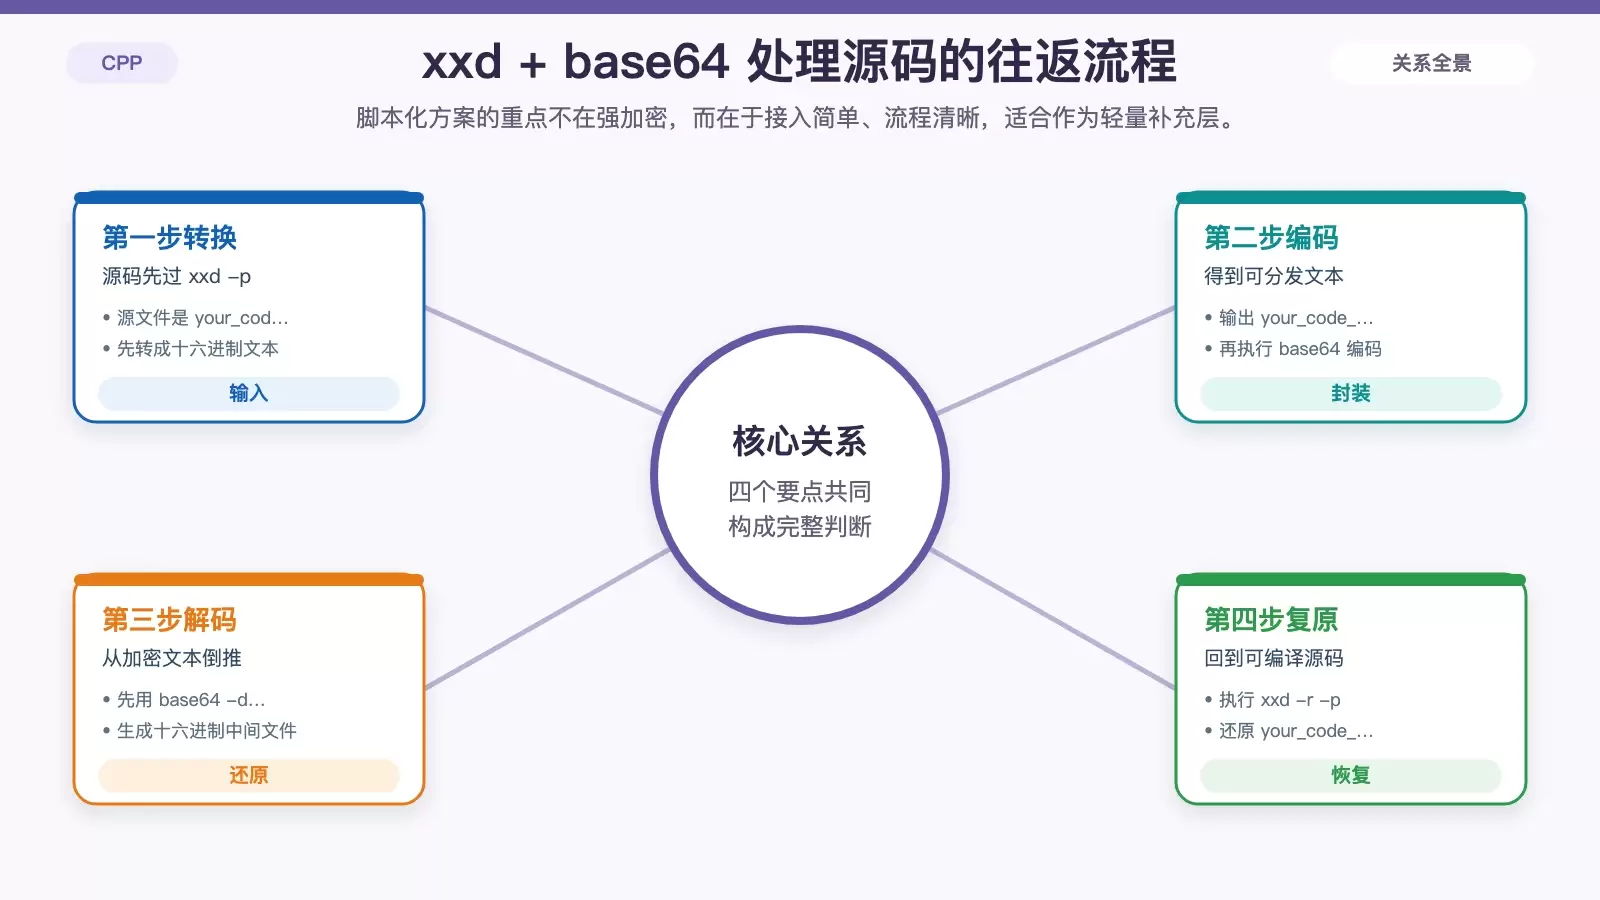
下面是一组最简单的演示命令:先把源码转成十六进制文本,再做 Base64 编码。这样得到的文件不再是可直接阅读的源码内容,至少能避免明文裸放。
# 将源代码转换为十六进制表示
xxd -p your_code.cpp > your_code_hex.txt
# 将十六进制表示编码为base64
base64 your_code_hex.txt > your_code_encrypted.txt
需要恢复时,再按相反顺序解码并还原:
# 将base64编码解码为十六进制表示
base64 -d your_code_encrypted.txt > your_code_hex_decoded.txt
# 将十六进制表示转换回源代码
xxd -r -p your_code_hex_decoded.txt > your_code_decrypted.cpp
这种做法适合什么、不适合什么
这套流程本质上更接近“编码加封装”,而不是强加密。优点是足够轻、足够灵活,能直接嵌进 Shell 脚本或构建流水线;缺点也很明显,面对有经验的逆向人员时,防护能力有限。
所以它更适合以下场景:临时保护源码交付件、减少误读与误打开、为已有保护链条补一层轻量处理。若把它当成核心安全方案,强度通常是不够的。
高安全需求下,要考虑硬件方案与组合防护
当应用场景涉及金融、版权保护或高价值商业算法,仅靠单一的软件层技巧往往不够。此时更应考虑密钥如何保存、算法在哪里执行、攻击面是否可被进一步收缩。
HSM 的价值在于把密钥隔离到硬件里
硬件加密模块,也就是 HSM,适合安全要求极高的场景。它的核心思路是:把密钥和关键算法放进硬件中,由硬件执行加解密操作,软件层面尽量接触不到密钥本身。
这样做的优势非常明确,攻击者即使控制了软件执行环境,也未必能直接拿到核心密钥材料。不过代价同样很高,包括采购成本、集成复杂度以及后期维护要求。
真正有效的方案通常是组合拳
无论采用哪一种手段,都不能把它理解为“彻底阻止逆向”。在 Linux 上保护 C++ 代码,更准确地说,是持续增加破解成本、延长分析时间,并减少核心逻辑被直接复用的概率。
对于高度敏感的代码,更现实的做法往往是多层叠加,例如先做混淆,再做加密封装,把关键逻辑放进动态库,最后在必要场景里引入 HSM。这种组合虽然会增加开发和运维复杂度,但安全收益通常也最明显。
如何按场景选择方案
如果只是普通商业软件,优先考虑 -fvisibility=hidden、动态库拆分和适度混淆,通常就能获得不错的投入产出比。若项目需要快速落地、预算有限,可以再辅以 xxd 与 base64 这类脚本化流程,作为补充层。
如果保护对象是授权逻辑、定价算法或核心知识产权,则应把重点从“源码是否可见”转向“关键能力是否可被复刻”。这时动态库封装、混淆和更高等级的运行时保护更重要;到了极高安全等级,再评估 HSM 是否值得引入。
归根结底,Linux 下不存在一招解决所有问题的 C++ 代码加密方案。能否做好,关键不在于用了多少工具,而在于是否把核心逻辑识别清楚,并为它配置了与价值相匹配的保护层级。


