在 Linux 上做 C++ 日志记录,难点通常不在“能不能写出来”,而在“后面够不够用”。小工具和临时调试,自己写文件就能解决;一旦进入长期运行、并发输出、级别过滤和日志轮转这些场景,方案差异就会迅速放大。下面按使用门槛和能力范围拆开来看,帮助你判断什么时候用标准库,什么时候该上 spdlog、Boost.Log,什么时候又更适合接入 syslog。
用标准库写文件日志:最轻量的起点
C++ 标准库本身没有现成的日志模块,但在 Linux 上,很多简单需求都可以先用 std::ofstream 解决。核心思路很直接:以追加模式打开日志文件,写入时间戳和消息内容,必要时在失败时输出错误信息。
下面这段代码保留了原始做法,适合快速验证、临时调试,或者体量很小的命令行工具:
#include
#include
#include
#include

void logMessage(const std::string& message) {
    std::ofstream logFile("app.log", std::ios::app);
    if (logFile.is_open()) {
        time_t now = time(0);
        char* dt = ctime(&now);
        logFile << "[" << dt << "] " << message << std::endl;
        logFile.close();
    } else {
        std::cerr << "Unable to open log file" << std::endl;
    }
}

int main() {
    logMessage("This is a log message.");
    return 0;
}
这种方式的优点非常明确:
- 不需要额外依赖,几乎所有 Linux 上的 C++ 环境都能直接编译运行。
- 实现成本低,代码可控,适合先把日志能力补上。
- 对输出格式、文件路径有完全控制权,便于针对单个程序做最小实现。
但它的边界也很清楚。原文提到的多线程安全、日志轮转、高级过滤,本质上都不是 std::ofstream 这个层面天然解决的问题。日志量一大,或者多个线程同时写同一个文件,就需要你自己继续补锁、分级、切分文件、刷新策略等机制,维护成本会很快上升。
所以,这种方案更适合两个场景:一是程序规模小,日志只是辅助排障;二是你还在原型阶段,暂时不想引入任何外部库。如果项目已经明确会长期运行,或者部署后需要稳定排查问题,通常就该往成熟日志库过渡了。
第三方日志库怎么选:Boost.Log 与 spdlog
当需求从“写点日志”变成“把日志当成工程能力”,第三方库基本就是必选项。它们的价值不只是多几个 API,而是把日志级别、格式化、线程安全、文件输出、轮转策略这些常见能力整合好了,避免你在业务代码旁边再维护一套半成品日志系统。
Boost.Log:功能完整,但配置和依赖都更重
Boost.Log 属于 Boost 生态的一部分,适合那些已经使用 Boost、或者确实需要较完整日志能力的项目。原文点到的几个特点很关键:文件轮转、控制台输出、自定义格式、多线程安全,这些都更接近企业级项目对日志系统的实际要求。
下面是原文中的初始化示例:
#include
#include
#include
#include
#include
#include

namespace logging = boost::log;
namespace src = boost::log::sources;
namespace sinks = boost::log::sinks;
namespace expr = boost::log::expressions;

void initLogging() {
    // 添加文件日志后端
    typedef sinks::text_file_backend< sinks::file::rotation_size<10*1024*1024>, sinks::file::time_based_rotation > file_backend;
    file_backend backend;
    backend.add_file("app.log");
    backend.auto_flush(true);

    // 添加控制台日志后端
    typedef sinks::synchronous_sink< sinks::text_ostream_backend< sinks::text_ostream_backend::stream_type& > > text_sink;
    text_sink sink(std::cout);
    sink.backends.push_back(backend);

    // 设置日志格式
    expr::stream< expr::keyword::tag< "Severity" >, expr::keyword::tag< "Message" > > formatter = expr::stream
        << "[" << expr::attr< std::string >("Severity") << "] "
        << expr::attr< std::string >("Message");
    sink.set_formatter(formatter);

    // 添加日志属性
    logging::add_common_attributes();

    // 注册日志记录器
    logging::core::get()->add_sink(sink);
}

int main() {
    initLogging();
    BOOST_LOG_TRIVIAL(info) << "This is an info message.";
    BOOST_LOG_TRIVIAL(warning) << "This is a warning message.";
    BOOST_LOG_TRIVIAL(error) << "This is an error message.";
    return 0;
}
从这个例子就能看出 Boost.Log 的典型特征:能力强,但配置项不少。它更像一个完整框架,而不是一组轻量函数。对于大型服务来说,这反而是优势,因为你可以统一格式、统一 sink、统一日志属性;但对小团队或中小项目来说,编译依赖、接入成本和学习曲线都不算低。
如果你的项目本来就已经在用 Boost,那么继续引入 Boost.Log 往往顺理成章;如果项目对依赖非常敏感,只是想补一套够用、够快的日志能力,它未必是第一选择。
spdlog:轻量、直接,适合多数现代 C++ 项目
相比 Boost.Log,spdlog 近年来更受欢迎,一个重要原因就是它把“易集成”和“高性能”结合得更好。原文提到它支持 header-only 模式,同时能输出到控制台、文件、syslog 等多个目标,这正好覆盖了大多数 Linux 服务程序的常见需求。
下面是原文中的示例代码:
#include "spdlog/spdlog.h"
#include "spdlog/sinks/stdout_color_sinks.h"
#include "spdlog/sinks/basic_file_sink.h"

int main() {
    // 创建控制台日志记录器
    auto console_sink = std::make_shared();
    console_sink->set_pattern("[%Y-%m-%d %H:%M:%S] [%l] %v");
    spdlog::register_logger(console_sink);

    // 创建文件日志记录器
    auto file_sink = std::make_shared("app.log", true);
    file_sink->set_pattern("[%Y-%m-%d %H:%M:%S] [%l] %v");
    spdlog::register_logger(file_sink);

    // 获取日志记录器
    auto logger = spdlog::get("console");
    logger->info("This is an info message.");
    logger->warn("This is a warning message.");
    logger->error("This is an error message.");

    return 0;
}
从使用体验来看,spdlog 的优势主要集中在几个方面:
- 接入快,API 直观,适合希望尽快落地的项目。
- 格式化能力强,日志输出样式容易统一。
- 性能表现好,适合日志频率较高的服务端程序。
- 依赖相对轻,不像完整 Boost 生态那样对构建环境提出更高要求。
原文把它总结为“在轻量级和性能之间取得了很好的平衡”,这基本符合很多实际项目的选型逻辑。对于没有历史包袱的新项目,尤其是只想稳定获得分级、格式化、多目标输出这些核心功能的团队,spdlog 往往是更省事的那一个。
接入 syslog:交给 Linux 系统统一管理
除了自己写文件和接第三方库,Linux 还提供了系统级日志通道,也就是 syslog。这类方案的思路不是“程序自己管理日志文件”,而是把消息发给系统日志守护进程,再由系统侧统一落盘、归类和监控。
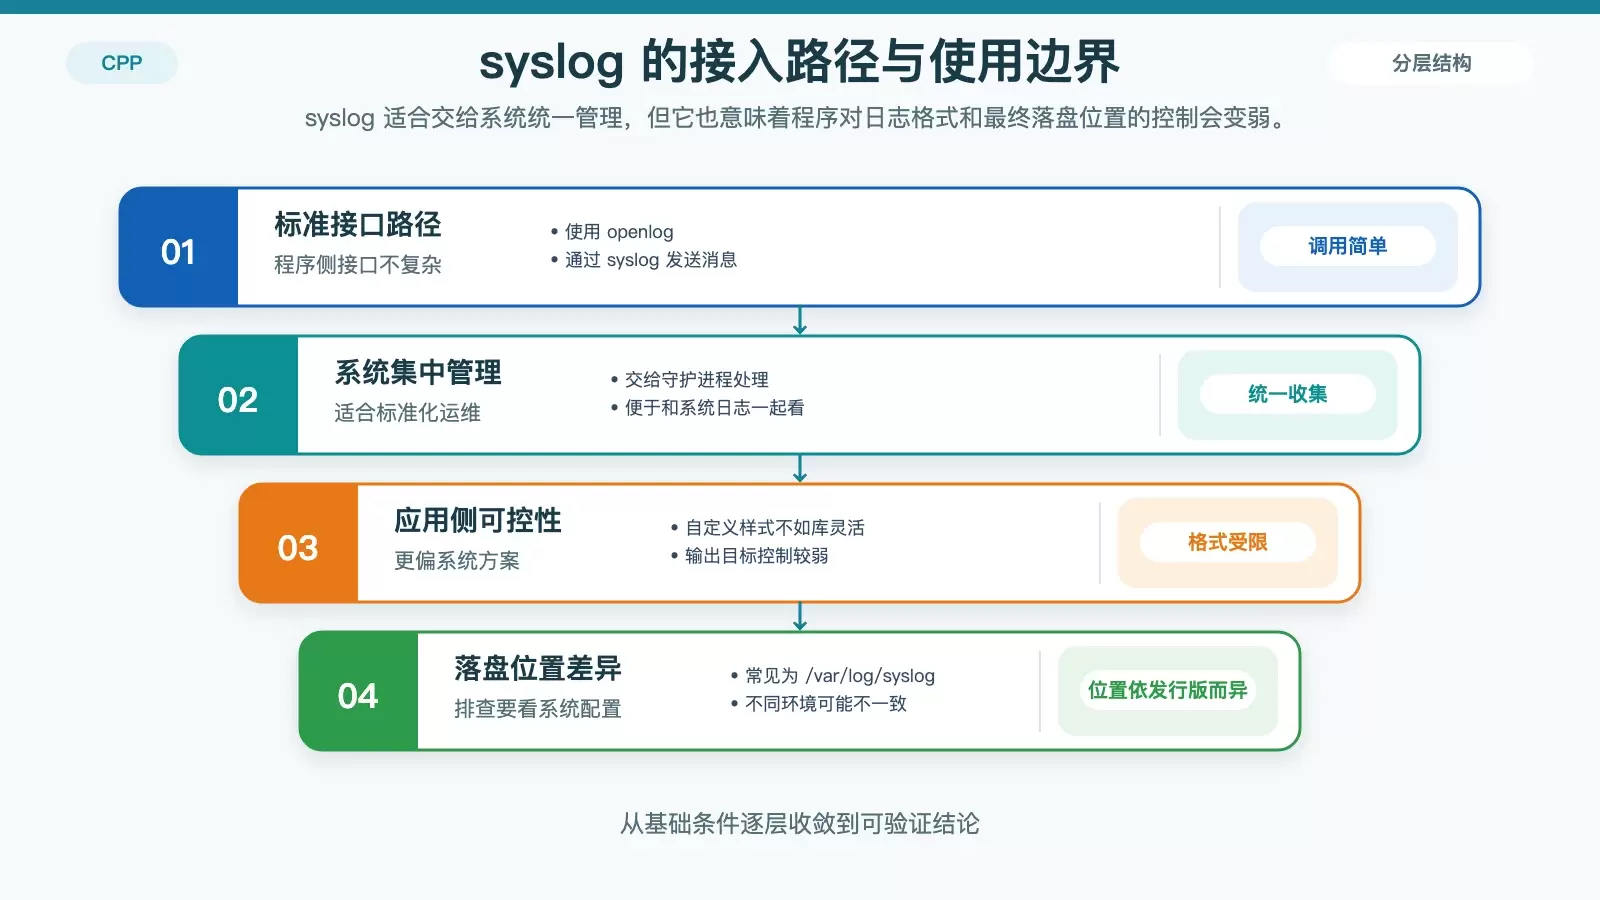
原文示例使用的是 syslog.h 提供的标准接口:
#include
#include
#include

void logMessage(const std::string& message) {
    openlog("myapp", LOG_PID | LOG_CONS, LOG_USER);
    syslog(LOG_INFO, "%s", message.c_str());
    closelog();
}

int main() {
    logMessage("This is a log message.");
    return 0;
}
这种方式的最大特点是“融入 Linux 运维体系”。程序只负责发送日志,系统负责后续处理。对已经依赖 rsyslog 或其他系统日志守护进程的环境来说,这样做有几个现实好处:
- 不需要程序自己维护日志文件管理逻辑。
- 日志能和系统其他服务一起集中查看、汇总和监控。
- 对运维侧更友好,特别适合部署到标准化 Linux 服务器环境。
但 syslog 的代价同样明显。原文已经指出,它在自定义格式和输出目标方面不如专门的日志库灵活,而且日志位置通常在 /var/log/syslog,但不同发行版可能并不完全一致。这意味着,程序开发者对最终落盘形式的控制较弱,排查时也要更多依赖目标机器的系统日志配置。
如果你的程序本身只是系统中的一个组件,希望统一纳入 Linux 日志体系,syslog 很合适;如果你需要非常细粒度的格式定制、专属文件结构或应用级轮转策略,那么专门日志库通常更稳妥。
怎么按项目场景选型
把这三类方案放在一起看,选型其实可以围绕几个问题展开:项目规模有多大、是否多线程、是否需要日志级别和轮转、部署后由开发还是运维主导排障。

可以按下面的思路快速判断:
- 如果只是临时调试、小工具、单机脚本式程序,标准库写文件通常已经够用。
- 如果程序会长期运行,且需要级别、格式化、多线程支持、文件管理等能力,优先考虑第三方日志库。
- 如果部署环境强调与 Linux 系统统一监控、统一收集,syslog 更容易融入现有运维流程。
- 如果你已经全面使用 Boost,Boost.Log 会更自然;如果想控制依赖体量并尽快落地,spdlog 往往更合适。
从原文给出的判断来看,最推荐的平衡点仍然是 spdlog。它不像手写文件那样需要后续补很多工程能力,也不像 Boost.Log 那样在轻量项目中显得偏重。对大多数现代 C++ Linux 项目来说,先用 spdlog 建立统一日志接口,再视部署需要扩展到文件、控制台或 syslog,是一条更实际的路径。


