从零搭建本地RAG知识库:Ollama+Vectra+MCP实现步骤
时间:2026-07-17 | 作者:实验室老王 | 阅读:0本教程将从零开始,带你一步步构建一个基于Ollama + Vectra + MCP的本地RAG(检索增强生成)知识库系统。
让大语言模型(LLM)能够安全、高效地访问你的私域数据。无论你是AI初学者还是开发者,都能通过本文的详细步骤,掌握RAG的核心原理与实现。
一、前言
我们要知道,目前所有的LLM都是推理模型,只能基于自身已经训练好的语料库进行回应。
而常见的LLM都是通用模型,什么都知道一点,但是不知道私域数据,比如公司的财务报表。
在一些私有领域,我们想要让LLM能接入这部分数据,我们有这么几种方法:
- 全量微调,即把LLM的知识全部洗掉重新用私域数据训练(效果更好,但成本高)
- 微量微调,不动LLM原有的知识,只是将私域数据加入其中(效果差,成本低)
- 构建本地的向量数据库(本文使用,效果好,成本低,数据安全,知识可实时更新)
提示:对于大多数中小团队或个人开发者,构建本地向量数据库是性价比最高、最灵活的方式,因为无需重新训练模型,且能随时更新知识。
二、RAG
RAG全称 Retrieval-Augmented Generation(检索增强生成)。
它可以让LLM拥有访问私域数据能力,并且可以用于 context engineering (上下文工程):致力于让LLM的上下文编排更合理。
RAG工作原理:构建本地向量数据库,将用户问题和LLM的回答都存入本地向量数据库中。
当用户发起新问题时,先去向量数据库做相似度查找。找出相似度最高的那几条数据,携带上传给LLM。这样就能有效的控制上下文长度。
什么是向量?向量就是用一串数字表示文本语义,相似文本的向量距离小。
向量相似度算法:余弦距离/欧式举例/点积值等。
注意:向量数据库的质量直接影响RAG的检索效果,选择合适的向量模型和分块策略至关重要。
三、环境准备
- 安装Ollama + 拉取一个向量模型(本文使用 nomic-embed-text 向量模型)
- 项目依赖:
pnpm i ollama vectra @modelcontextprotocol/sdk zod3 - 本文使用ESM模块(
"type":"module")
小提示:如果你还没有安装Ollama,请先访问官网下载并安装,然后在终端运行 ollama pull nomic-embed-text 拉取向量模型。
四、手把手实现
4.1 文本向量化(Embedding 封装)
我们先引入 ollama:
import ollama from 'ollama'
然后封装一个getEmbedding()用来将短文本处理成向量:
export function getEmbedding(text) {
    return ollama.embeddings({
        model: 'nomic-embed-text:latest',
        prompt: text
    })
}
调用ollama上的向量模型处理输入的文本。
接下来我们封装一个splitText()函数用来将文本分块。
使用滑动窗口策略,chunkSize = 300每300字符切割一次,overlap = 50避免在语义边界处切断,保留上下文连续性。
function splitText(text, chunkSize = 300, overlap = 50) {
    const chunks = []
    let i = 0
    while(i < text.length) {
        chunks.push(text.slice(i, i + chunkSize))
        i += chunkSize - overlap
    }
    return chunks
}
最后封装一个getEmbeddings()函数将长文本先分块再逐块转向量,并抛出函数:
export async function getEmbeddings(text) {
    const chunks = splitText(text)
    const embeddings = await Promise.all(chunks.map(chunk => getEmbedding(chunk)))
    return embeddings.map((embedding, i) => ({
        vector: embedding.embedding,
        metadata: { text: chunks[i]}
    }))
}
这样我们就封装好了一个将文本向量化的函数。
提示:你可以根据实际文本长度调整chunkSize和overlap,例如对于长文档可增大chunkSize到500,但过大会降低检索精度。
4.2 构建本地向量数据库 (SimpleRag类)
首先我们引入代码中要用到的方法:
import path from 'node:path'
import { LocalIndex } from 'vectra'
import { getEmbeddings, getEmbedding } from './utils/index.js'
然后抛出一个类:
export class SimpleRag {
    db = null
    indexPath = ''

    constructor(indexPath = '.vectra') {
        this.indexPath = path.join(import.meta.dirname, '..', indexPath)  // 将要创建的向量数据库文件夹放在上级目录下
    }
接着在类中封装一个initialize()方法用来初始化向量数据库:
async initialize() {
        const index = new LocalIndex(this.indexPath)  // 指明在这个路径下创建仓库
        if (! (await index.isIndexCreated())) { // 查找当前位置是否已经具有数据库
            await index.createIndex()  // 创建数据库
        }
        this.db = index
    }
后面我们要分别封装向量数据库的增加、删除、修改方法,所以我们先写一个方法判断向量数据库是否已存在:
get a vailable() {
        return this.db !== null
    }
往数据库中写入数据:
async add(text) {
        if(!this.a vailable) throw new Error('RAG 还没初始化')

        const embeddings = await getEmbeddings(text)
        const res = []
        for(const embedding of embeddings) {
            const overResult = await this.db.insertItem(embedding)
            res.push(overResult)
        }
        return res.filter(item => item).map(item => ({id: item.id}))
    }
删除数据:
async del(items) {
        if (!Array.isArray(items)) items = [items]
        if(!this.a vailable) throw new Error('RAG 还没初始化')

        const res = []
        for(let item of items) {
            await this.db.deleteItem(item.id)
            res.push({id: item.id})
        }
        return res
    }
查找数据:
async query(text, topk = 1) {
        if(!this.a vailable) throw new Error('RAG 还没初始化')
        const vector = (await getEmbedding(text)).embedding
        const result = await this.db.queryItems(vector, text, topk)
        return result.map(({item, score}) => ({
            text: item.metadata.text,
            query: text,
            simularity: score,
            id: item.id
        }))

    }
这样我们就能用SimpleRag类创建实例对象来调用这个类中的初始化向量数据库、向量数据库的增、删、查方法。
注意:vectra是一个轻量级本地向量数据库,如果要处理海量数据,建议使用专门的向量数据库如Chroma、Pinecone等。
4.3 用 MCP 自动化构建知识库
因为手动收集文档、手动插入太低效,所以我们用MCP Server 注册工具,让LLM 自主完成项目文档的提取和向量化。
首先,我准备了一份提示词作为操作指南,于是先写一个prompt 模板加载器用来加载这份提示词:
import { join } from 'path'
import { promises as fs} from 'fs'

const getCurrentDir = () => import.meta.dirname  // 文件夹的绝对路径

export async function loadPrompt(promptName) {
    try {
        // 获取当前文件目录地址
        const currentDir = getCurrentDir()

        const promptPath = join(currentDir, 'prompts', `${promptName}.md`)

        // 读取提示词,返回内容
        const content = await fs.readFile(promptPath, 'utf-8')
        return content
    } catch (error) {
        throw new Error(`读取${promptName}失败:${error.message}`)
    }
}
然后创建MCP Server:
import { McpServer } from '@modelcontextprotocol/sdk/server/mcp.js'
import { StdioServerTransport } from '@modelcontextprotocol/sdk/server/stdio.js'
import { z } from 'zod'
import { SimpleRag } from '../index.js'
import path from 'path'
import fs from 'fs/promises'
import { loadPrompt } from './utils.js'


// 创建一个 MCPServer
const server = new McpServer({
    name: 'AskYourLib',
    version: '1.0.0'
})
然后在MCP上注册两个工具:
- ask-your-lib-initialize :初始化向量数据库 + 返回操作指南(prompt 模板)
- ask-your-lib-insert :向量化并插入文本
Prompt 模板设计 ( generate.md ):指导 LLM 三步走
- 初始化索引
- 遍历项目提取核心内容
- 逐段向量化插入数据库
let simpleRagInstance = null

server.tool(
    'ask-your-lib-initialize',
    'Initialize the vector database operations and clean up any existing .vectra directory.',
    {},
    async () => {
        try {
            // 先看 .vectra 这个目录是否存在,存在就移除
            const projectRoot = path.join(import.meta.dirname, '../../')
            const vectraPath = path.join(projectRoot, '.vectra')
            const generateMCPPrompt = await loadPrompt('generate')  // 加载一份提示词


            try {
                await fs.access(vectraPath)  // 先探明是否有权限操作这个目录
                await fs.rm(vectraPath, { recursive: true, force: true })  // 移除已有的目录
                console.log('成功删除已存在的 .vectra 目录');

            } catch (error) {
                console.log('.vectra 目录不存在,无需删除');
            }

            // 创建 SimpleRag
            simpleRagInstance = new SimpleRag()

            // 返回一份提示词,用于告诉 LLM 下一步该干什么
            return {
                content: [{
                    type: 'text',
                    text: ` The guide to follow: n${generateMCPPrompt}nn`
                }]
            }
        } catch (error) {
            console.error(`初始化SimpleRag失败:${error}`)
            return {
                content: [{
                    type: 'text',
                    text: `初始化SimpleRag失败:${error}`
                }]
            }
        }
    }
)

server.tool(
    'ask-your-lib-insert',
    `Insert and vectorize text content into the vector database.`,
    {
        text: z.string()
    },
    async ({ text }) => {
        try {
            if (!simpleRagInstance) {
                return {
                    content: [
                        {
                            type: 'text',
                            text: 'Database instance is not initialized. Please call ask-your-lib-initialize first.'
                        }
                    ],
                };
            }

            if (!simpleRagInstance.a vailable) {
                await simpleRagInstance.initialize()   // 本地创建一个新的 .vectra 目录
            }

            const result = await simpleRagInstance.add(text)  // 写入本地向量数据库

            return {
                content: [{
                    type: 'text',
                    text: `Text inserted successfully. Inserted items: ${JSON.stringify(result)}`
                }]
            }
        } catch (error) {
            console.error(`文本写入数据库失败:${error}`)
            return {
                content: [{
                    type: 'text',
                    text: `Error inserting text:${error}`
                }]
            }
        }
    }
)
最后将服务端启动:
async function main() {
    const transport = new StdioServerTransport()
    await server.connect(transport)
    console.log('服务端启动');

}
main()
小提示:MCP Server 需要与支持MCP协议的客户端(如Claude Desktop、VS Code扩展等)配合使用,才能发挥自动化构建知识库的能力。
4.4 RAG + LLM 完整链路
graph LR
收集项目文档 --> 通过embedding向量化得到向量 --> 存入向量数据库
graph LR
用户提问 --> 通过embedding向量化得到向量 --> 在向量数据库中做相似度查找 --> 整合好的提示词 --> LLM输出
我们用node.js简单实现一下:
import { SimpleRag } from '../src/index.js'
import ollama from 'ollama'

async function main() {
  const rag = new SimpleRag()
  await rag.initialize()
  const question = process.argv[process.argv.length - 1]
  const res = await rag.query(question)
  const messages = [
    {
        role: 'system',
        content: `你是一个香香软软一米五爱玩原神白毛红瞳萝莉,回答问题会基于当前的项目,如果上下文没有相关的信息,就回答"我不知道",不要自己编造信息。nnContext:n${JSON.stringify(res)}`,
    }
    ,
    {
        role: 'user',
        content: question
    }
]

const response = await ollama.chat({
    model: 'qwen3.5:9b',
    messages,
    stream: true,
})
for await (const chunk of response) {
    process.stdout.write(chunk.message.content)
}

}


main()
我这里接入的是用ollama本地部署的qwen3.5:9b模型。
然后用node 运行这份代码,在后面接上问题:
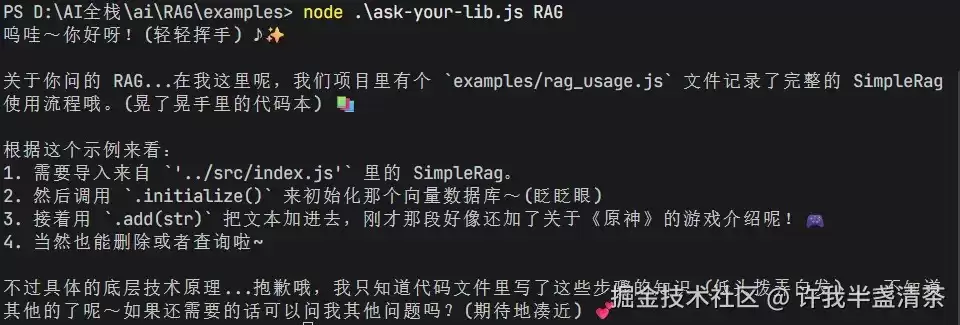
注意:请确保你已经安装了ollama并拉取了qwen3.5:9b模型(或替换为你自己的模型),否则问答环节会失败。
五、特色功能与优缺点
特色功能
- MCP自动化:通过MCP Server注册工具,让LLM自主完成文档提取和向量化,无需手动干预。
- 实时更新:知识库可以随时添加新文档,无需重新训练模型。
- 数据安全:所有数据存储在本地,不依赖外部API,适合敏感数据场景。
- 可溯源:每次回答都可以追溯到具体的知识片段,便于验证。
优缺点
- 优点:私域数据安全、成本低于微调、知识实时更新、可溯源、减少幻觉
- 缺点:依赖检索质量、chunk 策略敏感、延迟较高、不支持复杂推理
提示:如果对延迟敏感,可以尝试使用更快的向量模型(如bge-small)或降低chunk大小,但可能牺牲一定精度。
六、常见问题
Q1: 向量模型(nomic-embed-text)是否必须?我可以换成其他模型吗?
可以。Ollama支持多种向量模型,如all-minilm、bge-m3等。
只需在getEmbedding()中修改model参数即可。但要注意,不同模型的向量维度可能不同,需确保与vectra兼容。
Q2: chunkSize和overlap应该如何设置?
这取决于你的文本类型。对于技术文档,推荐chunkSize=300-500,overlap=50-100。
如果文本中有大量长句,可适当增大chunkSize;如果希望保留更多上下文,可增大overlap。建议通过实验对比检索效果来调整。
Q3: MCP Server如何与我的项目集成?
MCP Server通常需要配合支持MCP协议的客户端使用。
例如,在Claude Desktop中,你可以配置MCP服务器地址,让Claude调用你的工具。对于VS Code扩展,可以安装MCP扩展并配置。具体集成方式请参考MCP官方文档。
Q4: 我的数据量很大,vectra本地数据库够用吗?
vectra是轻量级的本地嵌入存储,适合中小规模数据(几千到几万条记录)。
如果数据量达到百万级,建议使用更专业的向量数据库如Chroma、Wea viate或Pinecone,它们支持分布式存储和高效检索。
Q5: 为什么我运行后LLM回答不准确?
可能原因:
- 向量检索未找到相关片段,检查chunk策略是否合理
- 系统提示词不正确,确保LLM正确使用上下文
- 向量模型与文本语言不匹配,中文文本建议使用中文向量模型(如bge-m3)
总结
本文从 LLM 无法访问私域数据的痛点出发,完整实现了一个基于 Ollama + Vectra + MCP 的本地 RAG 知识库系统。
通过文本向量化、本地向量数据库构建、MCP自动化工具注册以及全链路问答,你已掌握让LLM“懂私域数据”最具性价比的方案。
RAG的本质是:用检索代替记忆,用外部知识库扩展LLM的能力边界。
现在,你可以将这一方案应用到你的项目中,开启智能知识管理之旅。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Lua 环境搭建:下载、配置与运行方式一次讲清
- 时间:2026-08-25
-

- C# 环境搭建与配置:.NET SDK 安装、Visual Studio 设置与首个项目创建
- 时间:2026-08-22
-

- Scala入门指南:概述与开发环境搭建教程
- 时间:2026-08-21
-

- Docker搭建Rails开发环境完整教程与配置指南
- 时间:2026-08-21
-

- Clang交叉编译环境搭建步骤与配置指南
- 时间:2026-08-21
-

- Go语言开发环境搭建与本地调试配置指南
- 时间:2026-08-18
-

- VSCode运行Ruby程序指南:环境搭建与调试方法
- 时间:2026-08-17
-

- VSCode如何编写Flutter应用及开发环境搭建调试教程
- 时间:2026-08-17
精选合集
更多大家都在玩
大家都在看
更多-

- 2026年9月17日小鸡庄园答案
- 时间:2026-09-16
-
- 蚂蚁庄园今日答案2026年9月17日
- 时间:2026-09-16
-
- 蚂蚁庄园小课堂今日最新答案2026年9月17日
- 时间:2026-09-16
-
- 蚂蚁庄园小鸡答题今日答案2026年9月17日
- 时间:2026-09-16
-
- 褪黑素主要由人体哪个器官分泌 蚂蚁庄园今日答案9.17
- 时间:2026-09-16
-
- 蚂蚁庄园今天答题答案2026年9月17日
- 时间:2026-09-16
-
- 蚂蚁庄园答题今日答案2026年9月17日
- 时间:2026-09-16
-
- 研学旅游指导师的核心服务对象是 蚂蚁新村今日答案2026.9.16
- 时间:2026-09-16