智源研究院发布的全新通用世界基础模型悟界·RoboBrain Orca
时间:2026-07-21 | 作者:游戏探长 | 阅读:0悟界·RoboBrain Orca是什么
先说一个核心判断:如果AI继续沿着“下一个词预测”的老路走,终究会碰到天花板。
智源研究院最新发布的悟界·RoboBrain Orca,走了一条完全不同的路——它不预测下一个词,也不预测下一帧或下一个动作,而是直接预测“世界的下一个状态”。
这背后是12.5万小时视频和1.6亿条事件标注的训练支撑。模型在内部建立起一套统一的世界潜在表征。
通俗点说,就是AI学会了物理世界运转的“内功心法”,然后基于这套心法去生成文本、预测图像,甚至指挥机器人干活。
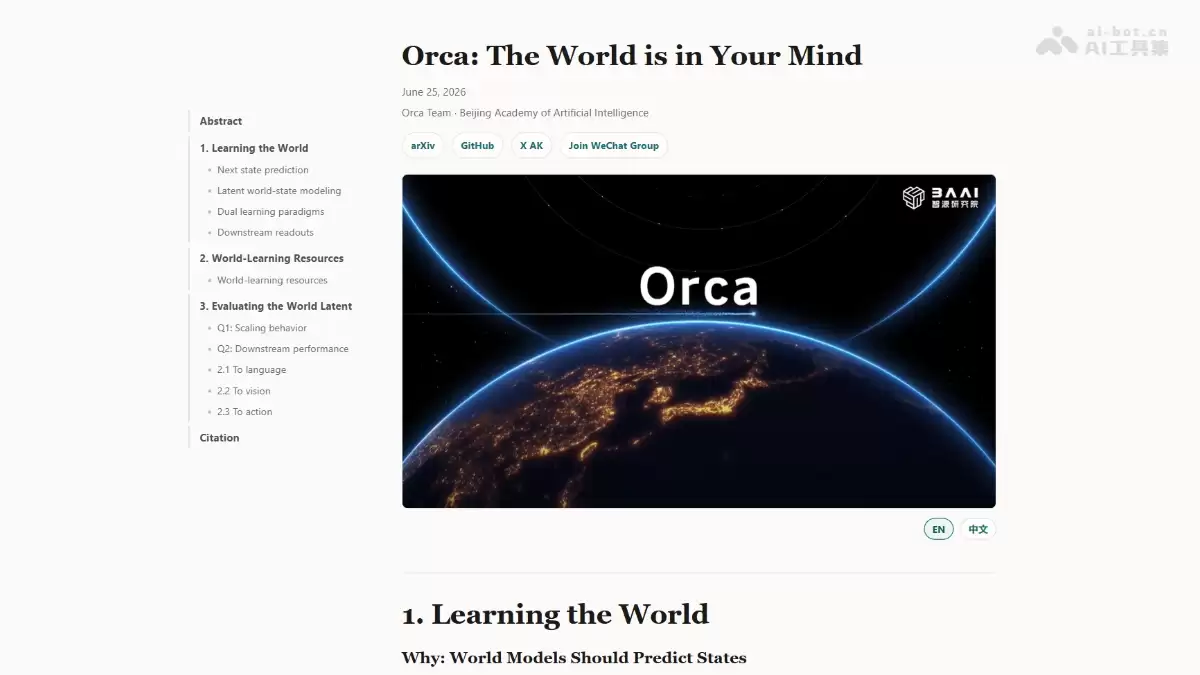
悟界·RoboBrain Orca的主要功能
- 世界状态建模:把视觉、语言等多模态信号全部浓缩进一个统一的世界潜在表征空间。
- 文本生成:基于这个潜在表征,通过语言模型头输出文本回答,做视觉问答也不在话下。
- 图像预测:给定当前画面和指令,预测真实世界交互后的下一状态图像——注意,这不是生成好看的图片,而是预测物理上会发生什么。
- 具身动作生成:从世界表征里直接读出机器人该怎么做,双臂操作这类OOD任务也能搞定。
悟界·RoboBrain Orca的技术原理
从架构上看,Orca走的是Encoder-Decoder路线:Encoder负责把世界信号压缩成统一的潜在表征,Decoder再把这套表征“翻译”成具体的输出。
关键是其学习机制,很有新意:
- 无意识学习:从连续视频里学到密集、自然的状态转移,不依赖人工标签,靠的是预测下一帧的潜在表示来实现。
- 有意识学习:用语言描述的事件和VQA数据,去学那些稀疏但真正有语义意义的状态转移,说白了就是让模型理解因果和意图。
- 双路径预训练:同时优化三个目标——观察驱动的状态转移、事件驱动的状态转移,还有VQA的响应生成。
- 冻结主干+轻量读出:预训练完主干就冻住了,下游场景只需要训练MLP适配器、LoRA或者动作专家这类轻量模块,成本可控。
如何使用悟界·RoboBrain Orca
想上手试试?流程其实挺清晰的。
先去GitHub仓库把开源代码和预训练权重都下下来。数据方面需要多模态信号——连续视频、语言事件描述、视觉问答对,缺一不可。
然后就是冻结Orca主干,根据你要解决的具体问题接入对应的轻量模块。最后在机器人操作、视觉问答或者状态预测这些任务上跑推理就行,也可以拿少量域内数据做个后训练微调。
- 获取资源:从 https://github.com/orca-wm 下载开源代码与预训练模型权重文件。
- 准备数据:收集多模态世界信号数据,包括连续视频、语言事件描述及视觉问答对。
- 接入模块:冻结Orca主干网络,根据目标场景接入轻量读出模块(LM head、图像解码器或Action Expert)。
- 部署应用:在机器人操作、视觉问答或状态预测等下游任务中执行推理,或用少量域内轨迹进行后训练微调。
悟界·RoboBrain Orca的核心优势
- 统一表征空间:语言、图像、动作不再是各玩各的,而是同一个世界潜在空间的不同出口。
- 物理一致性预测:图像预测更关注真实物理过程和状态转换,避免了传统生成模型里物体凭空出现那种尴尬局面。
- 零样本泛化能力:动作生成这块,预训练时完全没用任何动作标签,仅靠200条域内轨迹后训练,效果就能超过专用基线——这个结果其实挺有意思。
- 持续Scaling潜力:训练损失随数据量和模型规模持续下降,目前只用了十分之一左右的数据,提升空间还很大。
悟界·RoboBrain Orca的项目地址
- 项目官网:https://orca-wm.github.io/
- GitHub仓库:https://github.com/orca-wm/Orca
- HuggingFace模型库:https://huggingface.co/papers/2606.30534
- arXiv技术论文:https://arxiv.org/pdf/2606.30534
悟界·RoboBrain Orca的同类竞品对比
拿Meta的V-JEPA 2.1做个对比,差异一目了然:
| 维度 | Orca | V-JEPA 2.1 |
|---|---|---|
| 机构 | 智源研究院(BAAI) | Meta AI |
| 核心范式 | Next-State-Prediction(状态转移建模) | Next-Frame Prediction(视频预测) |
| 学习路径 | 无意识学习+有意识学习(双路径) | 自监督视频特征学习 |
| 数据规模 | 12.5万小时视频+1.6亿事件标注 | 大规模未标注视频 |
| 下游支持 | 文本、图像、动作三模态读出 | 主要支持视觉与动作表征 |
| 动作生成 | 主干冻结,200条轨迹即可OOD泛化 | 需更多机器人数据微调 |
| 状态转移理解 | 显式建模事件级因果与语义状态转移 | 侧重像素级与特征级一致性 |
悟界·RoboBrain Orca的应用场景
- 机器人操作规划:基于对世界状态转移的理解,为机械臂生成符合物理规律的动作,开抽屉、叠衣物这类复杂交互任务都能应对。
- 自动驾驶决策:通过预测交通场景里车辆和行人的状态演化,提前预判潜在风险,规划出安全路径。
- 具身智能体训练:作为通用世界表征接口,给不同机器人平台提供预训练知识,省掉大量新任务的数据采集成本。
- 交互式视频理解:根据自然语言指令预测视频后续发展,支持因果推理问答和事件推演。
- 物理仿真与数字孪生:构建能推理、能预测的世界状态模型,用在工业虚拟环境推演和物理过程模拟上。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Mellum2混合专家模型解析:JetBrains开源AI项目介绍
- 时间:2026-08-21
-
- 智源清华Brainμ登上Science揭示记忆与睡眠调控神经机制
- 时间:2026-08-18
-
- VSCode与JetBrains安装Qoder CN插件及登录使用教程
- 时间:2026-07-18
-
- 阿里云Qoder CN官方安装指南:客户端与全系列插件配置
- 时间:2026-07-18
-
- Qoder CN安装教程:独立IDE与VS/JetBrains插件
- 时间:2026-07-18
-
- Qoder CN安装教程:独立IDE、JetBrains、VSCode插件
- 时间:2026-07-18
-
- Qoder CN完整安装教程:独立IDE、JetBrains、VSCode插件分步指南
- 时间:2026-07-18
精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 精浓度越高消毒效果越好吗
- 时间:2026-09-22
-
- 蚂蚁庄园每日答题答案2026年9月23日
- 时间:2026-09-22
-
- “秋高气爽”主要是由于秋季空气中哪种成分减少 蚂蚁庄园今日答案9月23日
- 时间:2026-09-22
-
- 农谚“一场秋雨一场寒”描述的是秋季哪种天气现象 蚂蚁庄园今日答案9.23
- 时间:2026-09-22
-
- 蚂蚁庄园今天答题答案2026年9月23日
- 时间:2026-09-22
-
- 蚂蚁庄园答题今日答案2026年9月23日
- 时间:2026-09-22
-
- 蚂蚁庄园小课堂2026年9月23日最新题目答案
- 时间:2026-09-22
-
- 小鸡答题今天的答案是什么2026年9月23日
- 时间:2026-09-22