LangChain+LangGraph架构拆解:大模型复杂AI任务编排与状态管理
时间:2026-07-25 | 作者:星河游者 | 阅读:0聊到大模型应用开发,大多数人绕不开的第一个门槛,就是调API。上手确实简单,搭个基础问答、跑个文本生成,基本都能在几行代码里搞定。但说实话,真正想要落地,单纯调API那点“料”太单薄了,根本撑不起复杂业务。
一旦涉及联网检索、工具调用、多步推理、循环纠错、多智能体协作这类高阶功能,原生API的短板就会被无限放大。如果完全靠手写代码去实现,逻辑混乱、重复劳动、后期维护令人头大,完全达不到生产环境的标准。
所以,大模型应用开发,几乎绕不开LangChain和LangGraph这两个框架。不管你是要做实际项目,还是想系统学习,这两者都是核心。
今天我们从实际应用出发,由浅入深地拆解一下这两套框架的核心逻辑、架构差异和落地场景——从最简单的线性链式开发,逐步过渡到进阶的图式编排。一起看看LangChain的能力边界在哪里,LangGraph的核心价值又是什么。
两大框架的核心定位
LangChain的定位:基础与快速开发
LangChain可以说是目前大模型应用开发最主流的基础开源框架。它的核心定位非常明确——简化大模型应用的快速开发。本质上,它是一套标准化的组件库与开发规范,解决了原生API能力单一、重复开发的问题,让我们不用再重复造轮子。
具体来说,LangChain主要解决了以下几个痛点:
在没有LangChain之前,做提示词模板封装、对话记忆、工具调用、文档问答、链路串联,都得手动写大量冗余代码,适配不同模型和场景,效率极低。而LangChain把这些高频能力全部封装成标准化的、可复用的组件,按需调用、自由组合,就能快速搭建各类应用。
它的核心设计理念是链式执行,也就是线性流水线逻辑。任务按固定顺序依次执行,A步骤完成后,结果作为B步骤的输入,层层递进,形成完整链路。这种设计的优势很明显:上手简单、逻辑清晰、开发速度快,非常适合入门。
但短板也同样突出,这也是LangGraph诞生的根本原因。核心局限集中在两方面:
- 流程固化:线性链式结构没法支持复杂的业务逻辑,比如分支判断、循环重试、多路径并行、动态流程调整,都搞不定。
- 扩展性差:一旦场景脱离简单的单轮问答、固定流程任务,传统链式架构就力不从心,代码的扩展性和可控性大幅下降,难以支撑生产级应用。
LangGraph的定位:进阶与复杂编排
LangGraph是LangChain的进阶编排框架与运行时,完美兼容LangChain的所有组件,是对LangChain能力的底层升级。
它的核心定位是复杂、有状态、可循环的AI智能体编排,专门解决LangChain线性流程搞不定的复杂任务场景,聚焦生产级智能体、多轮复杂任务、多智能体协作等高端场景。
LangGraph彻底摒弃了LangChain的固定线性链式执行逻辑,采用有向状态图的设计思想。简单来说,就是把AI任务的每一个执行单元定义为“节点”,把任务流转规则定义为“边”,通过节点和边的自由组合,实现任意复杂的任务流程。
相比LangChain,LangGraph最大的突破是引入了全局状态管理和动态流程控制。在LangGraph中,所有节点共享统一的全局状态,节点可以读取状态数据、处理逻辑、更新状态,同时支持根据状态结果动态判断下一步执行路径,轻松实现分支、循环、重试、并行、回滚等复杂逻辑。
两者并非替代关系,而是互补适配的技术组合,场景划分清晰:
- LangChain适配场景:快速开发简单、固定流程的Demo与轻量化应用,主打快速落地、低门槛迭代。
- LangGraph适配场景:开发生产级、高可控、复杂逻辑的AI智能体、多轮任务系统、多智能体协作应用,主打复杂流程、自主决策、工程化落地。
简单来说,二者是基础与进阶、简单与复杂、快速迭代与工程落地的互补关系,可以搭配使用来搭建完整的大模型应用架构。
LangChain的核心架构
五大核心基础组件
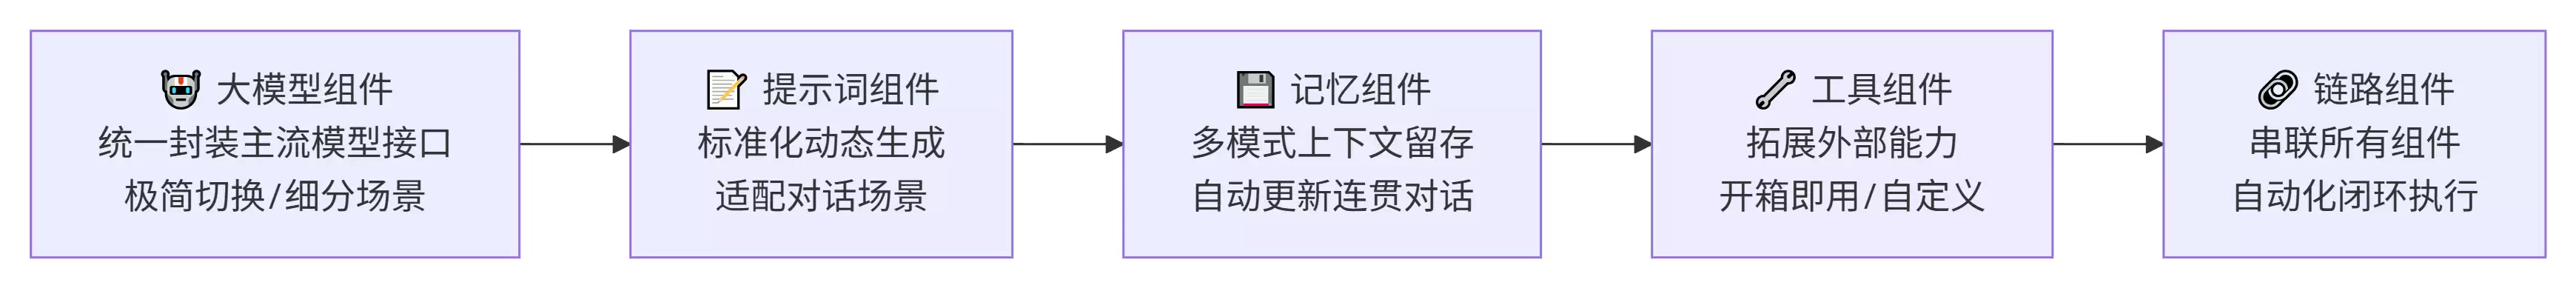
想要用好LangChain,首先要吃透它的核心组件。所有LangChain应用,都是基于以下五大基础组件组合搭建而成,每个组件各司其职、标准化解耦,极大降低了开发难度。
1. 大模型组件(LLM/ChatModel)
这是AI应用的核心算力支撑,具备极强的通用性与兼容性。它做了三件事:一是模型全覆盖,统一封装了市面上几乎所有主流大模型接口;二是极简切换,简单修改模型参数就能完成模型替换;三是场景细分,区分了普通文本生成LLM和对话模型ChatModel,分别适配单轮生成和多轮对话。
2. 提示词组件(Prompt)
专门用于标准化提示词管理。它解决了传统手动编写提示词冗余、不可复用、难以维护的问题。支持动态生成,可预设固定业务模板,通过传入变量快速生成定制化提示词。同时适配对话场景,能自动拼接对话历史、设定AI角色、限定任务执行规则。
3. 记忆组件(Memory)
大模型本身无状态,无法自主记忆对话历史。Memory组件专门解决上下文留存和连续对话问题。它提供多种模式:简单对话缓存、窗口记忆、摘要记忆、向量记忆等,可适配短时日常对话、长时连续对话、海量上下文长文本交互等不同场景。
4. 工具组件(Tools)
核心作用是拓展大模型的能力边界,打破模型固有知识与能力的局限。支持联网搜索、代码执行、文件读取、数据库查询、计算器运算等各类外部操作。LangChain内置了大量高频常用工具,也支持开发者将任意专属业务逻辑封装为自定义工具。
5. 链路组件(Chain)
这是LangChain的核心执行载体,承担组件串联、任务执行的核心作用。它可以把模型、提示词、记忆、工具等所有零散组件串联起来,形成完整闭环的任务执行链路。依托LCEL语法,可以极简编写链路逻辑,实现“提示词输入-模型推理-结果解析输出”的全自动化流程。
标准化的执行流程
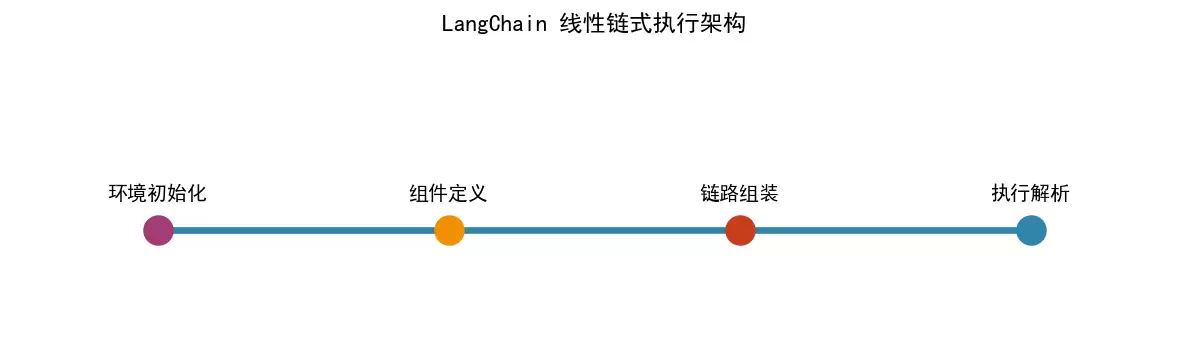
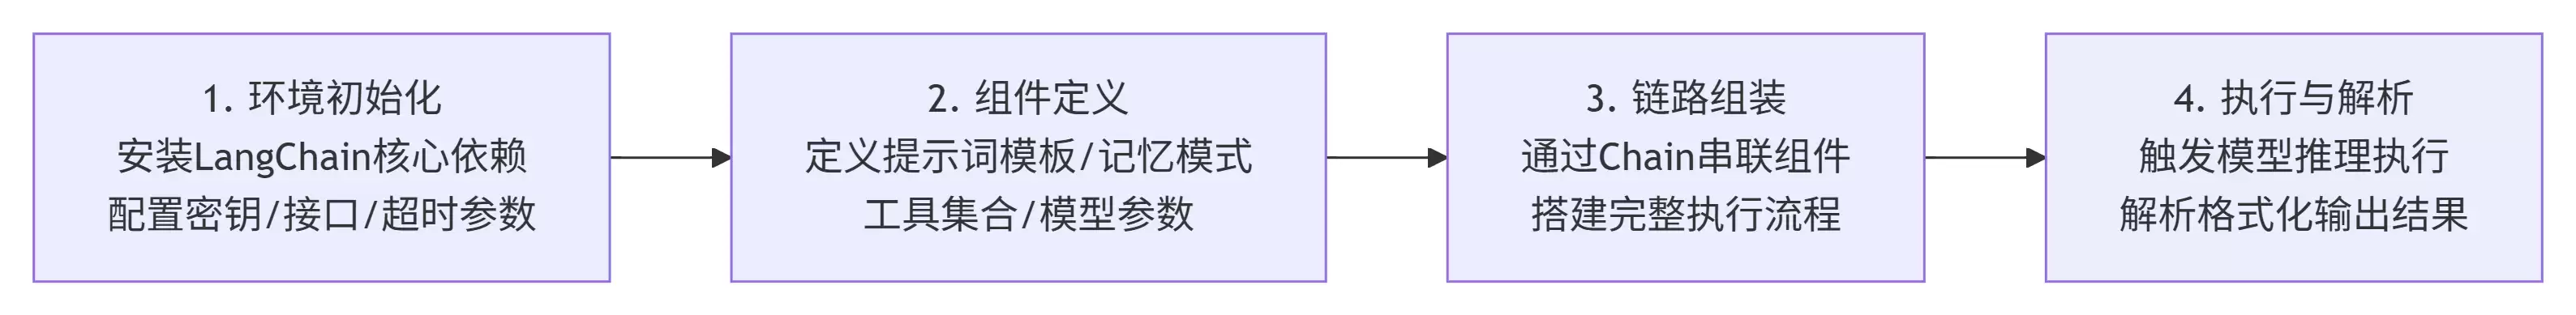
基于LangChain开发轻量化应用,有标准化的开发流程,整体分为四大步骤:
- 环境初始化:安装核心依赖库,配置大模型密钥、接口地址、超时参数等基础配置。
- 组件定义:根据业务需求,按需定义提示词模板、对话记忆模式、工具集合、模型参数等核心组件。
- 链路组装:通过Chain组件,将所有定义好的基础组件按照线性业务顺序串联,搭建完整的任务执行流程。
- 执行与解析:调用组装完成的链路,触发模型推理与任务执行,对输出结果进行解析、格式化处理。
优缺点分析
LangChain线性开发模式的核心优势非常突出,适合新手入门和轻量化项目落地:
- 低门槛、高效率:所有核心组件均已封装,几行代码就能实现复杂功能,快速完成Demo搭建与原型验证。
- 标准化解耦设计:各组件独立可替换,修改提示词、切换模型、新增工具,都不会影响整体链路逻辑。
- 生态成熟稳定:文档详实,社区案例丰富,问题排查成本低。
但局限性也很明显,在生产级复杂项目中会被无限放大:
- 流程死板:固定线性执行,不支持分支判断,无法根据实时结果动态调整流程。
- 无统一全局状态:多步骤任务中,上下文和中间数据依靠组件单独传递,数据零散混乱,容易出现上下文断层。
- 复杂能力缺失:原生不支持循环重试、异常回滚、多任务并行等核心能力,仅适合简单轻量化开发。
链式应用示例解析
以下示例演示了LangChain LCEL链式开发的核心模式:通过|操作符将提示词模板、大模型推理、输出解析器串联为固定处理链路。
import os
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

# 接入腾讯混元大模型(TokenHub平台)
api_key = os.environ.get('TENCENT_API_KEY')
model_name = "hy3-preview"

print("=" * 50)
print("LangChain 链式开发 — 组件初始化")
print("=" * 50)

# 1. 初始化基础组件
print("n[组件1] 初始化大模型...")
llm = ChatOpenAI(
    model=model_name,
    api_key=api_key,
    base_url="https://tokenhub.tencentmaas.com/v1",
)
print(f" 模型: {model_name} | 端点: tokenhub.tencentmaas.com")

print("n[组件2] 构建提示词模板...")
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是AI开发科普助手,回答简洁通俗,适合新手学习。"),
    ("human", "请简单讲解:{question}")
])
print(f" 系统角色: AI开发科普助手")
print(f" 用户模板: 请简单讲解:{{question}}")

print("n[组件3] 初始化输出解析器...")
parser = StrOutputParser()
print(f" 解析器: StrOutputParser (纯文本输出)")

# 2. 链式组装(LCEL线性链路)
print("n" + "=" * 50)
print("链式组装 (LCEL)")
print("=" * 50)
chain = prompt | llm | parser
print("组装顺序: 提示词模板 → 大模型推理 → 结果解析")
print("操作符: prompt | llm | parser")

# 3. 执行固定流程任务
if __name__ == "__main__":
    user_question = "LangChain的链式架构特点是什么"
    print("n" + "=" * 50)
    print("链式调用执行")
    print("=" * 50)
    print(f"n[步骤1] 填充提示词模板")
    print(f"输入问题: {user_question}")
    prompt_value = prompt.invoke({"question": user_question})
    print(f"实际发送给模型的提示词:")
    for msg in prompt_value.messages:
        print(f"[{msg.type}] {msg.content[:80]}...")

    print(f"n[步骤2] 大模型推理中 (hy3-preview)...")
    llm_output = llm.invoke(prompt_value)
    print(f"模型原始输出: {llm_output.content[:80]}...")

    print(f"n[步骤3] 解析器提取纯文本...")
    res = parser.invoke(llm_output)
    print(f"解析结果长度: {len(res)} 字")

    print(f"n{'='*50}")
    print(f"最终输出")
    print(f"{'='*50}")
    print(f"n{res}")
输出结果会展示完整的链式调用过程。
LangGraph的核心架构
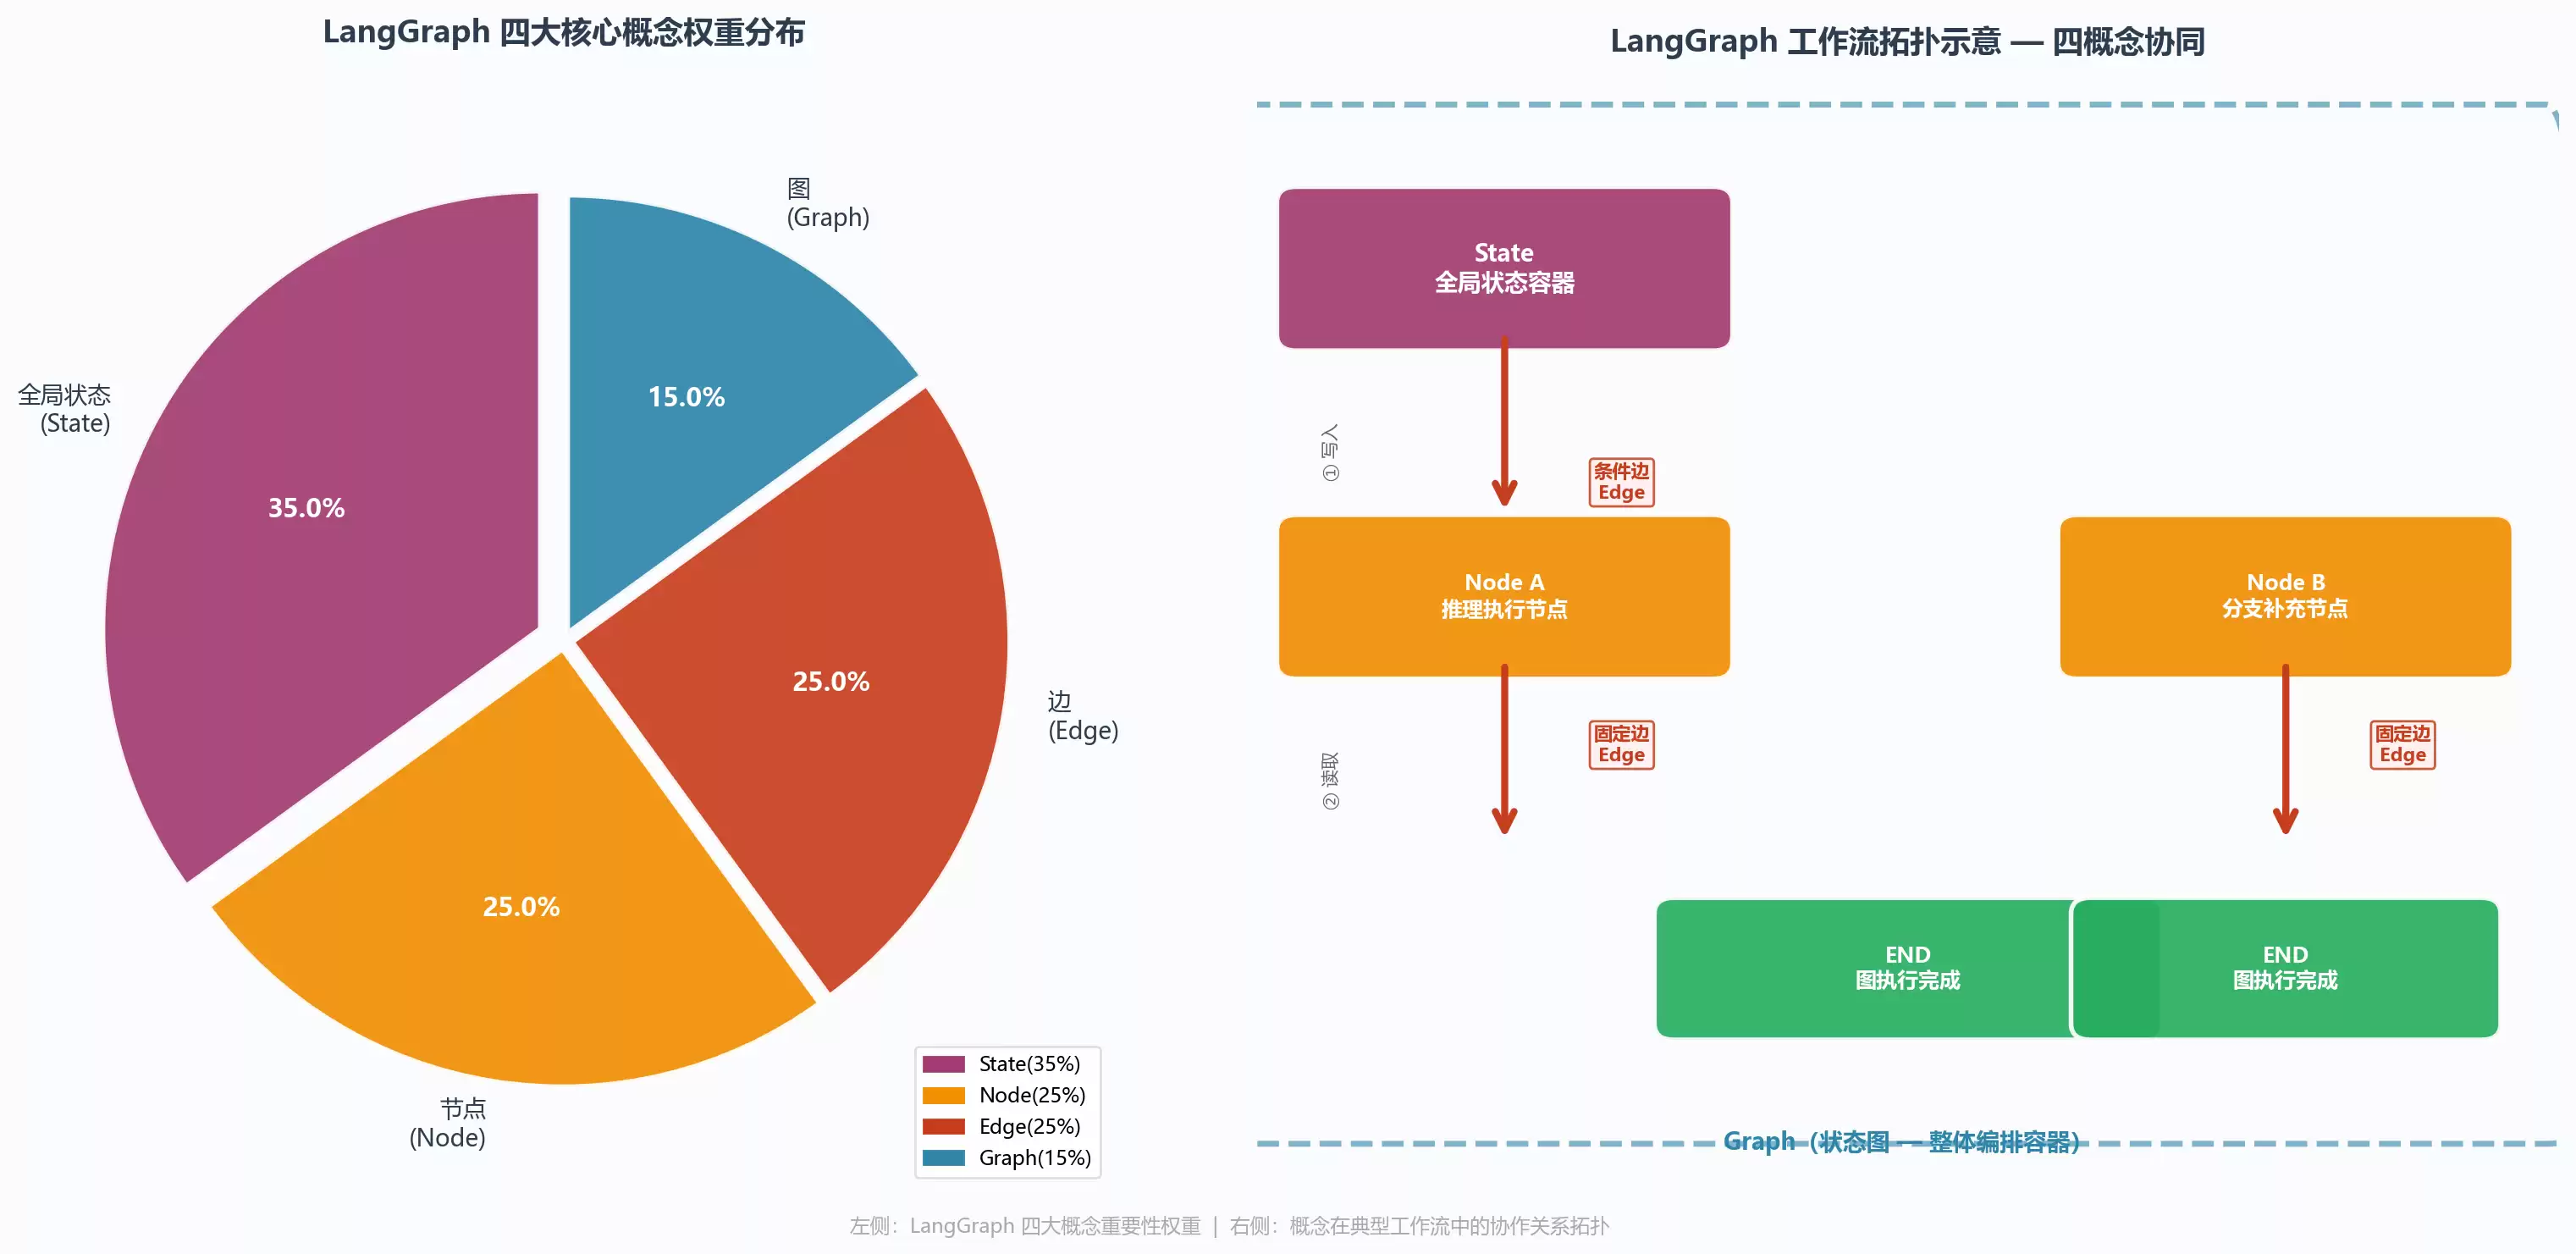
四大核心基础概念
LangGraph完全兼容LangChain所有组件,仅在执行架构上做了升级。掌握LangGraph架构设计之前,必须了解四大核心基础概念。
1. 状态(State)
State是LangGraph的核心灵魂,是整个任务流程的全局共享数据快照,彻底解决了LangChain数据零散的痛点。它将任务数据、对话历史、中间结果、异常信息等所有流程数据统一收纳管理。支持字典、TypedDict、Pydantic模型等多种定义格式,所有节点均可自由读取、修改、更新全局状态。
2. 节点(Node)
节点是LangGraph的最小执行单元,是所有业务逻辑的承载载体。本质上是可执行的Python函数或LangChain可运行组件,可独立完成单一任务逻辑。可以自定义为大模型推理节点、工具调用节点、结果审核节点、数据解析节点等各类业务单元。
3. 边(Edge)
边是节点之间的任务流转规则,决定整个流程的执行路径。分为两类:普通边是固定流转规则,执行完A节点后直接进入B节点,对应LangChain的线性逻辑;条件边是动态流转规则,根据当前全局状态的实时结果,通过自定义判断逻辑,动态筛选下一步执行节点,实现分支、分流、循环重试、异常回滚等复杂逻辑。
4. 图(Graph)
图是LangGraph最终的任务编排载体,是整合所有逻辑的核心容器。通过整合全部节点和流转边,构建出完整的有向状态图,承载整套业务流程。开发者可以自由实例化StateGraph、新增节点、配置流转规则、设置流程入口与出口。编译完成后可持续迭代执行,完美适配多步骤、长周期的智能体任务。
核心优势
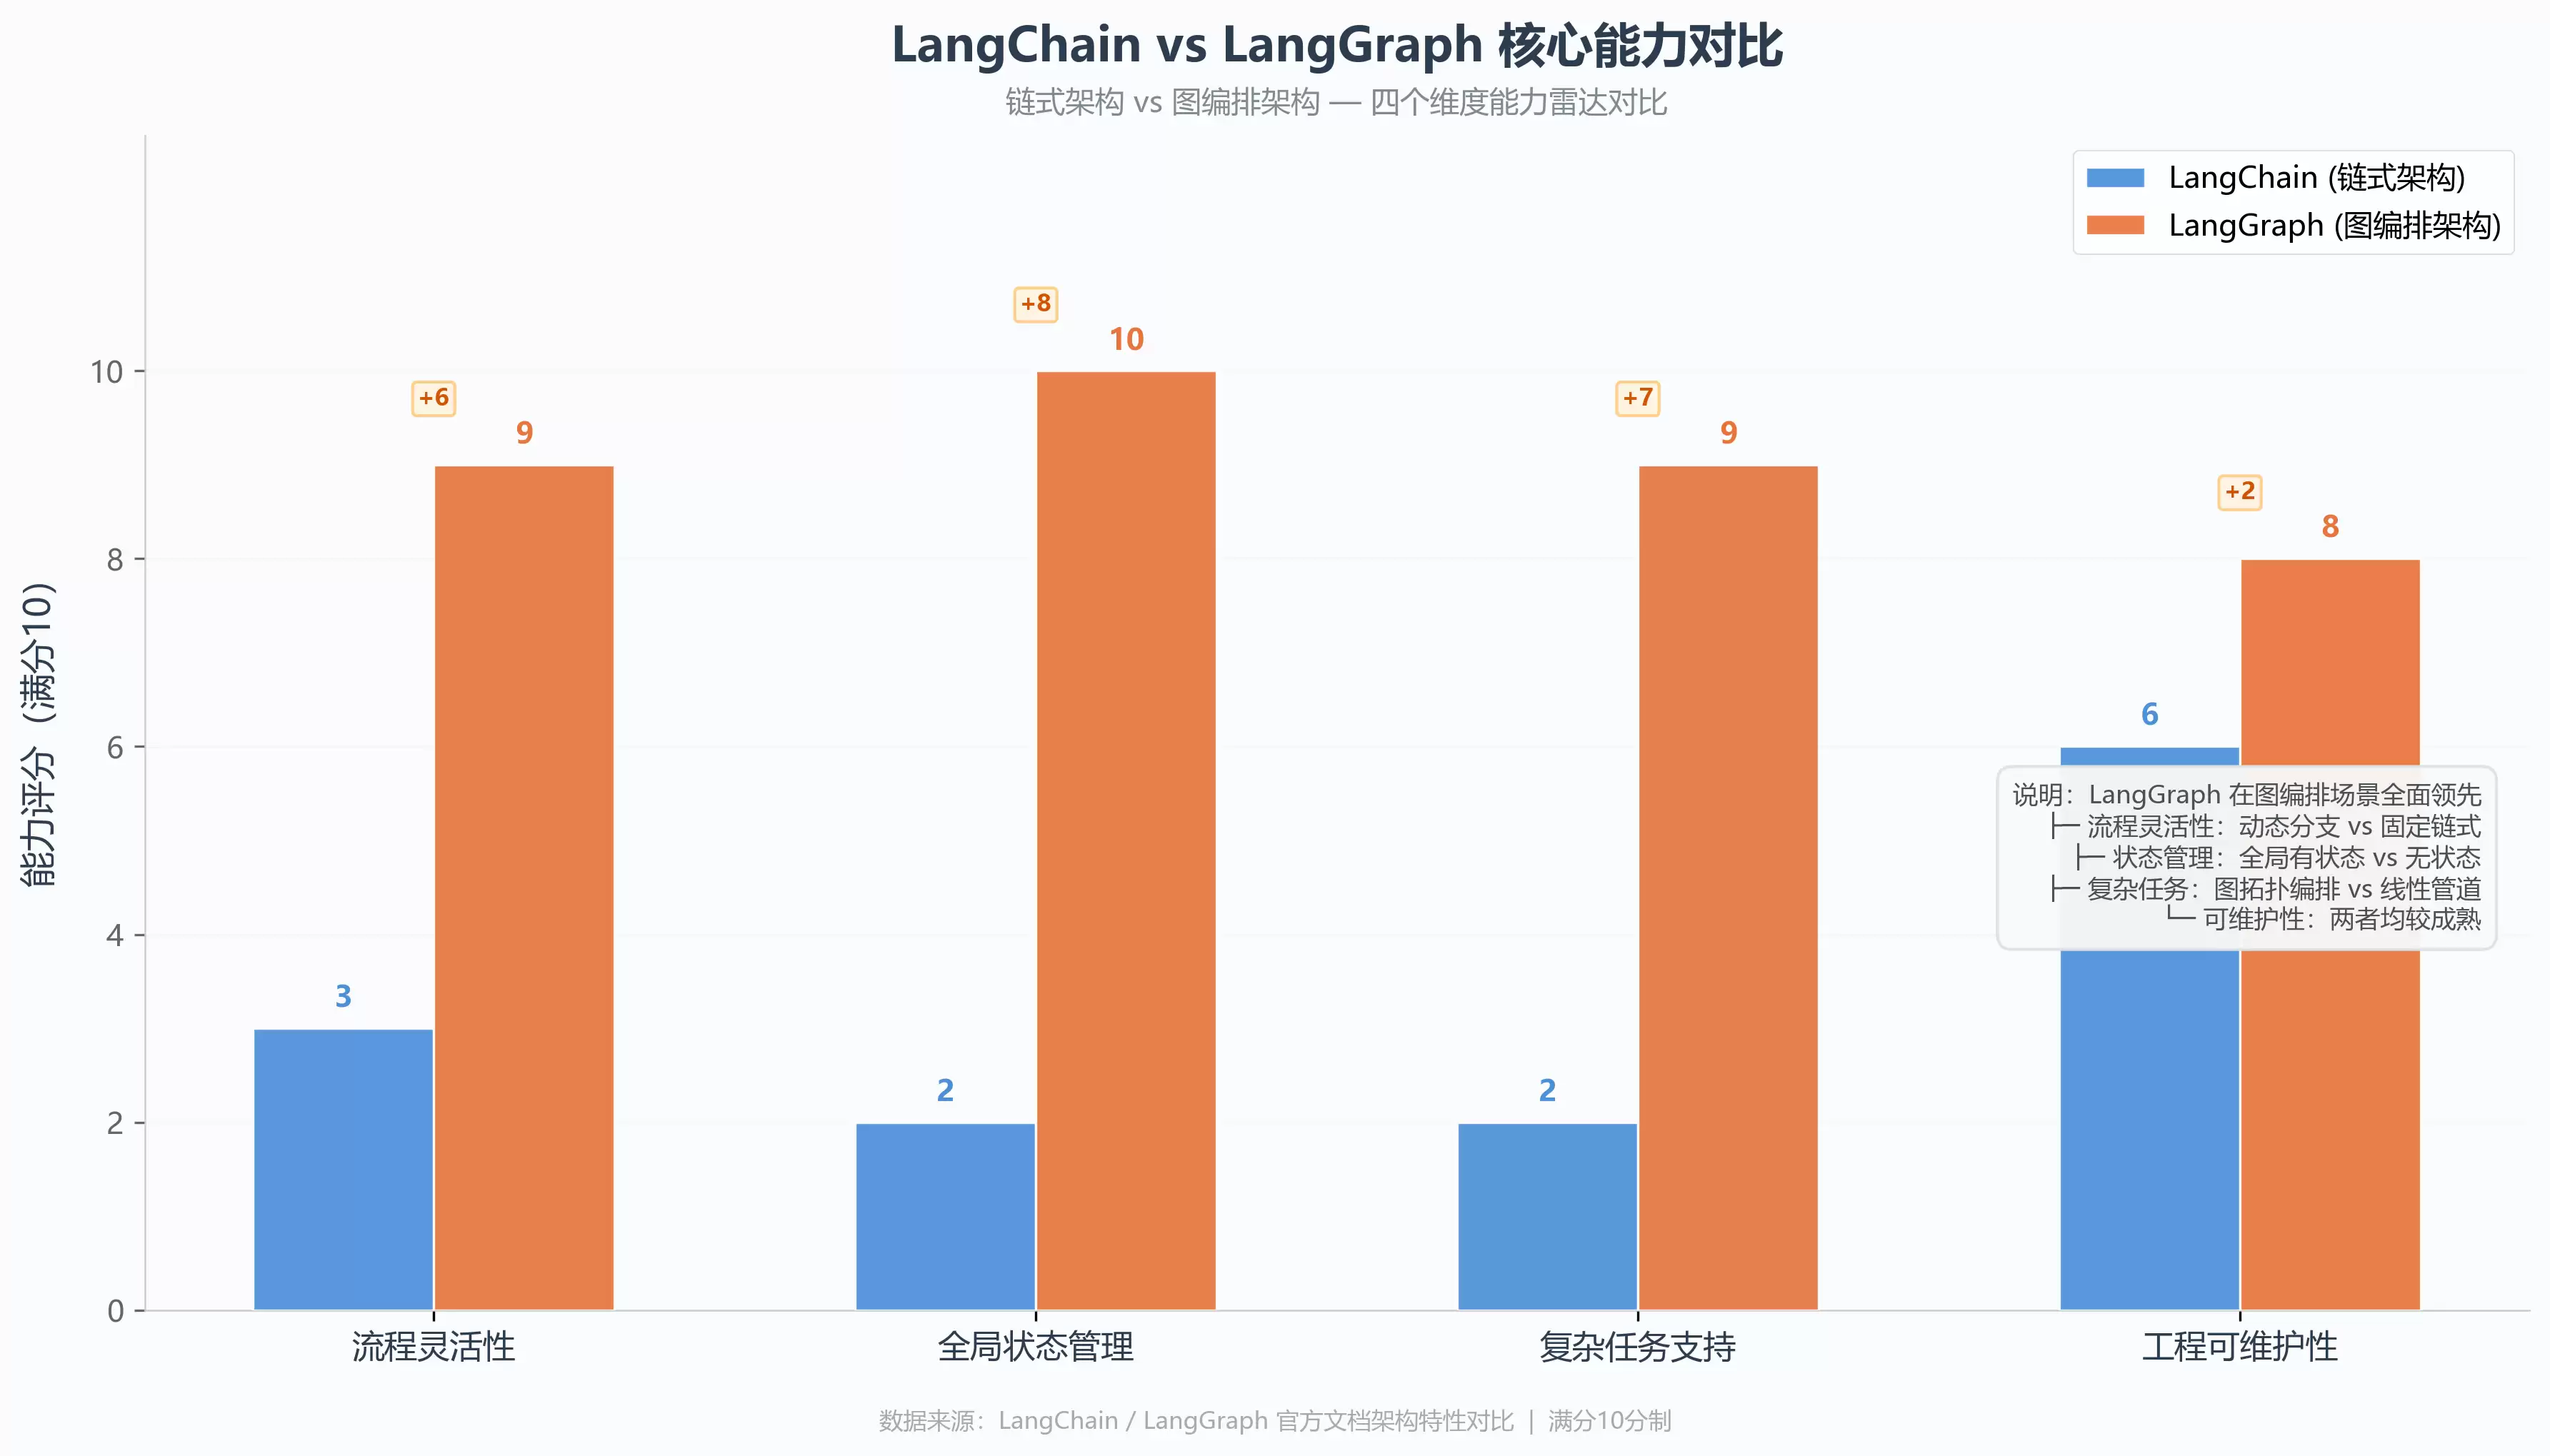
相比LangChain的线性架构,LangGraph的图式架构完美解决了传统链式开发的所有痛点,四大核心优势让它成为生产级智能体开发的标准。
1. 灵活的动态流程编排
彻底打破LangChain线性执行的固化限制,依托条件边可实现任意复杂的任务逻辑。支持工具调用失败自动重试、推理结果不达标回溯重生成、不同用户问题智能分流、多任务并行执行等能力,完全贴合真实、复杂、动态的业务场景。
2. 统一全局状态管理
全流程共享唯一全局状态,所有中间数据、上下文信息、执行日志集中存储、统一管控。既解决了传统开发数据零散、上下文混乱、数据丢失的问题,又支持状态快照保存、手动回滚、全流程追溯,极大降低了问题排查难度。
3. 天然支持循环与迭代
AI智能体的核心逻辑就是“思考-行动-观察-再思考”的循环迭代,LangGraph原生内置循环执行能力,完美适配智能体自主决策、自主纠错的核心场景。例如智能体识别当前信息不足时,可自动调用工具补充数据,再重新推理校验,直至任务达标完成。
4. 高可控的生产级特性
LangGraph专为企业生产环境设计,自带各类工程化高阶能力:任务断点续跑、异常捕获与自动重试、执行日志可视化、多智能体协同分工、流程权限管控等。同时官方版本稳定,完全适配长期迭代、高稳定性要求的商业级应用。
图编排开发示例解析
以下示例演示了LangGraph图编排的核心模式:通过全局状态管理、独立推理与补充节点、条件边动态分流,实现有状态的Agent工作流。
import os
from typing import TypedDict
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langgraph.graph import StateGraph, START, END

# 接入腾讯混元大模型(TokenHub平台)
api_key = os.environ.get('TENCENT_API_KEY')
model_name = "hy3-preview"

# 1. 定义全局状态
class AgentState(TypedDict):
    query: str          # 用户输入
    answer: str         # 模型回答
    need_more: bool     # 动态判断标记

print("=" * 50)
print("LangGraph 图编排 — 组件初始化")
print("=" * 50)

# 2. 复用LangChain基础组件
print("n[模型] 初始化大模型...")
llm = ChatOpenAI(
    model=model_name,
    api_key=api_key,
    base_url="https://tokenhub.tencentmaas.com/v1",
)
print(f" {model_name} | tokenhub.tencentmaas.com")

print("n[状态] 定义全局状态 Schema...")
print(f" AgentState: query(str) + answer(str) + need_more(bool)")

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是AI开发科普助手,回答简洁通俗。"),
    ("human", "{query}")
])

# 3. 定义独立节点
def inference_node(state: AgentState):
    """模型推理节点"""
    print(f"n┌─ 【节点: inference】推理节点 ─┐")
    print(f"│输入: {state['query'][:50]}...")
    res = prompt | llm
    answer = res.invoke({"query": state["query"]}).content
    # 动态设置状态:回答过短则需要补充内容
    need_more = len(answer) < 80
    print(f"│输出: {answer[:60]}...")
    print(f"│回答长度: {len(answer)} 字 (阈值80字)")
    print(f"│状态更新: need_more = {need_more}")
    print(f"└─ 【inference 完成】──┘")
    return {"answer": answer, "need_more": need_more}

def supplement_node(state: AgentState):
    """内容补充节点(分支逻辑)"""
    print(f"n┌─ 【节点: supplement】补充节点 ─┐")
    print(f"│原回答过短({len(state['answer'])}字),触发补充流程")
    supplement_prompt = ChatPromptTemplate.from_messages([
        ("system", "请补充细化回答,讲得更详细易懂。"),
        ("human", "原问题:{query} 原回答:{answer}")
    ])
    res = supplement_prompt | llm
    new_answer = res.invoke({"query": state["query"], "answer": state["answer"]}).content
    print(f"│补充后长度: {len(new_answer)} 字")
    print(f"└─ 【supplement 完成】──┘")
    return {"answer": new_answer}

# 4. 定义分支流转规则
def judge_branch(state: AgentState):
    """动态分支判断:是否需要补充内容"""
    if state["need_more"]:
        print(f"n→ 条件判断: need_more=True → 路由到 [supplement]")
        return "supplement"
    print(f"n→ 条件判断: need_more=False → 路由到 [END]")
    return "end"

# 5. 构建状态图工作流
print("n" + "=" * 50)
print("构建状态图工作流")
print("=" * 50)
graph = StateGraph(AgentState)

# 添加节点
graph.add_node("inference", inference_node)
graph.add_node("supplement", supplement_node)
print("[节点] inference, supplement 已注册")

# 固定边:起始=>推理
graph.add_edge(START, "inference")
print("[边] START → inference")

# 条件边:动态分流,实现分支逻辑
graph.add_conditional_edges(
    "inference",
    judge_branch,
    {"supplement": "supplement", "end": END}
)
print("[条件边] inference → judge_branch → supplement / END")

# 补充节点执行完成后结束
graph.add_edge("supplement", END)
print("[边] supplement → END")

# 编译运行
if __name__ == "__main__":
    print("n" + "=" * 50)
    print("编译并执行图工作流")
    print("=" * 50)
    run_graph = graph.compile()
    print(" 图编译完成")

    print(f"n输入问题: LangGraph和LangChain有什么区别")
    print(f"{'─' * 40}")
    result = run_graph.invoke({"query": "LangGraph和LangChain有什么区别"})
    print(f"{'─' * 40}")

    print(f"n{'='*50}")
    print(f"最终输出")
    print(f"{'='*50}")
    print(f"n{result['answer']}")
输出结果会展示完整的图编排执行过程。
框架差异与选型
架构深度对比
| 维度 | LangChain | LangGraph |
|---|---|---|
| 执行模式 | 静态线性链式,流程在开发阶段固定 | 动态图式,运行时根据状态动态决策 |
| 状态管理 | 无统一状态,数据零散传递 | 全局统一状态,集中管控,支持追溯 |
| 流程能力 | 仅支持简单线性流程,无分支、循环、并行 | 支持分支、循环、并行、回滚、重试 |
| 开发维护 | 上手门槛低,但复杂场景下代码冗余 | 有学习成本,但长期维护成本更低 |
场景选型方案
优先选用LangChain的场景:
- 轻量化演示Demo、快速原型验证
- 固定流程的简单应用(单轮文档问答、固定模板文本生成)
- 低复杂度工具调用任务
- 入门学习、小型测试项目
优先选用LangGraph的场景:
- 各类AI智能体开发(任务拆解、自主工具调用、迭代纠错)
- 复杂业务流程(分支判断、动态分流、循环重试、异常回滚)
- 长周期任务开发(长文本处理、多步骤数据分析)
- 多智能体协作系统
- 企业级生产项目(对稳定性、可维护性有高标准要求)
应用架构设计
分层架构设计
实际项目开发中,不会零散堆砌组件和节点,而是采用标准化分层架构。基于LangChain+LangGraph的组合架构,行业通用的标准化分层方案分为四层:
1. 基础能力层
基于LangChain搭建底层通用能力底座,统一封装模型调用、提示词模板、对话记忆、工具集合、向量检索、文档解析等高频通用能力。所有基础组件统一管理、全局复用。
2. 流程编排层
基于LangGraph实现核心业务流程编排,是架构的核心调度层。自定义全局状态结构、按功能拆分独立业务节点、配置节点流转边与分支判断规则,实现逻辑彻底解耦。
3. 业务逻辑层
承接编排层的通用能力,聚焦专属业务场景的定制化逻辑开发,包括任务优先级判断、模型输出结果校验、全局异常捕获与处理、数据格式化清洗、业务权限校验等。
4. 接口服务层
架构最外层的落地载体,负责应用对外服务与工程化加固。将搭建完成的图式AI应用封装为标准化API接口,配套日志记录、参数校验、限流熔断、超时处理、异常告警等工程化能力。
开发规范参考
1. 节点单一职责原则
每个LangGraph节点仅实现一个核心功能,杜绝单节点逻辑臃肿。拆分后的节点可独立调试、修改、替换,最大限度降低代码耦合度。
2. 精细化状态设计
结合业务场景自定义状态字段,精准区分输入参数、输出结果、中间过程数据、执行日志、异常信息等,避免状态冗余缺失。
3. 完善异常重试机制
针对工具调用失败、模型推理超时、参数异常、网络波动等高频问题,配置节点重试、流程回滚、友好异常提示机制。
4. 可视化流程调试
充分利用LangGraph自带的流程可视化能力,实时查看节点流转路径、全局状态变化、执行耗时,快速排查流程卡顿、逻辑错误等问题。
5. 基础组件统一封装
所有LangChain基础组件统一初始化配置、统一管理,避免多处重复定义代码,方便后续统一升级模型、替换工具、优化提示词。
LangChain+LangGraph组合应用示例
以下示例演示了LangChain+LangGraph的组合开发模式:LangChain负责提示词模板与模型推理的链式组装,LangGraph负责全局状态管理与图节点编排,两者协作实现有状态的智能问答工作流。
import os
from typing import TypedDict, Annotated
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langgraph.graph import StateGraph, START, END

# 接入腾讯混元大模型(TokenHub平台)
api_key = os.environ.get('TENCENT_API_KEY')
model_name = "hy3-preview"

# 1. 定义全局状态
class GraphState(TypedDict):
    user_query: str   # 用户问题
    answer: str       # 模型输出结果

print("=" * 50)
print("LangChain + LangGraph 组合开发 — 初始化")
print("=" * 50)

# 2. 初始化LangChain基础组件
print("n[LangChain] 初始化基础组件...")
llm = ChatOpenAI(
    model=model_name,
    api_key=api_key,
    base_url="https://tokenhub.tencentmaas.com/v1",
)
print(f" 大模型: {model_name}")

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是专业的AI开发助手,回答简洁通俗、适合新手理解。"),
    ("human", "{user_query}")
])
print(f" 提示词模板: system角色 + human输入")

print("n[LangGraph] 状态Schema...")
print(f" GraphState: user_query(str) + answer(str)")

# 3. 定义图节点
def llm_infer_node(state: GraphState):
    """大模型推理节点(LangChain链式调用 + LangGraph状态管理)"""
    print(f"n┌─ 【节点: llm_infer】推理执行 ─┐")
    print(f"│LangChain 提示词填充: {state['user_query'][:40]}...")
    # 组装提示词 + 模型推理
    chain = prompt | llm
    res = chain.invoke({"user_query": state["user_query"]})
    print(f"│模型返回: {res.content[:60]}...")
    print(f"│更新全局状态: answer字段写入")
    print(f"└─ 【llm_infer 完成】──┘")
    return {"answer": res.content}

# 4. 构建LangGraph工作流
print("n" + "=" * 50)
print("构建图工作流")
print("=" * 50)
graph_builder = StateGraph(GraphState)

# 添加执行节点
graph_builder.add_node("llm_infer", llm_infer_node)
print("[节点] llm_infer 已注册")

# 设置执行流程:起始 → 推理节点 → 结束
graph_builder.add_edge(START, "llm_infer")
graph_builder.add_edge("llm_infer", END)
print("[边] START → llm_infer → END")
print("[架构] LangChain(链式推理) + LangGraph(状态图编排)")

# 编译图并执行
print("n" + "=" * 50)
print("编译并执行")
print("=" * 50)
graph = graph_builder.compile()
print(" 图编译完成n")

# 测试运行
if __name__ == "__main__":
    user_q = "简单说说LangChain和LangGraph的区别"
    print(f"[输入] {user_q}")
    print(f"{'─' * 40}")
    result = graph.invoke({"user_query": user_q})
    print(f"{'─' * 40}")

    print(f"n{'='*50}")
    print(f"最终输出")
    print(f"{'='*50}")
    print(f"n{result['answer']}")
重点说明:
- 复用LangChain能力:模型调用、提示词模板全部使用LangChain原生组件,体现两套框架的兼容性与组合性。
- 落地LangGraph核心架构:自定义全局状态、拆分独立节点、配置流程边,完整复刻图式编排核心逻辑。
输出结果会展示完整的组合开发执行过程。
总结
总的来说,LangChain是大模型应用的基础组件框架,主打线性链式快速开发、轻量化Demo落地、新手入门;LangGraph是进阶图编排框架,主打动态流程、状态管理、复杂智能体开发、生产级落地。
二者并非对立替代关系,而是互补的完整技术组合体系,也是目前行业主流开发方案。底层基础能力依托LangChain实现,复杂业务流程编排依托LangGraph实现。
随着了解的深入,我们会慢慢聚焦本质——跳出API堆砌,大模型应用开发的核心,不是堆砌框架API,而是理解任务编排、状态管理、逻辑解耦的工程化思想。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- 大模型应用开发工具链技术选型与实施方案
- 时间:2026-08-17
-

- 大模型应用开发基础:Function Calling实现程序调用能力
- 时间:2026-08-16
-
- LangChain实战:构建企业级ReAct数据分析Agent
- 时间:2026-08-05
-
- 最新版Dify功能介绍及阿里云百炼Coding Plan与Token Plan接入教程
- 时间:2026-07-29
-
- 五部门联合部署 民航大模型应用迈入数智新纪元
- 时间:2026-07-28
-

- 提示词工程版本化,提示词管理成大模型新基建
- 时间:2026-07-25
-

- AI安全网关升温 提示词防护权限校验内容审计成大模型标配
- 时间:2026-07-25
-
- AI场景大模型熔断机制设计与应用实践
- 时间:2026-07-21
精选合集
更多大家都在玩
大家都在看
更多-

- 八大山人是谁
- 时间:2026-09-21
-
- 精浓度越高,消毒效果越好吗 蚂蚁庄园今日答案9.22
- 时间:2026-09-21
-
- 蚂蚁庄园今天答题答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园答题今日答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园小课堂2026年9月22日最新题目答案
- 时间:2026-09-21
-
- 小鸡答题今天的答案是什么2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园每日答题答案2026年9月22日
- 时间:2026-09-21
-
- 以下哪一项是闽南地区的特色小吃 蚂蚁庄园今日答案9月22日
- 时间:2026-09-21