DeepSeek V4模型参数查看方法详解
时间:2026-07-25 | 作者:夜鞌不睡 | 阅读:0想确认本地下载的 DeepSeek V4 模型实际用的是哪种量化精度、上下文长度或温度默认值?光看文件名或网页描述可不够——不同来源的同名模型,配置可能差得远。等运行时才发现 token 被截断或者显存爆了,那就晚了。
下面介绍三种靠谱的验证方法。
如果你已经下载了模型,但还没跑过任何推理,先别急着直接上。很多问题其实在命令行里就能看明白,根本不用等报错。
用 Ollama 命令行查已下载模型参数
这一步操作起来很简单,直接在终端里输命令就行。前提是模型已经成功下载并注册进了 Ollama 本地库。
先执行 ollama list,找到你要查的模型名,比如 deepseek-v4-flash。然后运行 ollama show deepseek-v4-flash,输出内容里会明确列出 【quantization: Q5_K_M】、【num_ctx: 8192】 这些关键参数。
注意:如果提示“model not found”,说明模型还没被 Ollama 识别,需要先执行 ollama create 或 ollama pull 注册——光把 GGUF 文件丢进目录是不会自动生效的。
查 Hugging Face 模型原始配置文件
要拿到最权威的参数,直接去 Hugging Face 模型页面看 config.json 和 generation_config.json,那是官方第一手资料,不受任何第三方打包的干扰。
打开模型页面(比如 https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-Base),点击“Files and versions”标签页。找到并下载 config.json 文件,用文本编辑器打开。
搜索 "torch_dtype" 字段,这里写的是原始训练精度,比如 "bfloat16"。再搜 "max_position_embeddings",这个值就是模型原生支持的最大上下文长度——V4 系列普遍标称 256k,但部分量化版本会缩水到 128k 甚至更低。别信宣传页写的“支持256K”,得看这里。
解析 GGUF 文件头获取真实量化信息
GGUF 文件的好处是,所有元数据都打包在文件头部,不需要依赖外部 JSON,特别适合验证第三方重打包的模型有没有被改过参数。
- 方法一:用
gguf-dump工具(需单独安装)查看完整头信息。执行gguf-dump deepseek-v4.Q5_K_M.gguf | grep -i "quant",直接定位量化方式。 - 方法二:用十六进制编辑器(如 HxD 或 xxd)打开 GGUF 文件,跳转到偏移量 0x10 处。前 4 字节是 magic number,紧接着是 version、n_tensors、n_kv,再往后几百字节内能找到
quantization_version和general.quantization_type字段。
注意:Q4_K_M、Q5_K_S、Q6_K 等后缀中的字母组合代表分组量化策略,不是简单等价于 INT4 或 INT5——【Q5_K_M ≠ INT5】,它对权重矩阵做了块级精度分配,某些列保留更高位宽。盲目换算会导致推理异常,务必以实际解析结果为准。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- GPT-5.5与DeepSeek V4 Pro大模型网络安全攻防实测报告
- 时间:2026-08-21
-
- DeepSeek V4 Pro正式版上线国家超算互联网一站式部署开发
- 时间:2026-08-18
-
- DeepSeek V4 Pro正式版发布:性能比肩顶尖Fable大模型
- 时间:2026-08-18
-
- DeepSeek V4 Pro正式版上线:Agent与编程能力全面升级
- 时间:2026-08-17
-
- DeepSeek V4 Pro API正式发布支持100万Token上下文与384K输出
- 时间:2026-08-15
-
- DeepSeek V4 Pro 正式版API更新上线 多项测试性能接近Fable 5
- 时间:2026-08-13
-

- OpenAI降价80% GPT-5.6 Luna性价比超越DeepSeek V4 Pro
- 时间:2026-08-13
-
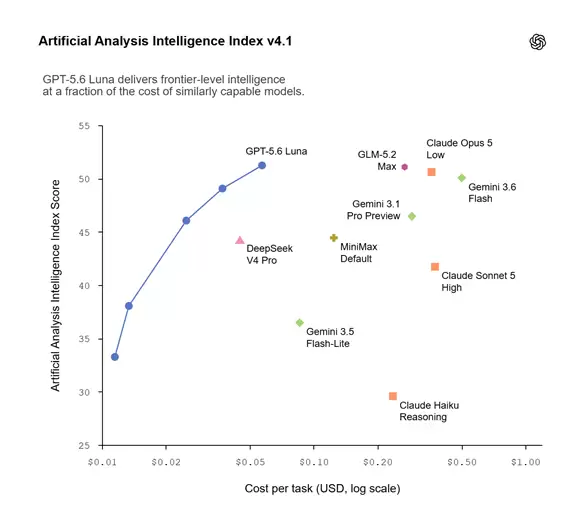
- OpenAI下调GPT-5.6 Luna价格80% 正面竞争DeepSeek V4 Pro
- 时间:2026-08-13
精选合集
更多大家都在玩
大家都在看
更多-

- 八大山人是谁
- 时间:2026-09-21
-
- 精浓度越高,消毒效果越好吗 蚂蚁庄园今日答案9.22
- 时间:2026-09-21
-
- 蚂蚁庄园今天答题答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园答题今日答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园小课堂2026年9月22日最新题目答案
- 时间:2026-09-21
-
- 小鸡答题今天的答案是什么2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园每日答题答案2026年9月22日
- 时间:2026-09-21
-
- 以下哪一项是闽南地区的特色小吃 蚂蚁庄园今日答案9月22日
- 时间:2026-09-21