复旦教授与英特尔前首席科学家,眸深智能端侧具身大脑融资近亿元
时间:2026-07-26 | 作者:实验室老王 | 阅读:0一则消息在行业里引起关注:2025年1月成立的「眸深智能」,近日完成了近亿元Pre-A轮追加融资。本轮投资方包括中国头部物业服务公司、香港财团、多家上市公司联合打造的产业投资平台瑾悦投资、创合汇资本,以及老股东徐汇资本。
这距离它2026年5月拿下的3亿元Pre-A轮融资,仅仅过去了两个月。更值得留意的是,该公司的Pre-A+轮近5亿融资也正在交割中。据公司透露,今年上半年以来,估值增长超过10倍,是业内发展速度最快的具身大脑企业之一。
定位与技术路线
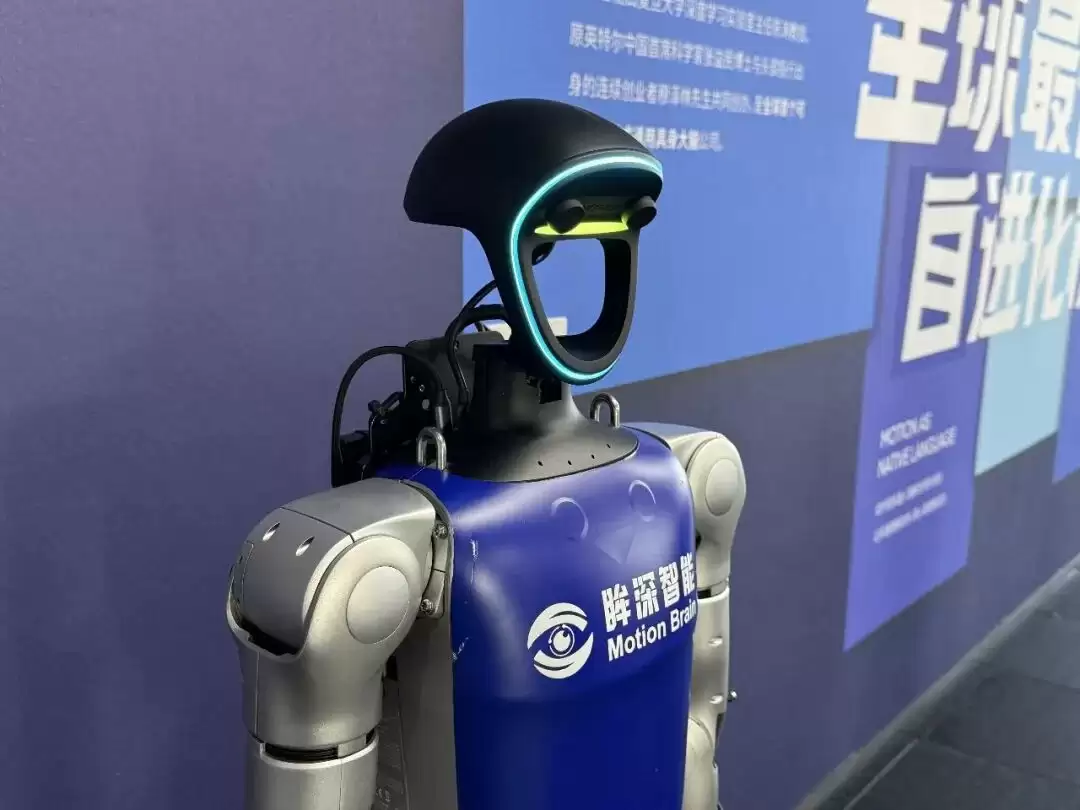
「眸深智能」的定位,是全球最懂动作的自进化具身大脑公司。目标是“给10亿台机器人装原生通用大脑”。公司由复旦大学深度学习实验室主任陈涛教授、原英特尔中国首席科学家张益民博士,与连续创业者穆泽林共同创办。
核心团队拥有海思、英特尔、英伟达三大芯片巨头的背景人士,是国内少数具备算子级适配能力的具身大模型团队。尽管2025年才注册成立,但技术积累从2022年就已经开始。
在技术路线上,「眸深智能」选择了一条与主流VLA(视觉-语言-动作)不同的路径——以动作为核心的“世界动作模型”(World Motion Model)。
核心模型一:MLD(隐空间动作扩散模型)
从2022年起,团队就发布了MLD(隐空间动作扩散模型)。当时行业主流做法是把动作当作离散的信号来处理,结果就是生成的动作僵硬、缺少多样性。
而「眸深智能」在全球范围内首次提出将动作映射到隐空间(Latent Space),并引入扩散模型(Diffusion Model)。MLD相当于让AI学会了“无师自通”地生成动作:不再需要逐帧教机器人如何走路,而是让模型像画家去噪一样,从一团随机噪声中还原出自然、连贯的人体姿态。
核心模型二:MotionGPT(动作Token化)
如果说MLD解决了“怎么生成动作”,那下一步就是如何“指挥动作”。2023年9月,团队创造性发布了MotionGPT。类比汉字的笔画,团队将人体姿态拆解为约3000个“动作基元”。
就像大语言模型(LLM)通过预测下一个token来生成句子一样,MotionGPT通过预测下一个“动作token”来生成复杂行为。这种将连续动作离散化的处理方式,不仅极大提升了模型对长序列任务的理解能力,更重要的是,它让机器人具备了Zero-Shot(零样本)泛化能力——没见过的动作指令,也能通过重组动作词汇来理解并执行。这也是全球首个把动作做成token的具身大模型,发表于NeurIPS 2023。
最新突破:STI-WM与TMB
时间推到2026年,团队已经累计发布了7代模型。基于前面积累,团队又进一步推出了STI-WM(时空一体世界动作模型)具身大模型。STI-WM是完全面向机器人长时序规划、在线闭环控制、真实物理交互打造的原生具身智能框架,实现了空间结构、时间演化、物理一致性、执行鲁棒性四维一体化统一。
根据介绍,STI-WM的核心突破在于,彻底摆脱了传统VLA模型对海量真机数据的重度依赖。采用了“80%互联网视频+10%动捕数据+10%真机数据”的训练配方。
借助MotionGPT建立的动作词典,从海量无标注的视频中学习物理规律,再用少量动捕数据校准生物力学特征,最后仅用10%的真机数据完成闭环对齐。换句话说,这种全新的数据训练范式,将真机数据需求降低了90%,又把动作准确度提升至99%。
同时,团队在今年3月提出的TMB(Task*Task Motion Brain)也让机器人具备了离线自进化能力。当模型部署到端侧后,无需联网回传数据,仅凭本地交互就能持续优化性能,任务执行准确度最高提升25%。这解决了机器人落地后发现bug必须返厂升级的痛点。
一个值得注意的细节是,英伟达DAIR实验室在最新ARDY模型中,便援引了「眸深智能」的MLD与MotionGPT两项原创技术——这是近两年英伟达第三代动作模型对该公司技术路线的第四次引用。
软硬协同:端侧算力成本降低20倍
真正决定这套大脑能否规模化的,除了技术路线之外,还有端侧算力成本。这也是「眸深智能」的一大竞争壁垒。据介绍,从第一代模型起,团队就同步推进两个方向——模型压缩与国产芯片适配。
一方面,通过模型蒸馏、冗余参数压缩等工程化方案,将千亿参数级模型压缩至百亿级别。在具体场景中,参数量降低约75%,端侧推理延迟从约200毫秒降至10毫秒左右。
另一方面,同步适配海思(昇腾310/910)、地平线、燧原(燧原S60)等国产芯片平台,实现低功耗、高实时、超低成本的端侧推理。这套软硬协同的打法,带来的直接结果是,模型端侧推理成本从20万元降至1万元,大脑续航时间提升10倍,而精度和性能却不掉点。
这一压缩工作也帮助该团队获得了IJCAI 2025全球最佳论文奖,也是近五年唯一获此奖项的中国大陆团队。依托这一能力,「眸深智能」可在两周内完成一套具身大模型从一个本体到另一个本体的适配,包括复旦自研的“光华1号”、宇树G1、上海人形机器人创新中心的“青龙”和“灵龙”等本体。
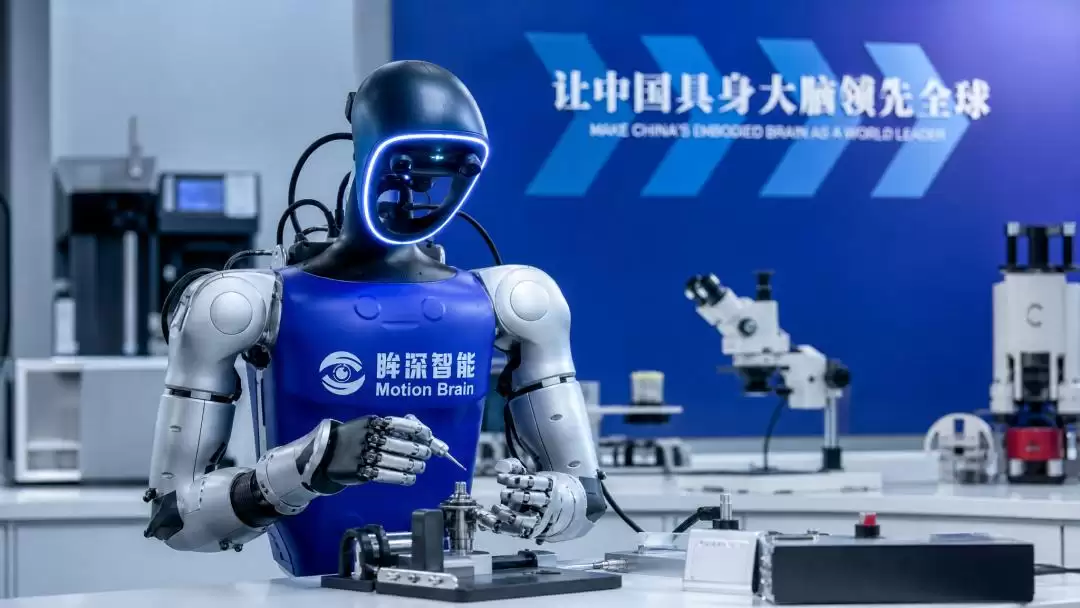
创始人、CEO穆泽林表示,国内具身智能行业普遍采用在国外芯片上训练、再移植适配国产芯片的方案,性能损耗与兼容性问题突出。而「眸深智能」未来在模型训练、推理全流程中,将基于国产算力芯片原生开发,实现技术栈完全自主可控。
商业化落地:已实现千万级营收
在商业化层面,「眸深智能」也是目前国内少数有营收的具身智能大脑公司。穆泽林透露,2025年审计回款收入千万元,2026年上半年3000万元,预计今年营收规模5000万元以上。
目前,公司客户覆盖工业检测、物业、环卫等场景。2026年第一季度,已与某港股上市物业公司、A股上市环卫龙头的机器人产品完成交付;正在推进与头部连锁零售集团、头部白色家电工厂的人形机器人落地场景研发。
以下是硬氪与穆泽林的交流实录(略经摘编)
硬氪:动作怎么变成Token?这是行业难点吗?
穆泽林:确实是行业卡点。我们可以把动作理解为「数字化的姿态」:就像小人书的一页是一个静态姿势,连续翻页就成了动画。我们早期通过几十人团队手工标注了几万个姿态,定义了3000多个基础动作Token,类似汉字的3000个常用字,组合后能覆盖人类所有行为。
更核心的是让模型学习动作间的关联。就像大语言模型通过学习海量文本掌握字词排列规律,我们让模型观看百万小时的互联网视频(影视剧、监控、Vlog等),学习「喝水时手会抬到嘴边」「抱胸后大概率会展开手臂」这类动作因果逻辑。同时结合10%的动捕数据和10%的真机数据做校准,最终实现动作Token的端到端生成——支持从文本、图片、3D点云到动作的转化,也就是原生多模态能力。
硬氪:动作Token的组合会不会导致算力需求爆炸?如何优化?
穆泽林:我们不需要穷举所有动作,而是学习动作的排列规律。优化主要有两个方向:
- 一是数据层面,80%用互联网视频(已做物理先验过滤,确保符合现实规律),降低对高成本动捕/真机数据的依赖。
- 二是模型压缩层面,我们在端侧部署上有深厚积累,曾获得全球顶会最佳论文。通过Token剪枝、量化、动态优化等技术,能把端侧计算量降低62倍,推理延时从200毫秒压缩到10毫秒,模型参数量减少80%的同时精度不降反升(部分任务提升3%-6%)。
硬氪:现在具身智能领域技术路线分化,有的侧重记忆,你们是侧重动作,您怎么看这种分化?
穆泽林:回归第一性原理:大语言模型的成功本质是Transformer架构实现了Token的排列生成。具身智能也应该遵循这个逻辑,核心是解决「执行层」问题——让机器人能稳定完成任务。像记忆优化这类更底层的问题,我认为短期很难通过初创公司突破,需要DeepSeek、OpenAI这类巨头在芯片存储、存算一体架构上的长期探索。我们更务实:通过动作Token的泛化能力(Zero-Shot)解决新任务执行问题,比如机器人学过拿矿泉水瓶,没学过拿手机,也能通过动作序列迁移完成80%的准确度,剩余20%通过少量后训练或强化学习校准即可。
硬氪:为什么选择适配国产算力,而不是用更成熟的英伟达卡?
穆泽林:长期来看,国产GPU是必然选择——N卡会越来越贵、供应受限。我们的核心优势是「懂芯片」:团队有海思、英特尔、英伟达三大芯片巨头的背景,是国内唯一具备算子级适配能力的具身大模型团队。目前已经打通了燧原S60、昇腾310/910等国产芯片的部署,下半年目标是攻克千卡级国产集群训练,实现纯国产化的大模型训练方案。这不仅能解决供应链安全问题,更能提升资本效率:比如别人训练一次需要1万张卡、花费5亿,我们通过算子优化,1000张卡、5000万就能完成,类似DeepSeek的低成本训练逻辑。
硬氪:具身智能芯片的机会在哪里?你们会自己做吗?
穆泽林:端侧具身芯片确实是大机会,目前国内已有20多家公司在布局,但大多瞄准200TOPS算力(类似英伟达Orin)。我们认为未来模型需要处理触觉、传感器、3D点云等多模态信号,算力需求会快速提升到1000-2000TOPS——如果芯片公司现在量产200TOPS的产品,等流片出来时可能已经跟不上模型迭代速度。我们不会自己做芯片,除非未来公司规模达到数千亿级。现阶段更聚焦「软硬协同」:通过算子优化让模型适配现有芯片,和芯片公司合作而非重复造轮子。
硬氪:未来产业分工会是怎样的?大脑和本体是否会各自形成通用供应商?
穆泽林:本体可能会像汽车行业一样,有不同的特色(比如负载更大、更轻量化)。但大脑领域大概率会形成「一超多强」格局——通用大脑的研发门槛极高,国内真正具备研发能力的团队屈指可数。我们目标是成为那个「超级通用大脑」,同时允许其他团队聚焦细分场景(比如快递分拣、电力巡检)。5-10年内,不会出现每家机器人公司都自研大脑的情况——大脑的研发投入(人才、算力)远超本体,创业公司更有机会突破,就像OpenAI不是大厂孵化的。大厂的优势在纯软件场景,而具身智能需要软硬件深度结合,创业公司的灵活性和专注度更有优势。


免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 美国科学家把塑料瓶做成3D打印饼干:富含高蛋白质
- 时间:2026-08-25
-
- 周靖人成为阿里首位首席科学家背后的意义与影响
- 时间:2026-08-18
-
- 阿里首席科学家周靖人被曝离职,通义团队再失核心?
- 时间:2026-08-17
-
- 中国科学家造出全新拓扑光子高速路 片上光子计算获突破
- 时间:2026-07-28
-
- 谷歌AI天团离职潮 27亿留不住核心大牛 科学家投奔对手
- 时间:2026-07-28
-
- 前大疆科学家创业半年连获四轮数亿融资,耀途资本等押注
- 时间:2026-07-25
-
- SciReasoner用结构AI推理蛋白质小分子与材料性质
- 时间:2026-07-23
-

- 全球已知最深鲸类“大墓地”!科学家发现530万年前鲸类化石群
- 时间:2026-06-11
精选合集
更多大家都在玩
大家都在看
更多-

- 蚂蚁新村小课堂今日答案10月23日 江苏溧阳的跳幡神是一种
- 时间:2026-10-23
-
- 蚂蚁新村2026年10月23日答案最新
- 时间:2026-10-23
-
- 蚂蚁庄园答案2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园今天答题答案2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园今日答案2026年10月24日
- 时间:2026-10-23
-
- 秦始皇陵地宫至今未发掘,主要原因是 蚂蚁庄园今日答案10.24
- 时间:2026-10-23
-
- 小鸡答题今天的答案是什么2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园每日答题答案2026年10月24日
- 时间:2026-10-23