ACL 2026美团论文精选:能力评测与推理优化,生成式AI新范式
时间:2026-07-27 | 作者:游戏探长 | 阅读:0美团技术团队在ACL 2026国际顶会上一口气拿下了6篇论文。研究范围覆盖了大模型评测、复杂流程推理、数学思维优化、强化学习,以及生成式推荐——几乎囊括了当前NLP最热门的几个赛道。这些成果不只是学术层面的“刷存在感”。更关键的是,它们为生成式AI在真实业务场景里落地,提供了实打实的技术路径和理论支撑。
核心要点
- 顶会认可:6篇论文被计算语言学顶级会议ACL 2026收录,直接证明了美团在NLP领域的国际竞争力。
- 覆盖面广:研究横跨大模型评测、复杂流程推理、竞赛级数学思维优化、强化学习优化和生成式推荐等多个核心方向。
- 范式创新:论文重点探讨如何从基础能力评测转向深层推理优化,试图构建生成式AI的新范式。
- 实战导向:技术研究紧密结合实际应用场景,比如数学思维优化和生成式推荐,对行业有很高的参考价值。
详细分析
大模型评测与复杂流程推理的深度探索
在ACL 2026收录的论文里,美团技术团队对大模型的评测体系做了一次系统性反思。模型规模越来越大,传统的评测指标已经很难全面衡量模型到底有多“聪明”。
美团的关注点不只是模型在标准化测试里拿多少分。更深入到了模型处理复杂流程推理时的逻辑严谨性。这种从“结果导向”向“过程推理导向”的转变,正是当前大模型研究的重要趋势。
通过构建更科学的评测框架,研究者能更精准地定位逻辑链条中的薄弱环节。这为后续的针对性优化指明了方向。
竞赛级数学思维与强化学习的协同优化
数学思维能力一直被看作是衡量大模型智能水平的“试金石”。美团这次入选的论文中,专门针对竞赛级数学思维优化提出了创新方案——引入强化学习优化技术,让模型在处理高难度数学问题时,推理路径变得更清晰。
强化学习通过奖励机制,引导模型在不断的试错和反馈中学习更优的解题策略,而不是简单的模式匹配。这种优化不仅提升了数学领域的表现,也为其他需要严谨逻辑推理的领域提供了可借鉴的技术路径。
生成式推荐:重塑用户交互与分发逻辑
生成式推荐是这次论文精选的另一大亮点。传统推荐系统大多基于判别式模型,而生成式推荐则利用大模型的生成能力,直接生成推荐结果或解释。美团的研究探讨了如何将生成式AI与推荐逻辑深度融合,实现更具个性化和交互性的推荐体验。
这种新范式不仅能提高推荐的精准度,还能通过生成式的语言描述,增强用户对推荐结果的理解与信任。这意味着推荐系统正从“计算匹配”向“理解生成”跨越。
行业影响
美团在ACL 2026上的表现,折射出互联网大厂在AI科研领域的战略重心正在转移。首先,对推理优化的重视说明行业已经进入“深水区”。不再满足于简单的文本生成,而是追求更高阶的逻辑处理能力。
其次,强化学习与大模型的结合已经成为提升模型上限的关键手段。最后,生成式推荐的研究预示着未来电商及生活服务平台的交互逻辑将发生根本性变革。
这些成果不仅提升了美团自身的技术储备,也为全球NLP社区贡献了宝贵的实践经验。它们推动了生成式AI向更专业、更智能的方向演进。
常见问题
问题 1:ACL会议在行业内的地位如何?
ACL(Association for Computational Linguistics)是计算语言学和自然语言处理领域最具影响力的国际顶级学术会议。被ACL收录的论文通常代表了该领域最前沿的研究水平和技术风向标,是衡量企业或研究机构科研实力的重要指标。
问题 2:美团本次研究的“生成新范式”核心指什么?
“生成新范式”主要指从单纯的文本生成转向具备深层逻辑推理、自我优化能力以及与特定业务场景(如推荐、数学解题)深度融合的AI模型构建方式。它强调模型不仅要“能说”,更要“能思考”和“能决策”。
问题 3:强化学习在大模型优化中起到了什么作用?
强化学习通过奖励机制引导模型产生更符合人类逻辑或特定目标的输出。在美团的研究中,强化学习被用于优化数学思维和复杂推理,帮助模型在面对复杂任务时,通过不断的反馈迭代,找到最优的推理路径和解决方案。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- 如何禁止网站内容加入谷歌AI搜索并自主决定是否收录
- 时间:2026-08-21
-
- 长安汽车天枢大模型通过国家生成式AI备案成重庆车企首家
- 时间:2026-08-21
-
- 长安天枢大模型通过国家生成式AI备案引领汽车行业新发展
- 时间:2026-08-21
-
- Snap分拆生成式AI视频团队成立Dotmo以缓解高研发成本压力
- 时间:2026-08-15
-
- 挪威出台新规限制6至13岁小学生原则上使用生成式AI
- 时间:2026-08-15
-
- 生成式AI合规指南:大模型备案与服务登记区别解析
- 时间:2026-08-15
-
- 商汤科技获评Gartner 2026生成式AI计算机视觉创新者
- 时间:2026-07-21
-
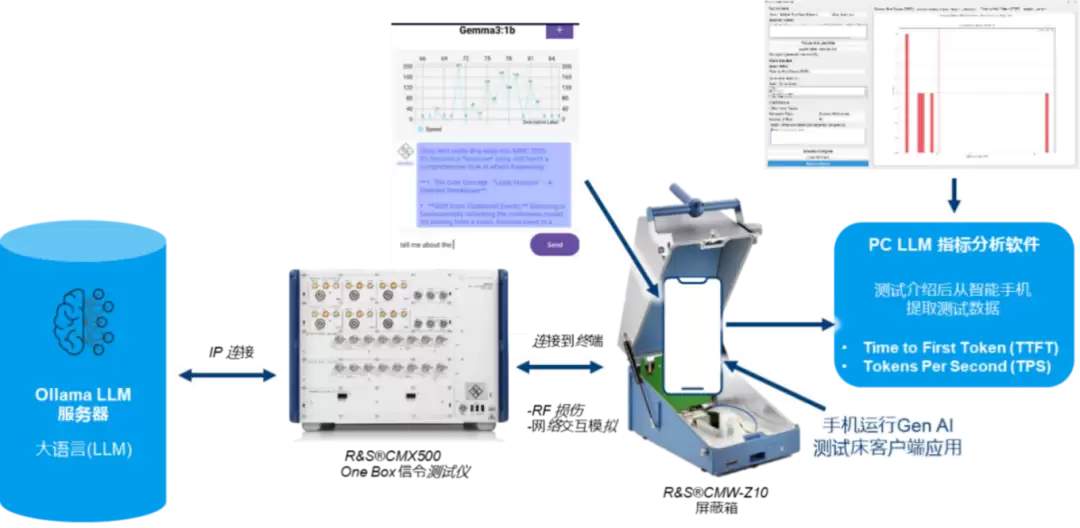
- 罗德与施瓦茨携手中国移动研究院展示生成式AI测试方案
- 时间:2026-07-21
精选合集
更多大家都在玩
大家都在看
更多-
- 闪烁之光法师及坦克符文推荐
- 时间:2026-10-21
-
- 闪烁之光三灵系玩法解析
- 时间:2026-10-21
-
- 闪烁之光高速爆发流攻略
- 时间:2026-10-21
-
- 闪烁之光食魇天马和金羽鸾适配场景
- 时间:2026-10-21
-
- 闪烁之光永恒纪元钟效果解析
- 时间:2026-10-21
-
- 闪烁之光神装选择思路
- 时间:2026-10-21
-
- PS怎么用魔棒抠图
- 时间:2026-10-21
-
- OBS Studio怎么设置音频输入源
- 时间:2026-10-21