LongCat开源VitaBench 2.0填补真实生活场景长期动态智能体评测空白
时间:2026-07-27 | 作者:云端旅人 | 阅读:0美团技术团队旗下的 LongCat 项目,最近正式开源了一个新东西——VitaBench 2.0。
这个名字听起来有点技术感,但它的定位其实很接地气:这是业界首个专门针对“真实生活场景下长期动态用户建模”的智能体评测基准。
简单说,就是看大语言模型在跟用户长期打交道的过程中,能不能记住你的习惯、预判你的需求,主动帮你把事情办好。
核心要点
- 开源发布:美团 LongCat 团队正式推出并开源了 VitaBench 2.0 评测基准。
- 首创性:业界首个专注于真实生活场景、面向长期动态用户建模的智能体评测工具。
- 核心维度:系统性评测大语言模型在长期互动中的“个性化”与“主动性”。
- 应用导向:强调在真实、动态的用户互动环境中检验智能体的实际表现。
详细分析
长期动态用户建模的突破
现在市面上大多数 AI 评测基准,基本还停留在“单次任务”或“短期对话”的层面。
比如你问它一个问题,它答对了就算厉害。但真实生活里,用户的需求是随时间变化的——你昨天喜欢喝冰美式,今天可能因为感冒想喝热牛奶。一个称职的智能体,应该能记住这些变化,并自动调整策略。
VitaBench 2.0 的推出,意味着评测标准从“静态任务处理”跃升到了“长期关系建模”。它通过引入长期动态用户建模,可以更准确地衡量模型是否真的记住了用户的历史偏好、习惯,并且能随着环境变化灵活调整服务策略。
评估个性化与主动性的新标准
VitaBench 2.0 把“个性化”和“主动性”作为核心指标。
这可不是随便说说——个性化要求模型能基于长期互动数据构建精准的用户画像;主动性则考察模型是否能在合适的时机主动出击,比如你还没开口,它就提醒你“今天该交水电费了”或者“上次你说想买的那本书降价了”。
这种系统性评测框架,为大语言模型在生活助手、智能客服等领域的落地提供了一把科学的尺子——到底行不行,拉到真实场景里一测便知。
真实生活场景的深度融合
跟实验室里那些模拟数据不同,VitaBench 2.0 强调“真实生活场景”。
评测数据和任务设置高度贴合用户日常可能遇到的复杂情况——比如你同时有多个日程冲突、或者突然改变就餐偏好。这种真实性意味着评测结果有很高的行业参考价值,能直接反映模型在处理衣食住行等实际问题时的优劣,从而帮助开发者针对性地提升模型在动态环境下的鲁棒性。
行业影响
VitaBench 2.0 的开源,对整个 AI 行业来说是一次重要的补给。
首先,它填补了长期动态智能体评测的空白,让开发者有一套标准化的工具可用,加速个性化 AI 助手的研发进程。
其次,作为美团技术团队的作品,这个基准天然带有浓厚的生活服务场景色彩——本地生活、电子商务,正是大模型落地的热门领域。
最后,开源本身也体现了技术共享的精神,有助于整个社区一起探索智能体在复杂动态环境下的进化路径。
常见问题
什么是 VitaBench 2.0?
VitaBench 2.0 是美团 LongCat 团队开源的、首个针对真实生活场景、面向长期动态用户建模的智能体评测基准。
它与传统的 AI 评测基准有什么不同?
传统基准大多关注短期任务或通用能力,而 VitaBench 2.0 侧重评估模型在长期、动态互动中的表现,尤其是它能否展现出个性化的服务水平和主动提供帮助的能力。
为什么“主动性”在智能体评测中很重要?
一个优秀的智能体不应该只是被动等待指令,而是能提前预判用户需求并主动介入。VitaBench 2.0 通过系统化评测,鼓励开发者在这方面下功夫,让模型真正变得“贴心”起来。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 美团回应LongCat模型负责人离职传闻,持续推进国产算力大模型落地
- 时间:2026-08-15
-
- 美团发布全场景AI Agent平台CatPaw与LongCat 2.0开源大模型
- 时间:2026-08-15
-

- 美团回应LongCat核心负责人离职传闻否认离职
- 时间:2026-08-15
-

- 美团LongCat团队基础模型负责人裴鹏即将离职
- 时间:2026-07-28
-

- 美团开源LongCat-2.0:1.6T参数规模,创新架构赋能Agentic Coding与国产算力适配
- 时间:2026-07-28
-

- 美团发布首个国产五万卡集群训练1.6万亿参数大模型LongCat-2.0
- 时间:2026-07-27
-
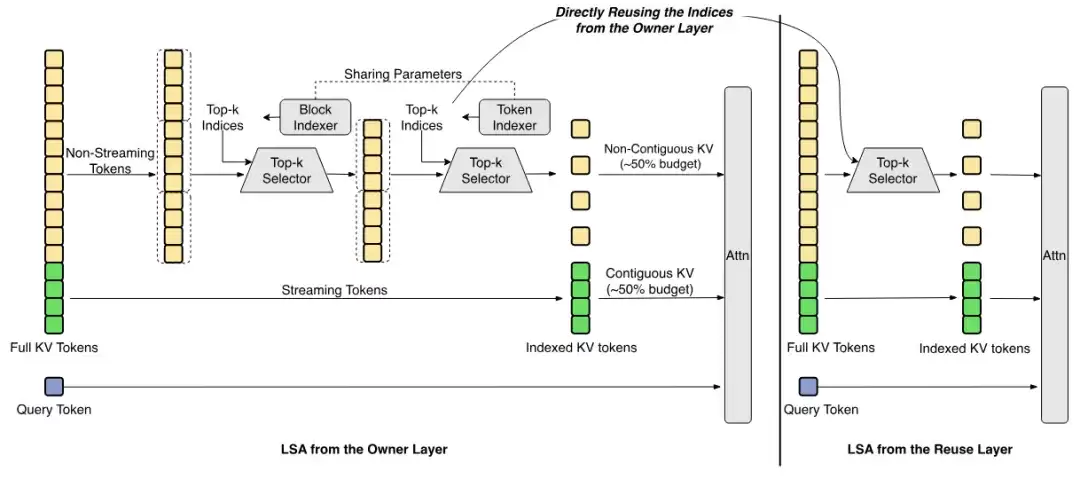
- 美团开源LongCat-2.0大模型:1.6T参数助力Agentic Coding及国产卡推理
- 时间:2026-07-27
-

- LongCat开源VitaBench 2.0 长期动态智能体基准新标杆
- 时间:2026-07-27
精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 广式月饼中的经典口味是什么
- 时间:2026-09-24
-

- 月光闪耀,食神驾到!《闪烁之光》中秋【宴月】专服重磅开启,万份美食免费送!
- 时间:2026-09-24
-
- 蚂蚁新村小课堂今日答案9月24日 煤提质工这一职业诞生于哪种时代背景
- 时间:2026-09-24
-
- 蚂蚁新村2026年9月24日答案最新
- 时间:2026-09-24
-
- 蚂蚁庄园答案2026年9月25日
- 时间:2026-09-24
-
- 蚂蚁庄园今天答题答案2026年9月25日
- 时间:2026-09-24
-
- 今日小鸡庄园答案2026.9.25
- 时间:2026-09-24
-
- 蚂蚁庄园今日答案2026年9月25日
- 时间:2026-09-24