美团开源LongCat-2.0:1.6T参数规模,创新架构赋能Agentic Coding与国产算力适配
时间:2026-07-28 | 作者:夜鞌不睡 | 阅读:0美团技术团队最近又有大动作——正式开源了 LongCat-2.0 大模型。
这款模型总参数量高达 1.6T。但实际推理时,平均激活的参数量只有 48B 左右。属于典型的“巨量参数、高效激活”路线。
最值得关注的是,它并非为了刷榜而生。而是实打实地聚焦在 Agentic Coding(智能体编程)场景。目标就是让代码理解、生成和执行这条链路跑得更顺。
除此之外,美团还同步开放了国产卡的推理代码。这对于国内算力生态的适配来说,信号意义不可小觑。
核心要点
- 超大规模参数:1.6T 总参数量,动态激活后平均约 48B。参数量级与推理效率兼顾。
- 专为编程设计:定位清晰,就是为真实的 Agentic Coding 任务服务。从代码理解到生成再到执行,全线强化。
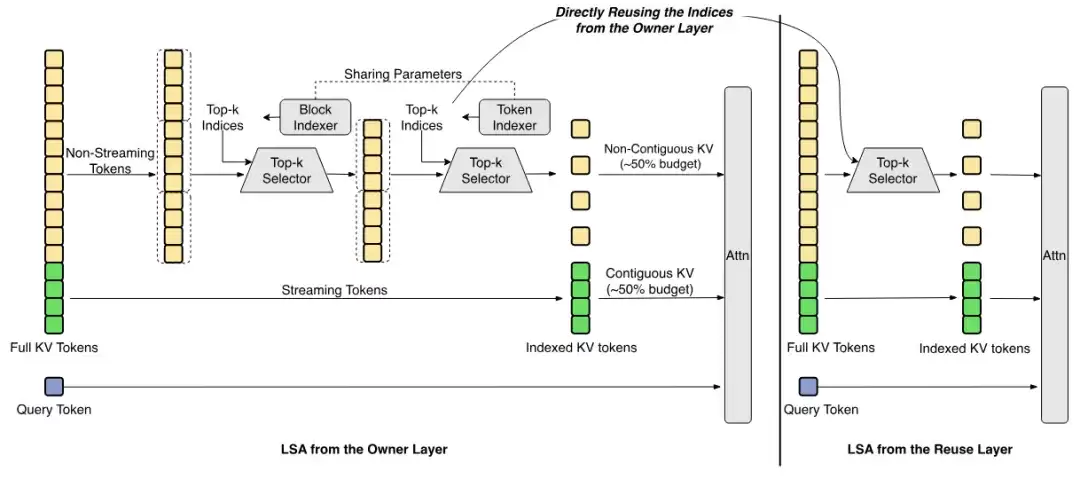
- 架构技术创新:LongCat 稀疏注意力 + N-gram Embedding。长上下文处理效率和 Token 级别表示能力双双提升。
- 国产算力支持:同步开放国产卡推理代码。降低在国产硬件环境下的部署门槛。
详细分析
架构创新:LongCat 稀疏注意力与 N-gram Embedding
这次在架构上下的功夫,可以说直指大模型在代码场景下的核心痛点。复杂的 Agentic Coding 任务,动辄要处理大量代码库引用和长程逻辑依赖。上下文窗口稍有不足,模型就容易“断片”。
LongCat 稀疏注意力机制的引入,就是为了解决这个效率瓶颈——让模型在长上下文中跑得更快、更准。与此同时,N-gram Embedding 的加入,让模型在 Token 级别的表示能力上更敏锐。代码里那些细微的语法结构和语义差异,都能被更好地捕捉。
性能优化:动态激活与代码执行能力
1.6T 的总参数量,听起来确实吓人。但动态激活技术让实际跑起来的参数规模维持在 48B 左右。这意味着模型既有大容量带来的知识储备,又不会在推理时显得过于笨重。
结合架构上的改进,LongCat-2.0 在代码理解、生成和执行这三个关键维度上,表现都相当能打。尤其是在面对智能体编程场景下的复杂需求时,竞争力明显更强。
生态适配:同步开放国产卡推理代码
美团这次开源,诚意很足。除了模型权重,还专门放出了国产卡的推理代码。这个动作的意义在于,它让模型在国产 AI 芯片上的部署和推理变得顺畅不少。
不依赖 CUDA 生态,也能跑起来超大规模模型。对国内开发者来说,这不仅是工具支持,更是实实在在的参考范本。
行业影响
LongCat-2.0 的开源,可以看作 Agentic Coding 领域迎来了一款更有分量的生产力工具。1.6T 的参数规模,加上针对长上下文的优化,有望推动 AI 编程助手从“代码补全”这种辅助角色,向更复杂的“自主编程智能体”演进。
同时,对国产卡推理代码的同步开放,对于构建国产算力大模型生态来说,示范价值相当突出。有助于加速国产硬件在高端 AI 模型推理领域的落地。
常见问题
LongCat-2.0 的主要应用场景是什么?
专门为 Agentic Coding(智能体编程)任务设计。适用于需要深度理解长代码上下文、生成复杂逻辑代码以及执行代码任务的自动化编程场景。
该模型在架构上有哪些独特之处?
核心创新在于 LongCat 稀疏注意力和 N-gram Embedding。前者提升了处理长文本的效率,后者强化了对代码 Token 的表示能力。再配合动态激活机制,实现了高性能与高效率的平衡。
是否支持在国产算力平台上运行?
是的。美团技术团队在开源模型的同时,同步开放了国产卡推理代码。专门用于支持和优化在国产硬件环境下的模型推理表现。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 美团回应LongCat模型负责人离职传闻,持续推进国产算力大模型落地
- 时间:2026-08-15
-
- 美团发布全场景AI Agent平台CatPaw与LongCat 2.0开源大模型
- 时间:2026-08-15
-

- 美团回应LongCat核心负责人离职传闻否认离职
- 时间:2026-08-15
-

- 美团LongCat团队基础模型负责人裴鹏即将离职
- 时间:2026-07-28
-

- 美团发布首个国产五万卡集群训练1.6万亿参数大模型LongCat-2.0
- 时间:2026-07-27
-
- LongCat开源VitaBench 2.0填补真实生活场景长期动态智能体评测空白
- 时间:2026-07-27
-
- 美团开源LongCat-2.0大模型:1.6T参数助力Agentic Coding及国产卡推理
- 时间:2026-07-27
-

- LongCat开源VitaBench 2.0 长期动态智能体基准新标杆
- 时间:2026-07-27
精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 广式月饼中的经典口味是什么
- 时间:2026-09-24
-

- 月光闪耀,食神驾到!《闪烁之光》中秋【宴月】专服重磅开启,万份美食免费送!
- 时间:2026-09-24
-
- 蚂蚁新村小课堂今日答案9月24日 煤提质工这一职业诞生于哪种时代背景
- 时间:2026-09-24
-
- 蚂蚁新村2026年9月24日答案最新
- 时间:2026-09-24
-
- 蚂蚁庄园答案2026年9月25日
- 时间:2026-09-24
-
- 蚂蚁庄园今天答题答案2026年9月25日
- 时间:2026-09-24
-
- 今日小鸡庄园答案2026.9.25
- 时间:2026-09-24
-
- 蚂蚁庄园今日答案2026年9月25日
- 时间:2026-09-24