字节跳动原生音视频全双工大模型SeedRealtime正式发布
时间:2026-08-05 | 作者:半糖攻略君 | 阅读:0SeedRealtime是什么
在AI实时交互领域,字节跳动Seed团队最近放了一个大招——SeedRealtime。
简单来说,这是一个原生音视频全双工大模型。它能边看、边听、边说话,实现真正的全模态实时交互。
它基于统一架构,将音频、视频和文本深度融合。这打破了传统AI“一问一答”的僵局。
三个核心突破值得关注:
- 音视频联合理解
- 主动交互能力
- 流畅的对话节奏
端到端评测数据很有说服力。对话节奏问题相比级联模型减少了整整一半。目前,这个模型已经全量上线豆包App,成为业界首个大规模落地的音视频全双工AI产品。它不再只是实验室里的demo。
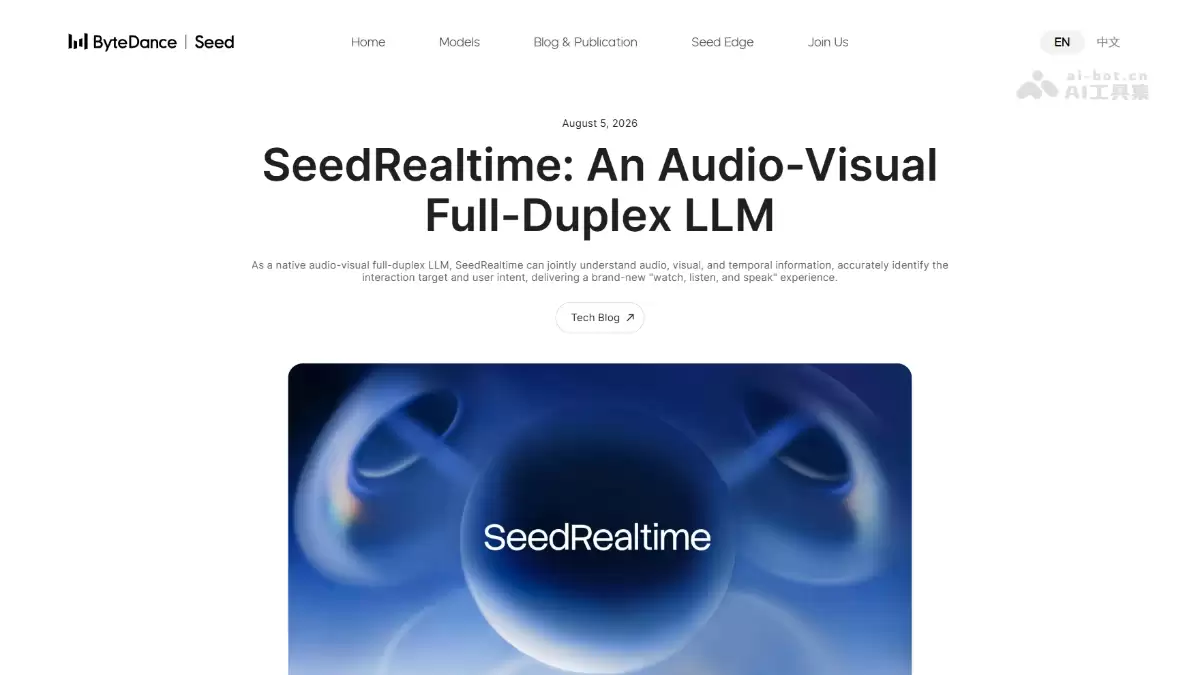
SeedRealtime的主要功能
- 音视频联合理解: 原生深度融合声音、画面与时序信息。可结合视觉场景消解同音词歧义,准确理解时序指代。实现所见所闻所说的一体化感知。
- 主动交互能力: 具备持续环境感知与主动表达能力。能在画面状态变化时主动提醒用户,并调用工具融入表达。将被动响应升级为主动协作。
- 流畅交互节奏: 实时感知用户对话状态与交流节奏。在适当时机自然接话、停顿与回应。具备较强的抗干扰能力,能分辨旁人闲聊与背景噪声。
- 多人场景识别: 在多人、嘈杂环境中,它能同步识别人脸、分辨声源、理解内容。将每个人的声音与身份持续对应,像个人类助理一样分配注意力。
SeedRealtime的技术原理
在技术原理层面,核心是四个关键词:端到端统一建模、原生全双工交互、音视频时序对齐、工程低延迟优化。
- 端到端统一建模: 采用端到端统一音视频建模框架。将感知、理解、决策与表达纳入同一模型同步进行。避免级联系统中ASR→VLM→TTS的多阶段信息损耗与延迟叠加。
- 原生全双工交互: 不依赖外部VAD规则判断轮次。模型自身基于多模态信息流持续决策对话状态与时机。真正实现“边说边听”,而非一问一答的半双工模式。
- 音视频时序对齐: 将声音、画面与时序信息统一建模。结合当前场景、手势、视线与历史动作理解用户意图。完成跨模态消歧与指代解析。
- 工程低延迟优化: 通过分块音视频输入与流式生成。结合高效量化与推理优化,持续压缩“听到—理解—回应”的端到端时延。
如何使用SeedRealtime
实际操作非常简单,只需要几步就能开始体验:
- 更新豆包App: 将豆包App更新至最新版本。
- 进入语音通话: 打开App后,在任意对话框内点击“打电话”按钮。
- 切换视频模式: 进入通话界面后,开启摄像头与麦克风权限,切换为视频通话。
- 开始实时交互: 边展示画面边自然说话,模型同步感知音视频流并实时回应。
- 使用主动观察: 可下达持续观察指令,模型在目标出现或画面变化时主动提醒。
SeedRealtime的核心优势
这些优势与上述功能一脉相承,但更聚焦于技术层面:
- 端到端统一架构: 采用单一模型原生融合音频、视频与文本。消除级联系统中多模块串联导致的信息损耗与延迟叠加。
- 原生全双工交互: 不依赖外部VAD规则。模型自主基于多模态信息流持续判断对话时机。真正实现“边说边听”,而非一问一答。
- 音视频联合理解: 深度融合声音、画面与时序信息。可结合视觉场景消解同音词歧义,准确解析“这个”“那里”等跨模态指代。
- 主动环境感知: 具备持续视觉观察能力。能在画面状态变化或目标出现时主动提醒。将交互从被动响应升级为主动协作。
- 流畅抗干扰节奏: 实时感知用户对话状态。在嘈杂环境中准确分辨闲聊与正式提问。卡顿与误触发较级联模型减少一半。
SeedRealtime的项目地址
- 项目官网: https://seed.bytedance.com/en/seedrealtime
SeedRealtime的同类竞品对比
为了更直观地理解,这里有一份SeedRealtime与Gemini Live的对比表:
| 维度 | SeedRealtime | Gemini Live |
|---|---|---|
| 开发方 | 字节跳动Seed团队 | Google DeepMind |
| 架构 | 端到端统一音视频建模,感知理解决策表达一体化 | 原生多模态,支持音频+视频+图像+文本同时输入 |
| 全双工 | 原生全双工,不依赖外部VAD,自主判断对话时机 | 全双工实时双向语音,支持主动音频输出 |
| 中文优化 | 深度优化,同音词消歧与中文语境理解强 | 通用多语言支持(200+语言),中文非专项优化 |
| 主动交互 | 持续环境感知,画面变化时主动提醒并调用工具 | 支持主动发言与工具调用,视觉主动性有限 |
| 抗干扰 | 强,可准确分辨闲聊、背景噪声与正式提问 | 内置噪声处理,复杂嘈杂环境表现中等 |
| 视觉理解 | 音视频时序联合建模,精准解析手势、指代与动态场景 | 原生视频流处理,支持摄像头实时画面分析 |
| 延迟表现 | 端到端低延迟,对话节奏问题较级联模型减少一半 | 首音频延迟约200-320ms,响应速度行业领先 |
| 生态整合 | 豆包App深度集成 | Google Workspace、Search、Meet、Android系统级整合 |
SeedRealtime的应用场景
场景化来看,SeedRealtime的潜力非常可观。以下是几个典型的应用方向:
- 智能导游: 在博物馆持续观察展品画面,目标出现时主动讲解历史背景与工艺细节。
- 外语陪练: 结合画面实时纠音、举例造句,在嘈杂环境中始终专注目标学习者。
- 设备操作指导: 操作复杂设备时,基于视觉状态变化实时纠错并给出调整建议。
- 出行信息助手: 在机场嘈杂环境中识别大屏航班信息,回答到达时间并提供路线指引。
- 儿童教育辅导: 陪孩子学习时,实时观察画面内容纠正发音,不受背景人声干扰。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Bernini:字节跳动开源统一视频生成与编辑框架
- 时间:2026-08-21
-

- 字节跳动开源Bernini框架:统一视频生成与精准编辑
- 时间:2026-08-21
-

- 字节跳动AI高管西原离职后创业 获超1亿美元融资开启新征程
- 时间:2026-08-18
-
- 字节跳动拆分AI制药业务独立融资并整合团队继续控股
- 时间:2026-08-18
-

- EvoQuality图像质量评估模型解析与应用指南
- 时间:2026-08-17
-
- 豆包2.1智能体模型系列发布:字节跳动全新AI产品解析
- 时间:2026-08-15
-
- 字节跳动设立AI新一级部门,战略布局进一步升级
- 时间:2026-08-13
-

- 字节跳动原生音视频全双工大模型SeedRealtime
- 时间:2026-08-05
精选合集
更多大家都在玩
大家都在看
更多-

- 蚂蚁新村小课堂今日答案10月23日 江苏溧阳的跳幡神是一种
- 时间:2026-10-23
-
- 蚂蚁新村2026年10月23日答案最新
- 时间:2026-10-23
-
- 蚂蚁庄园答案2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园今天答题答案2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园今日答案2026年10月24日
- 时间:2026-10-23
-
- 秦始皇陵地宫至今未发掘,主要原因是 蚂蚁庄园今日答案10.24
- 时间:2026-10-23
-
- 小鸡答题今天的答案是什么2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园每日答题答案2026年10月24日
- 时间:2026-10-23