Bernini:字节跳动开源统一视频生成与编辑框架
时间:2026-08-21 | 作者:风起客 | 阅读:0当视频生成遇见“先理解、再动手”
视频生成与编辑领域,最近出现了一个值得关注的新框架——Bernini。它来自字节跳动的开源项目,核心思路很简单:把“理解指令”和“生成画面”这两件事分开做。
过去很多视频模型之所以让人头疼,恰恰是因为它们经常“听不懂人话”。你说往左,它偏往右;你说改背景,它把整个画面都换了。
Bernini采用了一种两阶段解耦架构:多模态大模型(MLLM)负责语义规划,Diffusion Transformer(DiT)负责视觉渲染。通俗点说,就是先让模型想清楚“要拍什么”,再让它动手“画出来”。
目前,它的推理代码和权重已经全部开源,支持文本/图像生成视频、环境编辑、视角调整、动作编辑,甚至还能把多张互不相关的参考图组合成同一个视频角色。
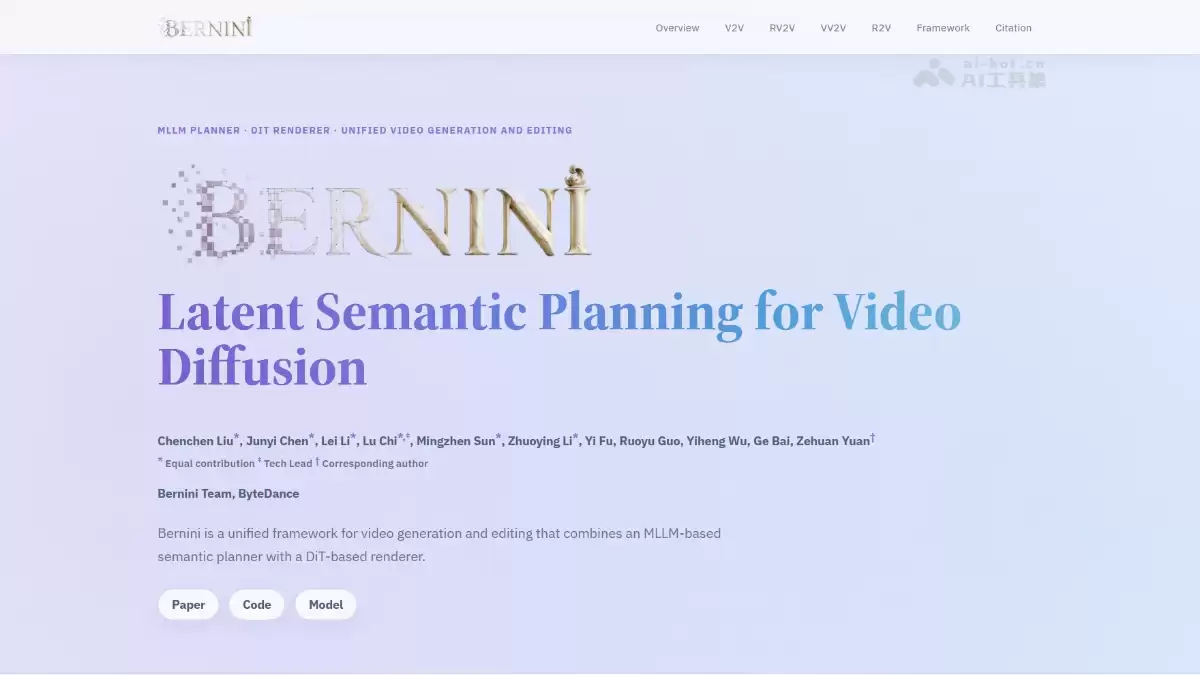
主要功能:从生成到编辑,一个框架全搞定
- 文本/图像生成视频:支持从文本提示或参考图像直接生成视频,单图、多元素组合图、多角度参考图都能处理。
- 视频编辑:环境、视角、焦点、动作四种编辑方向全覆盖。
- 参考引导编辑:把指定的物体、纹理或风格精准融入视频。主体参考图、材质参考图、风格参考图都可以作为“引子”。
- 图像/视频植入:把海报或视频填入画面中的屏幕、招牌等区域,且能跟随镜头移动,保持透视和时序稳定。这就像在实拍画面里“贴”上一块虚拟屏幕,看起来也比较自然。
- 多元素组合:把几张完全不搭边的参考图整合成同一个视频角色,或者基于同一场景的关键帧生成连续平移镜头。
技术原理:解耦,才是关键
Bernini最值得关注的,就是“两阶段解耦”架构。
第一阶段:语义规划
第一阶段,多模态大语言模型(MLLM)充当“语义规划器”(Semantic Planner)。它会在ViT嵌入空间中预测目标语义表示。
说白了,这一阶段负责理解文本指令,分析源视频和参考素材,然后规划出“最终画面应该长什么样”。
第二阶段:视觉渲染
第二阶段,Diffusion Transformer(DiT)充当“渲染器”(Renderer)。它在VAE潜在空间里执行流匹配去噪,把规划好的语义转化成高质量的视频帧。
在编辑任务中,源视频的VAE特征会被注入进来。这样一来,非编辑区域的细节就能保留下来,避免“一改全改”。
两个设计亮点
- Segment-Aware 3D RoPE(SA-3D RoPE):当多张参考图、源视频和目标输出被串联成一个统一序列时,不同片段的token可能共享相同的时空坐标。如果直接处理,模型就会“晕”,分不清哪个token来自哪个来源。SA-3D RoPE的做法,是为每个视觉片段分配一个segment索引,并整合到旋转位置编码中。这样模型既能区分不同来源,又能保留原始的时空建模特性。
- 思维链推理与三阶段训练:Planner会在潜在空间中进行思维链推理,增强复杂编辑场景下的语义保真度。训练分三阶段进行——Planner预训练、Renderer预训练、最后两者轻度联合训练,既保留了各模块的预训练优势,又维持了整体效率。
如何使用:开源项目,门槛并不高
如果你打算动手试试,流程很直接:
- 克隆仓库:从GitHub把Bernini项目拉到本地。
- 安装依赖:pip安装requirements.txt里的依赖包就行。
- 下载模型:通过HuggingFace下载Bernini-R-Diffusers权重。
- 配置环境:Python建议用3.11.2,CUDA至少12.4+,推荐Hopper架构GPU(比如H100/H800)。
- 运行生成:用torchrun执行多GPU推理脚本,指定配置文件和测试用例。
- 配置提示增强:如果想让生成质量更高,可以设置OpenAI兼容的API端点来增强文本提示。
核心优势:为什么值得关注?
- 先理解再生成:MLLM负责语义规划,DiT负责视觉渲染。这才是真正的“先想清楚再动手”。传统视频模型“听不懂人话”的痛点,在这里得到了缓解。
- 统一框架:生成、编辑、参考引导都能由单一架构覆盖,不用在不同模型之间来回切换。
- 多参考输入:文本、图像、视频可以同时输入,SA-3D RoPE保证不会出现时空混淆。
- 细节保留:编辑时会注入源视频VAE特征,非编辑区域的细节能完整保留,而不是“一改全改”。
- 完全开源:推理代码与权重全部开放,大大降低了研究与开发的门槛。
- 强泛化能力:即使在训练时没有明确覆盖的指令,比如因果推理、动作变化,它依然表现得相当不错。
项目地址
- 项目官网:https://bernini-ai.github.io
- GitHub仓库:https://github.com/bytedance/Bernini
- HuggingFace模型库:https://huggingface.co/ByteDance/Bernini
- arXiv技术论文:https://arxiv.org/pdf/2605.22344
与同类竞品的对比:Bernini vs Runway Gen-4
| 对比维度 | Bernini | Runway Gen-4 |
|---|---|---|
| 开发方 | 字节跳动(开源) | Runway(闭源) |
| 核心架构 | MLLM Planner + DiT Renderer | 专有视频生成模型 |
| 任务覆盖 | 生成+编辑统一框架 | 生成+编辑 |
| 可控编辑 | ★★★★★ 强(语义规划+多参考) | ★★★★☆ 较强 |
| 参考图支持 | ★★★★★ 多元素/多角度/材质/风格 | ★★★★☆ 支持 |
| 开源程度 | ★★★★★ 权重+代码开源 | ★☆☆☆☆ 闭源 |
| 硬件要求 | 推荐 H100/H800(8卡视频) | 云端 API |
| 视频编辑 | ★★★★★ 保留非编辑区域细节 | ★★★★☆ |
| 视觉质量 | ★★★★☆ 优秀(480p/16fps) | ★★★★★ 顶尖 |
可以看到,Bernini在可控编辑、参考图支持和开源程度上具备明显优势。如果团队有硬件条件且需要深度定制,它是目前最具性价比的选择。
而Gen-4在视觉质量和部署便利性上依然领先,适合追求“即开即用”的团队。值得注意的是,两者在实际使用中并非完全替代关系。一个更开放、更灵活,一个更成熟、更稳定。
应用场景:在哪里能落地?
- 广告创意:快速生成产品展示视频,支持产品图植入与风格调整。对于需要快速出片的广告团队来说,这能节省大量人力。
- 电商展示:基于商品多角度参考图,生成一致性高的动态展示视频。电商详情页里不再只是静态图,而是自动生成的商品演示。
- 影视预演:通过关键帧生成连续镜头,辅助虚拟漫游与场景构建。导演和美术指导可以快速验证镜头设计,降低实际拍摄成本。
- 二次创作:风格迁移、天气变换、动作编辑等操作的门槛被大幅降低。内容创作者不再需要昂贵的后期软件。
- 虚拟拍摄:把海报或视频精准填入画面中的屏幕或招牌,实现虚实融合。在影视后期和虚拟制片领域,这个能力相当实用。
话说回来,Bernini目前生成的视频分辨率在480p左右,帧率16fps,与Gen-4的顶尖画质相比还有差距。
但对于场景探索、创意验证和轻量级内容生产来说,这个易用性+开源特性已经很难得。业内关注这个方向的朋友,不妨亲自上手试试——开源的世界里,能用起来的才是真优势。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动开源Bernini框架:统一视频生成与精准编辑
- 时间:2026-08-21
-

- 字节跳动AI高管西原离职后创业 获超1亿美元融资开启新征程
- 时间:2026-08-18
-
- 字节跳动拆分AI制药业务独立融资并整合团队继续控股
- 时间:2026-08-18
-

- EvoQuality图像质量评估模型解析与应用指南
- 时间:2026-08-17
-
- 豆包2.1智能体模型系列发布:字节跳动全新AI产品解析
- 时间:2026-08-15
-
- 字节跳动设立AI新一级部门,战略布局进一步升级
- 时间:2026-08-13
-

- 字节跳动原生音视频全双工大模型SeedRealtime
- 时间:2026-08-05
-
- 字节跳动原生音视频全双工大模型SeedRealtime正式发布
- 时间:2026-08-05
精选合集
更多大家都在玩
大家都在看
更多-

- 牛奶送服药物更安全吗
- 时间:2026-09-19
-
- 2026年9月20日小鸡庄园答案
- 时间:2026-09-19
-
- 蚂蚁庄园今日答案2026年9月20日
- 时间:2026-09-19
-
- 蚂蚁庄园小课堂今日最新答案2026年9月20日
- 时间:2026-09-19
-
- 蚂蚁庄园小鸡答题今日答案2026年9月20日
- 时间:2026-09-19
-
- 蚂蚁庄园答案2026年9月20日
- 时间:2026-09-19
-
- 蚂蚁庄园答题今日答案2026年9月20日
- 时间:2026-09-19
-
- 浙江三雕是东阳木雕、青田石雕和 蚂蚁新村今日答案2026.9.19
- 时间:2026-09-19