字节跳动开源Bernini框架:统一视频生成与精准编辑
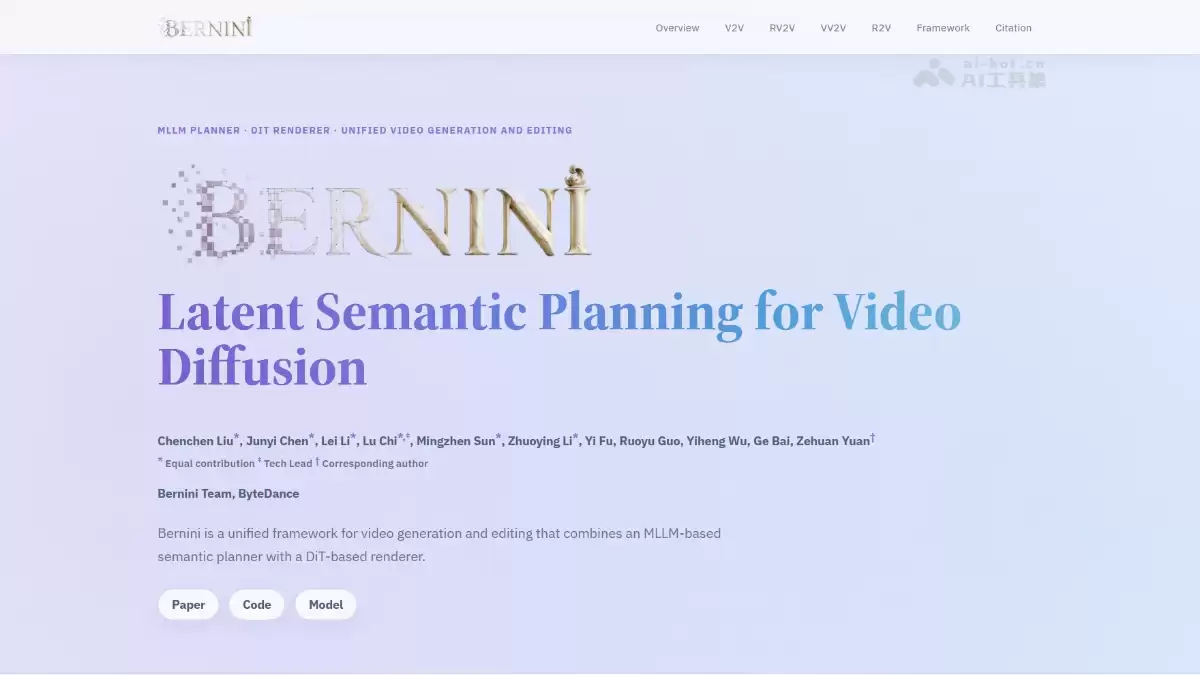
时间:2026-08-21 | 作者:夜鞌不睡 | 阅读:0字节跳动商业化技术团队最近开源了一个新的视频生成与编辑框架,名字叫Bernini。这套框架的核心思路很明确:主打“先理解、再生成”的协同机制。也就是说,先让模型真正读懂需求,再去生成画面。
过去的模型经常因为无法准确理解复杂指令,出现画面失控、帧间闪烁等问题。Bernini正是针对这些痛点而来。
目前,字节自家测试显示,Bernini已经把性能稳在了行业第一梯队。推理代码和第二阶段的模型Bernini-R已经开放权限,等全功能版本一到,就可以正式全面上手了。

核心思路:先理解,再生成
分离语义与渲染
Bernini在工作流程上做了一个巧妙拆分:把整个处理过程分成“语义规划”和“视觉渲染”两件独立的事。
系统会先让一个多模态大模型规划器深度解析输入素材,勾勒出一份“语义草图”。随后,渲染器再根据这张草稿,把目标转化成稳定、连续的视频画面。
这种清晰分工,让它在可控编辑上表现出了很高的实用价值。
给出简单指令,就能让画面里的天气自然变化;
可以调整季节与整体视觉风格;
还能精准控制镜头角度、焦点和主体动作。
说白了,这相当于把视频创作中的“想清楚”和“画出来”,分别交给两个专家去做。效果自然比一个人全包要好得多。
支持更多参考方式
丰富视觉参考维度
除了传统的文字操控,Bernini还支持拿图片和视频当视觉参考。这大大提升了创作的一致性。
比如在视频编辑场景里,你可以把特定的材质或海报精准地塞进目标区域。而且边界不破、透视不乱,看起来就像本来就在那里一样。
在新视频生成方面,这个模型不仅能支持单图和多角度参考生成,还能完成从关键帧到连续镜头的自然演变。
更值得一提的是,团队专门引入了一套专属的位置编码机制。它用于解决多视觉片段串联时模型容易混淆的问题。
让参考素材与输出目标分得更清楚;
降低多段视觉信息混用带来的干扰;
提升整体生成过程的稳定性与一致性。
这样一来,参考素材和输出目标就能分得清清楚楚,不会乱套。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Bernini:字节跳动开源统一视频生成与编辑框架
- 时间:2026-08-21
-

- 字节跳动AI高管西原离职后创业 获超1亿美元融资开启新征程
- 时间:2026-08-18
-
- 字节跳动拆分AI制药业务独立融资并整合团队继续控股
- 时间:2026-08-18
-

- EvoQuality图像质量评估模型解析与应用指南
- 时间:2026-08-17
-
- 豆包2.1智能体模型系列发布:字节跳动全新AI产品解析
- 时间:2026-08-15
-
- 字节跳动设立AI新一级部门,战略布局进一步升级
- 时间:2026-08-13
-

- 字节跳动原生音视频全双工大模型SeedRealtime
- 时间:2026-08-05
-
- 字节跳动原生音视频全双工大模型SeedRealtime正式发布
- 时间:2026-08-05
精选合集
更多大家都在玩
大家都在看
更多-

- 牛奶送服药物更安全吗
- 时间:2026-09-19
-
- 2026年9月20日小鸡庄园答案
- 时间:2026-09-19
-
- 蚂蚁庄园今日答案2026年9月20日
- 时间:2026-09-19
-
- 蚂蚁庄园小课堂今日最新答案2026年9月20日
- 时间:2026-09-19
-
- 蚂蚁庄园小鸡答题今日答案2026年9月20日
- 时间:2026-09-19
-
- 蚂蚁庄园答案2026年9月20日
- 时间:2026-09-19
-
- 蚂蚁庄园答题今日答案2026年9月20日
- 时间:2026-09-19
-
- 浙江三雕是东阳木雕、青田石雕和 蚂蚁新村今日答案2026.9.19
- 时间:2026-09-19