在报表分发、班级成绩整理、部门数据归档这类场景里,一个 Excel 文件往往带着多个工作表。手工逐个另存不仅慢,而且很容易漏表、错表或覆盖原文件。本文按“环境准备、核心实现、扩展写法、注意事项、库选型”的顺序,梳理如何用 C# 和 Free Spire.XLS 完成自动拆分,并给出判断这种方案是否适合你当前项目的依据。
为什么要按工作表拆分 Excel
把一个多工作表的 Excel 文件拆成多个独立文件,常见于以下几类任务:
- 财务部门将汇总报表拆成各部门单独文件,便于分发。
- 教育机构将总成绩表拆成各班成绩单,减少人工操作。
- 数据整理流程中,需要把不同主题的工作表拆开进入后续系统。
这类需求的共同点是:重复操作多、文件数量大、出错成本高,因此更适合交给程序完成。
技术栈与环境要求
Free Spire.XLS 适合什么场景
Free Spire.XLS 是一个免费的 .NET Excel 组件,支持创建、编辑、转换和拆分 Excel 文件。它和 Microsoft Office Interop 相比的直接优势是:不需要在服务器上安装 Office,因此更适合自动化处理和服务端环境。
如果你的目标是稳定地批量处理 Excel,而不是依赖桌面 Office 自动化,这类组件通常更省事。
环境要求
- .NET Framework 4.0 或更高版本 / .NET Core / .NET 5+
- Free Spire.XLS NuGet 包
- Visual Studio 或任何 C# 开发环境
项目准备与安装
可以先创建一个控制台项目,例如 SplitWorksheets,然后安装依赖包。使用 NuGet 包管理控制台时,命令如下:
Install-Package FreeSpire.XLS
如果你习惯图形界面,也可以直接在 Visual Studio 的 NuGet 包管理器中搜索并安装 FreeSpire.XLS。
核心实现:逐个工作表生成独立文件
拆分逻辑并不复杂,核心流程可以概括为 4 步:
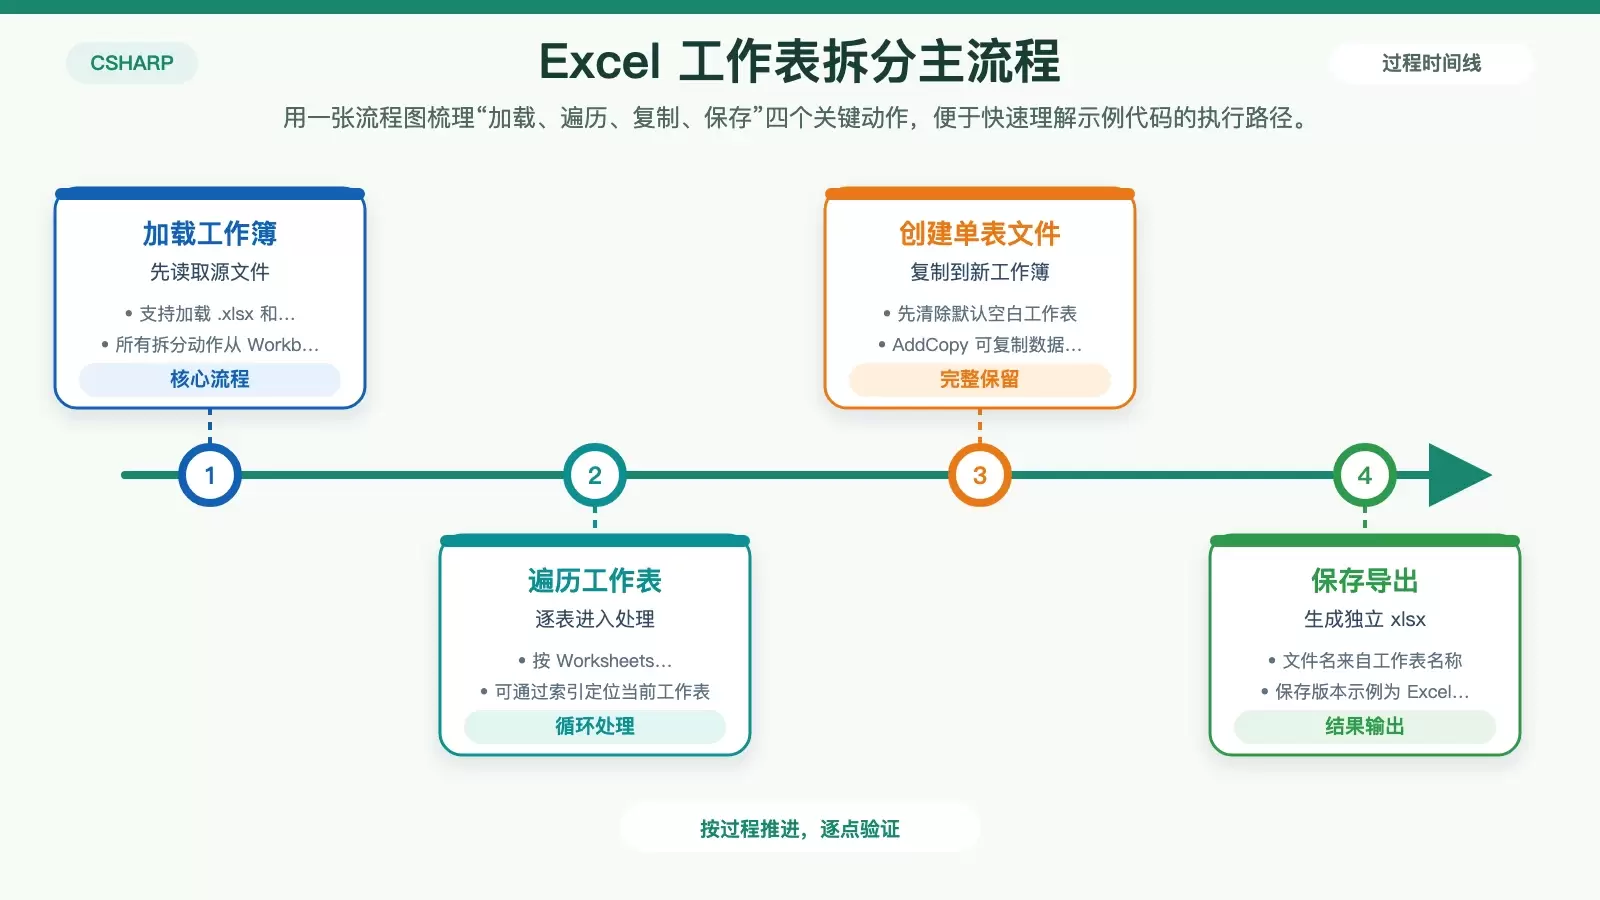
- 加载源 Excel 文件。
- 遍历工作簿中的每一个工作表。
- 为当前工作表创建一个新的工作簿并复制内容。
- 按工作表名称保存为独立的
.xlsx文件。
先引入必要命名空间:
using Spire.Xls;
using System;
示例代码如下,保留了原始实现思路:
class Program
{
    static void Main(string[] args)
    {
        // 创建Workbook对象实例
        Workbook wb = new Workbook();

        // 加载源Excel文件,支持.xlsx和.xls格式
        wb.LoadFromFile("data.xlsx");

        // 声明新工作簿变量,用于存储单个工作表
        Workbook newWb;

        // 声明字符串变量,用于存储工作表名称
        string sheetName;

        // 指定输出文件夹路径
        string folderPath = "C:UsersAdministratorDesktopOutput";

        // 确保输出目录存在,如果不存在则创建
        System.IO.Directory.CreateDirectory(folderPath);

        // 遍历源文件中的所有工作表
        for (int i = 0; i < wb.Worksheets.Count; i++)
        {
            // 初始化新的Workbook对象
            newWb = new Workbook();

            // 清除默认工作表
            newWb.Worksheets.Clear();

            // 将源文件中的特定工作表复制到新工作簿
            newWb.Worksheets.AddCopy(wb.Worksheets[i]);

            // 获取当前工作表的名称
            sheetName = wb.Worksheets[i].Name;

            // 保存新工作簿到指定文件夹
            newWb.SaveToFile(folderPath + sheetName + ".xlsx", ExcelVersion.Version2013);
        }

        // 提示用户操作完成
        Console.WriteLine("工作表拆分完成!");
    }
}
这段代码实际做了什么
Workbook:表示一个完整工作簿,负责加载、创建和保存文件。Worksheets:表示工作表集合,可通过索引或名称访问。Worksheets.Clear():去掉新工作簿里默认的空白工作表,避免导出的文件带多余页签。Worksheets.AddCopy():把原工作表的数据、格式、公式、样式等内容复制到新工作簿。SaveToFile():将结果保存到指定目录,并指定 Excel 版本,这里使用的是ExcelVersion.Version2013。
从实现上看,这种方式的优点是直接、清晰,而且通常可以保留原工作表的大部分结构信息。
进阶场景:按条件拆分与批量处理
只拆分指定工作表
如果不是每个工作表都要导出,可以先筛选再执行拆分。例如,只处理指定名称的工作表:

// 只拆分特定名称的工作表
string[] targetSheets = { "Sheet1", "Data", "Report" };
foreach (string targetSheet in targetSheets)
{
    Worksheet sheet = wb.Worksheets[targetSheet];
    if (sheet != null)
    {
        // 拆分逻辑
    }
}
如果规则更简单,也可以按索引范围处理,比如只拆分前三个工作表:
// 拆分前三个工作表
for (int i = 0; i < Math.Min(3, wb.Worksheets.Count); i++)
{
    // 拆分逻辑
}
这种写法适合测试环境、固定模板文件,或者只需要导出部分页签的业务流程。
批量处理多个 Excel 文件
如果目录里有多个 Excel 文件要拆分,建议把单文件拆分逻辑封装成方法,然后统一遍历目录:
string sourceFolder = @"C:UsersAdministratorDesktopSourceFiles";
string outputFolder = @"C:UsersAdministratorDesktopOutput";
string[] excelFiles = Directory.GetFiles(sourceFolder, "*.xlsx");
foreach (string file in excelFiles)
{
    SplitWorkbook(file, outputFolder);
}
这样做的好处是,后续如果你要增加日志、异常处理、命名规则或子目录输出,只需要改一处。
注意事项与常见问题
示例代码能快速跑通,但放到实际项目里,下面几项最好提前处理:

- 资源释放:在循环中不断创建
Workbook对象时,建议配合using或显式释放,避免内存占用持续增长。 - 路径权限:程序必须对源文件目录有读取权限,对输出目录有写入权限。
- 文件命名:如果工作表名称包含路径非法字符,直接拿来当文件名可能会保存失败,需要先做清洗。
- 输出格式:可根据接收方环境指定不同 Excel 版本,如 Excel 97-2003、Excel 2007、Excel 2010、Excel 2013、Excel 2016 等。
- 覆盖策略:当输出目录中已存在同名文件时,要提前决定是覆盖、跳过还是重命名。
尤其是“工作表名直接作为文件名”这一点,示例代码演示意义很强,但上线前最好补上合法性判断。
还有哪些可替代方案
如果你不打算使用 Free Spire.XLS,也可以按格式支持范围和使用习惯来选库:
EPPlus:开源免费,但仅支持.xlsx格式,适合简单拆分需求。NPOI:开源免费,支持.xls和.xlsx,功能强,但 API 相对更复杂。Microsoft Office Interop:依赖 Office 安装,不推荐用于服务器环境,性能、稳定性和许可上都有额外负担。ClosedXML:开源、API 友好,但仅支持.xlsx。
如果你的场景是服务器端自动拆分、批量跑任务、尽量少依赖桌面环境,Free Spire.XLS 这类方案通常更贴近实际需求;如果只处理 .xlsx,也可以比较一下 EPPlus 或 ClosedXML 的开发体验。
总结
用 C# 拆分 Excel 工作表,本质上就是围绕 Workbook 和 Worksheets 做“读取、遍历、复制、保存”四步操作。Free Spire.XLS 的优势在于接入成本低、代码短,而且不依赖 Office 安装,适合做自动化数据处理。
如果你只是验证功能,文中的基础示例已经够用;如果要放进正式项目,建议继续补上资源释放、文件名清洗、异常处理和批量任务日志,这样才能真正稳定跑在日常业务里。


