很多人第一次用 nohup 跑后台任务时,都会顺手把“持续运行”和“自动恢复”当成一回事。实际上,nohup 只解决“退出登录后进程别跟着结束”,并不处理“进程挂了以后谁来重启”。
如果你的服务偶尔会异常退出,真正要补上的,是一层重启或监控机制。下面按复杂度和使用场景拆成 4 种做法:从最轻量的 shell 循环,到更适合生产环境的 systemd 和 supervisord,再到只做定时兜底检查的 cron。看完后,你可以根据系统环境、是否要开机自启、是否要统一管多个进程来选方案。
为什么 nohup 不能自动重启进程
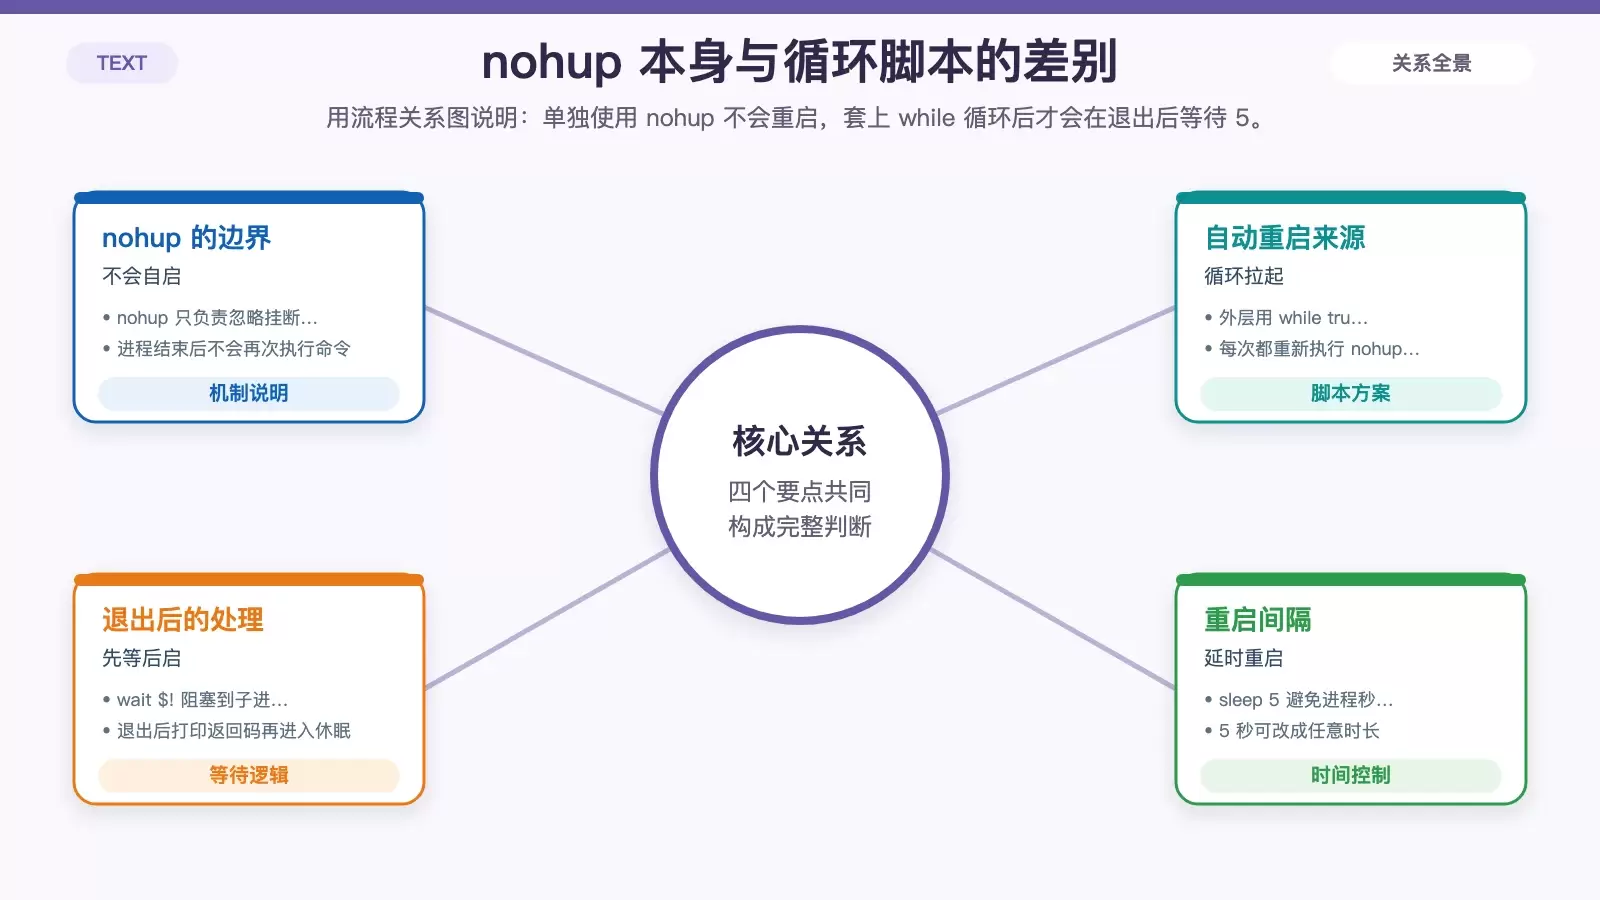
nohup 的核心作用,是让命令忽略挂断信号,在用户退出终端或断开会话后继续运行。它不会持续观察进程状态,也不会在进程退出后重新执行命令。
这意味着:只要业务进程因为异常、崩溃或正常退出而结束,nohup 的任务也就到此为止。如果你需要“挂了自动再拉起来”,必须额外加一层循环、守护或调度机制。
方案一:用 shell 循环脚本做最轻量的自动重启
如果你不想引入额外工具,最直接的办法就是写一个 while true 循环。思路很简单:启动进程,等待它退出,记录退出状态,睡眠几秒后再重新启动。
#!/bin/bash
while true; do
  nohup your_command &
  wait $!
  echo "Process exited with code $; restarting in 5 seconds..."
  sleep 5
done
把 your_command 换成你实际要运行的命令即可。脚本会一直运行,只要目标进程退出,就会在 5 秒后再次拉起;这个等待时间也可以按需要调整。
这种方法的优点是零依赖、上手快,适合临时任务、小型服务或测试环境。缺点也很明显:脚本本身需要有人维持运行,日志、开机自启、统一管理能力都比较有限。
方案二:用 systemd 托管服务,适合长期运行任务
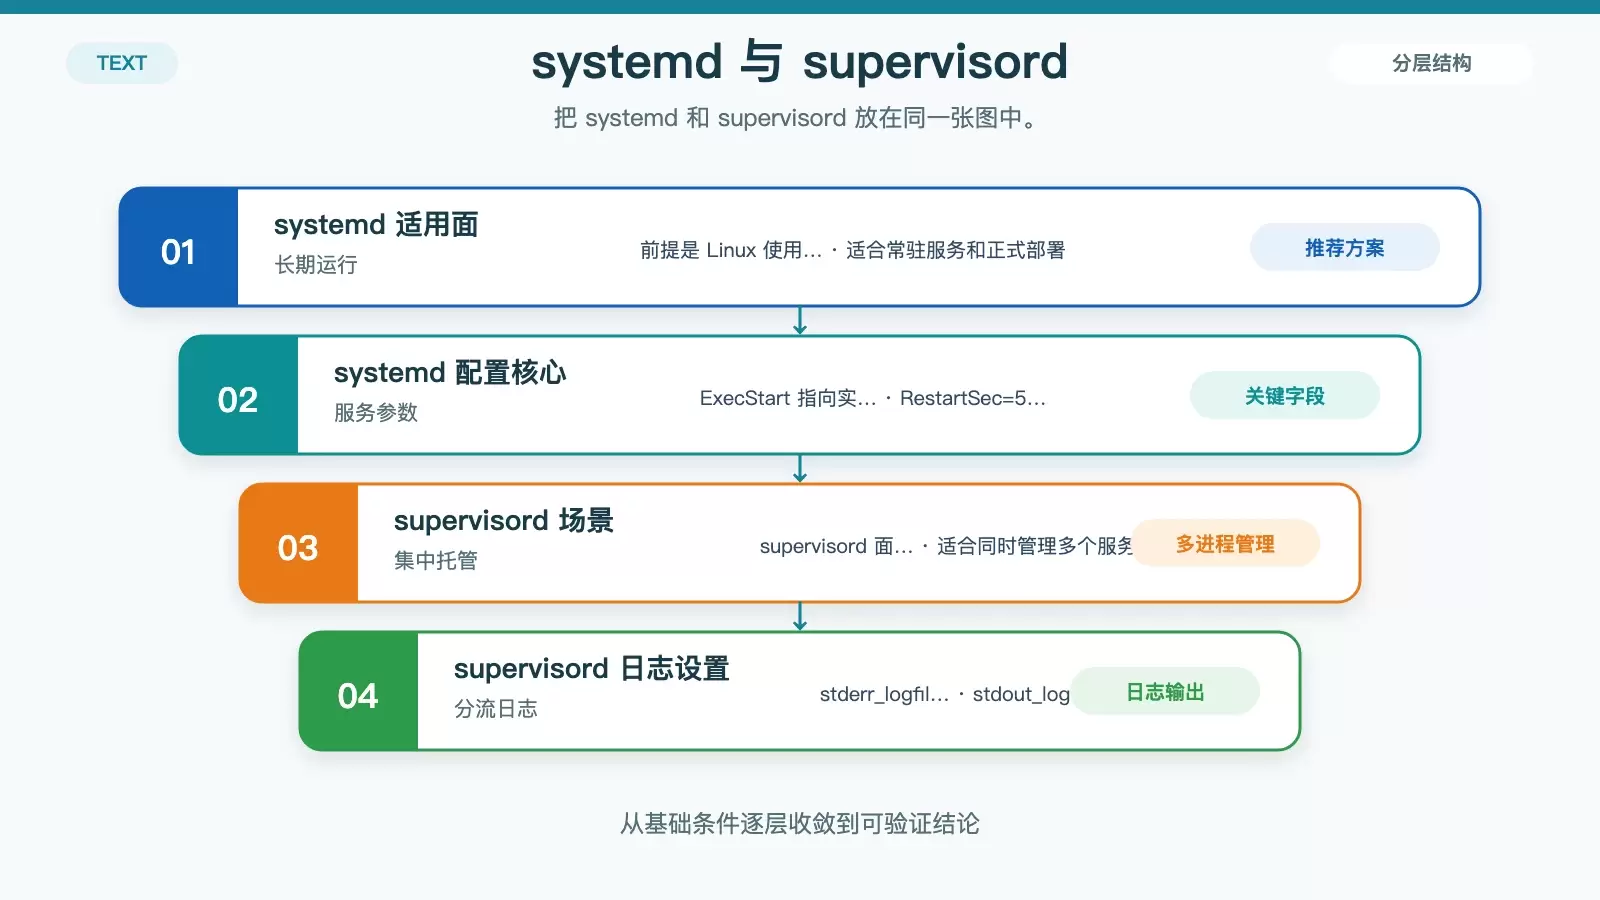
如果你的 Linux 系统本身就使用 systemd,这通常是更稳妥也更推荐的方案。它不仅能在进程退出后自动重启,还能和系统启动流程集成,适合常驻服务。
创建服务文件
sudo nano /etc/systemd/system/your_service.service写入服务配置
[Unit]
Description=Your Service Description
After=network.target

[Service]
ExecStart=/path/to/your_command
Restart=always
RestartSec=5

[Install]
WantedBy=multi-user.target
这里的 /path/to/your_command 需要替换成实际命令路径,Restart=always 表示退出后始终尝试重启,RestartSec=5 则表示等待 5 秒再重启。
加载并启动服务
sudo systemctl daemon-reload
sudo systemctl start your_service
sudo systemctl enable your_service执行完成后,服务会在后台运行;如果进程崩溃,systemd 会按配置自动拉起;同时 enable 还会让它随系统开机自动启动。
如果你的需求已经接近正式部署,例如 Web 服务、接口进程、常驻 worker,这一套通常比单纯的 nohup 脚本更合适。
方案三:用 supervisord 管多个进程更省事
supervisord 是专门做进程管理和监控的工具。相比单个 shell 脚本,它更适合需要同时维护多个服务、顺手接管日志输出的场景。
安装 supervisor
sudo apt-get install supervisor创建配置文件
sudo nano /etc/supervisor/conf.d/your_service.conf写入进程配置
[program:your_service]
command=/path/to/your_command
autostart=true
autorestart=true
stderr_logfile=/var/log/your_service.err.log
stdout_logfile=/var/log/your_service.out.log
其中 autostart=true 表示随 supervisord 启动,autorestart=true 表示异常退出后自动重启;标准输出和错误输出也会分别写入日志文件。
加载配置并启动
sudo supervisorctl reread
sudo supervisorctl update
sudo supervisorctl start your_service
配置生效后,目标进程一旦崩溃,就会由 supervisord 自动重启。对于需要统一查看状态、批量维护服务的环境,这种方式会比零散脚本更顺手。
方案四:用 cron 定时检查,做轻量级兜底
如果你不想引入完整的服务管理器,也可以用 cron 定时做健康检查。它的思路不是“实时守护”,而是“每隔一段时间看看进程还在不在,不在就重新启动”。
编辑 crontab
crontab -e添加检查规则
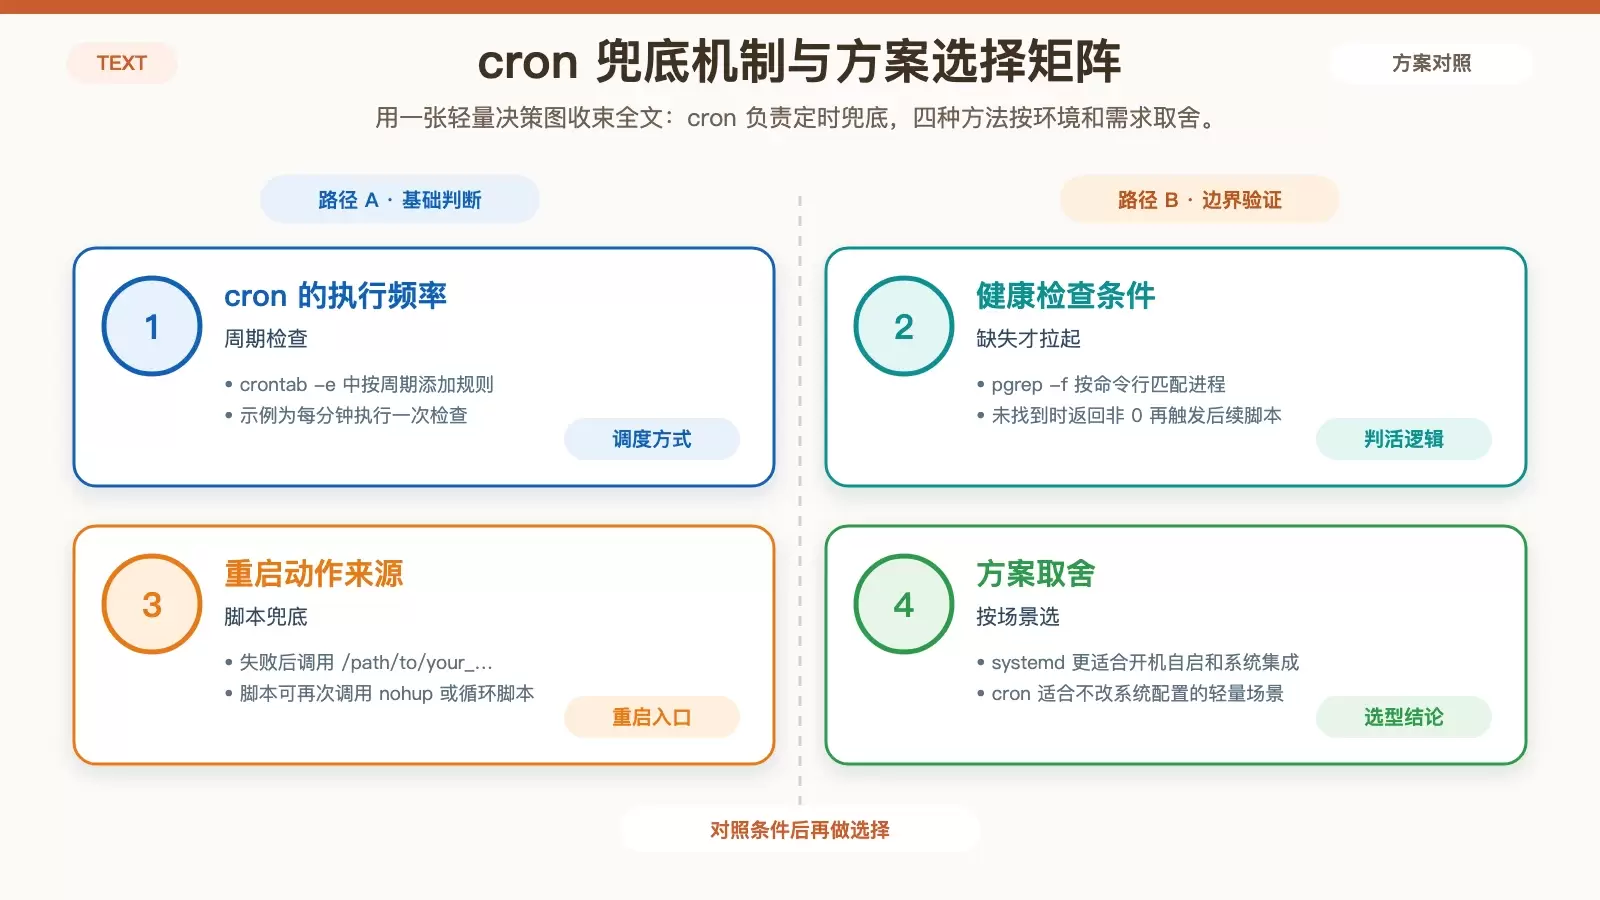
* * * * * pgrep -f your_command || /path/to/your_restart_script.sh这里的 pgrep -f your_command 会按命令行匹配进程;如果没找到进程,返回值非 0,就执行后面的 /path/to/your_restart_script.sh。
这个重启脚本可以是上面提到的循环脚本,也可以只是简单调用一次 nohup 启动命令。要注意的是,cron 的检查粒度取决于调度周期;像这里的写法是每分钟检查一次,因此它更适合容忍短时间中断的轻量场景。
怎么选:4 种方案的适用场景
如果你只是临时跑一个后台任务,或者环境很简单,不想装额外组件,那么 shell 循环脚本已经能解决问题。
如果系统已经是 systemd,并且你希望服务具备自动重启、开机自启、和系统统一管理的能力,优先考虑 systemd。
如果你需要同时管理多个进程,还想顺手处理日志和状态控制,supervisord 会更省事。
如果你既不想改服务配置,也不需要实时守护,只想做一个“掉了就补拉”的检查机制,那么 cron 是足够轻量的兜底方案。
归根结底,nohup 不是自动重启工具,它只是后台运行的起点。真正决定稳定性的,是你给进程配上的那一层守护策略。


