大模型服务高可用架构:进程保活与故障自愈实践
时间:2026-07-18 | 作者:游戏探长 | 阅读:0一、基础认知
1. 核心概念定义
1.1 进程保活
所谓进程保活,大白话来说,就是要想尽办法保证大模型的运行进程一直活着。具体是通过一系列技术手段,持续监控进程状态,确保它不会意外退出、不会被系统强制杀死、也不会悄无声息地挂掉。这是大模型能够提供稳定推理和训练服务的最基础前提。
覆盖的场景主要有哪些?比如进程突然崩溃、系统因为内存不足(OOM)把进程给终止了、程序自身异常退出,或者依赖的服务断了导致进程挂死。
核心能力则集中在几个方面:能实时检测进程是否存活、进程挂了能自动拉起来、并且能把运行状态上报出来。
1.2 故障自愈
故障自愈,通俗理解就是服务出问题了,系统自己能搞定,完全不需要人插手。整个过程是闭环的:系统自动识别故障、自动定位原因、然后自动执行修复策略,让服务恢复正常。这在无人运维体系中可以说是核心中的核心。
覆盖的场景包括:显存泄漏、内存溢出(OOM)导致的崩溃、推理请求超时、服务完全无响应、还有端口被占用等。
核心能力则包括:故障检测、原因判断、自动修复、记录自愈日志,以及发送告警通知。

1.3 显存泄漏
显存泄漏是大模型运行中最常见的“慢性病”。简单说,就是模型运行时申请的显存,用完之后没正常还回去。随着运行时间变长,显存占用持续升高,最终把显存撑爆,服务就崩溃了。
典型特征很明显:显存占用是线性增长的,重启一下就恢复正常,但只要长时间跑,必然会触发OOM。它的危害也很直接——直接导致模型推理失败、服务中断,还白白浪费硬件资源。
1.4 OOM 预警
OOM,全称Out Of Memory,内存耗尽,这是大模型服务的致命故障。预警的意思,就是在显存或内存占用还没达到极限之前,提前发出警报,并自动执行一些降载、清理的策略,争取在故障发生前就化解风险。
预警的维度主要看三点:GPU显存占用、系统内存占用、交换区使用率。核心价值在于,把传统的被动修复,变为了主动预防。

1.5 定时巡检
定时巡检,就是按照固定的时间周期,对大模型服务的各项核心指标进行全覆盖检查。包括进程状态怎么样、硬件资源是否充足、接口能不能正常访问、显存占用有没有异常等等,最后生成一份巡检报告,目的是提前发现那些隐藏的故障。
巡检频率会针对不同维度有所区分:分钟级是针对进程的,每分钟检测核心进程是否存活,秒级就能发现异常;小时级是针对硬件资源的,每小时深度采集一次数据,分析显存和算力负载,提前预警性能瓶颈;天级则是全链路深度巡检,覆盖接口可用性和日志,生成综合健康报告。核心价值就是消除那些看不见的隐性故障,保障服务长期稳定。
1.6 无人运维自愈
把进程保活、故障自愈、OOM预警、定时巡检这几件事串起来,就能构建一套全自动化的运维体系。在这套体系下,不需要人工登录服务器、不需要手动重启、也不需要自己去排查日志,系统自己能完成所有运维操作。
最终的目标就是:实现7×24小时稳定运行、零人工干预、故障对用户无感知。

2. 运维基础必备
2.1 Linux 进程基础
2.1.1 进程状态查看
用ps aux或ps -ef可以查看所有进程的详细信息。用top或htop则能实时动态查看系统进程和资源占用情况。

如果想根据名称快速找到进程PID,可以用pgrep -f <进程名>。
2.1.2 进程状态理解
要理解ps命令输出中STAT这一列的含义,比如S代表睡眠、R代表运行、Z代表僵尸进程、T代表停止。其中尤其要关注僵尸进程(Z),它表示子进程已经结束了,但父进程没去回收资源。
2.1.3 进程杀死与重启
用kill 发送SIGTERM信号,可以让进程优雅地终止。用kill -9 则是发送SIGKILL信号,强制杀死。如果同一个名称的进程有多个,可以用killall <进程名>一次性全部杀死。
2.1.4 systemd服务管理
用systemctl status <服务名>查看服务运行状态。用systemctl start|stop|restart <服务名>分别对应启动、停止、重启服务。用journalctl -u <服务名> -f则可以实时查看服务的日志输出。
2.2 GPU 硬件知识
2.2.1 nvidia-smi 命令
直接运行nvidia-smi可以查看GPU的概览信息,包括型号、显存、温度、功耗等。
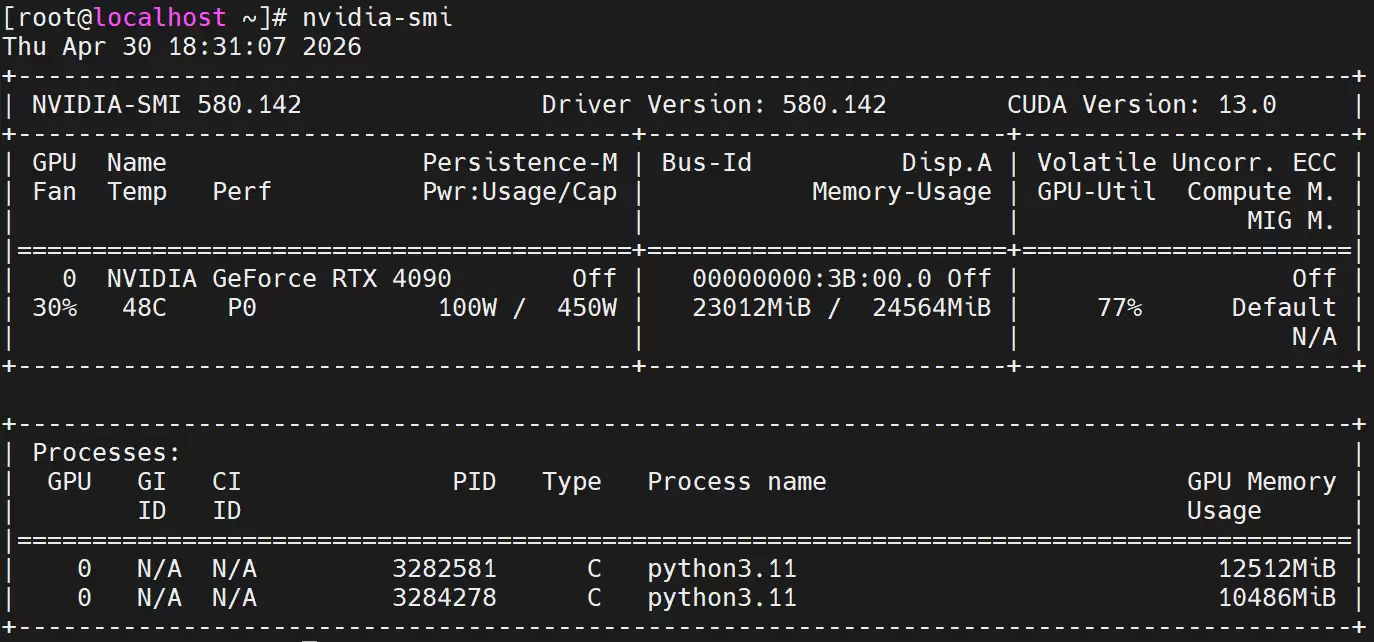
配合watch -n 1 nvidia-smi,就能每秒刷新一次,实现实时监控。

2.2.2 显存占用查看
在nvidia-smi的输出里,重点看Memory-Usage这一栏,它会显示已用显存和总显存。如果想查每个进程具体占了多少显存,可以用nvidia-smi --query-compute-apps=pid,process_name,used_memory,gpu_name --format=csv。这个命令支持的字段列表包含:timestamp(查询时间)、gpu_name(GPU设备名称)、gpu_bus_id(PCI总线ID)、gpu_serial(序列号)、gpu_uuid(唯一识别ID)、pid(进程ID)、process_name或name(进程名称)、used_memory或used_gpu_memory(占用的GPU显存)。

2.2.3 GPU利用率监控
在nvidia-smi的输出里,还要关注Volatile GPU-Util这一栏,它代表GPU计算核心的利用率。理想情况下,大模型在做推理或训练时,GPU利用率应该保持在较高水平,比如超过90%。
2.2.4 进程信息查询
用nvidia-smi pmon可以监控GPU进程,直接看到是哪个进程PID在用GPU。

2.3 Python 进程管理
2.3.1 subprocess 库
用subprocess.run()可以执行系统命令,比如启动一个模型推理脚本。用subprocess.Popen()则可以创建子进程,并能非阻塞地与它交互,比如读取它的标准输出。
2.3.2 psutil 库
psutil.process_iter()可以遍历所有进程,用来查找特定名称的进程。process.is_running()用来判断进程是否仍在运行。process.memory_info().rss可以获取进程的内存占用。psutil.cpu_percent(interval=1)则可以获取CPU使用率。
2.3.3 进程创建、监控、终止逻辑
创建:通过subprocess.Popen(["python", "inference.py"])来启动一个Python脚本。监控:在一个循环里,定期检查Popen对象的poll()方法返回值,判断进程是否结束。终止:调用Popen对象的terminate()方法发送SIGTERM,或者用kill()方法发送SIGKILL。
2.4 异常处理机制
2.4.1 Python 异常捕获
用try...except...else...finally结构来捕获和处理代码执行中可能出现的异常。比如,捕获subprocess.TimeoutExpired异常来处理命令执行超时,捕获psutil.NoSuchProcess异常来处理进程在检查时已经不存在的情况。
2.4.2 日志记录
用Python内置的logging模块,把巡检过程中的关键信息、警告和错误记录到日志文件里。要配置好日志级别(DEBUG、INFO、WARNING、ERROR、CRITICAL)和格式,这样才能方便后续问题排查。
2.4.3 服务状态判断逻辑
通过检查进程的退出码(returncode)来判断它是否正常退出。可以结合psutil检查进程状态,判断它是否处于预期的运行状态。还可以通过调用服务的健康检查接口(比如HTTP GET /health)来判断服务是否可用。
2.5 阈值与策略
2.5.1 自定义显存/内存预警阈值
设定显存占用百分比阈值,比如当显存使用率超过95%时触发预警。也设定系统内存(RAM)使用率阈值,比如超过85%时触发预警。
2.5.2 自愈触发条件
自愈不是随便就触发的,要满足一定条件。比如:进程连续几次无响应或崩溃;显存占用持续多少分钟超过预警阈值,而且没有下降的趋势;服务健康检查接口连续多次返回非200的状态码。
2.5.3 重启策略
重启策略也分几种情况:立即重启,对核心服务,一旦检测到异常,马上尝试重启;延迟重启,在重启前等一小会儿,避免因为瞬时波动导致频繁重启;指数退避,如果重启后又失败,就逐渐增加下一次重启的等待时间,防止出现重启风暴;还有最大重试次数,设定一个上限,超过这个次数后,自动操作就停下来,发送高级别告警,通知人工介入。
3. 对大模型的意义
这一整套方案,对大模型来说意义重大。首先,它能保障服务连续性,大模型作为核心AI服务,一旦崩溃,对话、推理、训练等业务都会中断,而保活+自愈可以实现秒级恢复。其次,能大幅降低运维成本,不需要专人全天值守,减少了人工排查、重启、修复的时间。第三,可以提升硬件利用率,通过治理显存泄漏和OOM预警,避免硬件资源被无效占用,提升GPU使用效率。第四,这是支撑工业级部署的关键,商业化大模型必须具备高可用能力,自愈方案是生产环境部署的必备条件。最后,还能延长服务寿命,通过定时巡检和主动清理,避免慢性故障累积,让大模型服务能持续稳定运行数月甚至数年。
二、核心原理
1. 整体架构原理
所以,保活与自愈的核心逻辑到底是什么?简单说,是一套“监控-检测-决策-执行-反馈”的闭环架构,由5大模块协同工作:
- 监控模块:负责实时采集进程状态、GPU显存、系统内存、服务接口状态。
- 检测模块:把采集到的数据和预设的阈值进行对比,判断是否存在异常,比如崩溃、泄漏、OOM。
- 决策模块:根据异常类型,匹配对应的自愈策略,比如重启、清理、降载、告警。
- 执行模块:自动执行自愈操作,整个过程不需要人工介入。
- 反馈模块:记录自愈日志、更新服务状态,完成故障的闭环处理。
2. 分模块基础原理
2.1 进程崩溃自动重启原理
核心逻辑很简单:持续轮询,检测进程的PID是否存在。执行流程是:先获取目标进程PID,然后判断PID是否还活着。如果活着就继续监控,如果死了就执行重启命令,最后验证重启是否成功。技术关键点在于,要能精准匹配进程名称或端口,避免误杀、误重启其他服务。
2.2 显存泄漏治理原理
核心逻辑是:识别出未释放显存的代码或操作,然后定时清理显存,并限制显存峰值。具体治理手段有三个:一是主动释放,在Python中调用torch.cuda.empty_cache()清理缓存;二是重启释放,显存超过阈值后自动重启服务,彻底释放显存;三是代码修复,禁止在循环内重复加载模型,及时删除没用的张量。技术关键点在于,要能区分“正常显存占用”和“泄漏显存”,避免误清理。
2.3 OOM预警原理
核心逻辑是:实时采集GPU显存使用率,然后对比预警阈值,触发对应的预警和降载策略。预警分级通常这样设计:一级预警(70%),记录日志,做轻度清理;二级预警(85%),发送告警,强制清理缓存;三级预警(95%),立即重启服务,避免OOM崩溃。技术关键点在于,要能高精度地采集GPU数据,并且低延迟地触发预警。
2.4 定时巡检原理
核心逻辑是:基于时间触发器,周期性执行全维度检测。巡检维度包括:进程巡检(是否存活、CPU占用、线程数)、硬件巡检(GPU显存、温度、利用率;系统内存、磁盘)、服务巡检(推理接口是否响应、响应时间、错误率)。技术关键点在于,巡检过程要轻量化,不能占用大模型的推理资源。
2.5 无人运维自愈原理
核心逻辑是:所有模块联动,形成全自动的闭环。联动流程是这样的:巡检发现异常 → 检测判定故障类型 → 决策匹配自愈策略 → 执行自动修复 → 反馈验证修复结果 → 继续监控。技术关键点在于,策略要可配置、故障要可追溯、操作要可记录。
三、完整执行流程
1. 标准执行流程
一套标准的执行流程大致包含以下步骤:
- 初始化配置:设置进程名称、预警阈值、巡检频率、自愈策略。
- 启动监控服务:在后台运行保活自愈程序,不能影响大模型服务本身。
- 实时数据采集:每秒或每5秒采集一次核心指标。
- 异常判定:比如进程不存在了就触发崩溃重启;显存持续增长且不释放,判定为显存泄漏;显存或内存超阈值,触发OOM预警。
- 策略执行:根据异常类型,执行对应的自愈操作。
- 结果验证:检查服务是否恢复正常。
- 日志记录:保存故障发生时间、类型、自愈操作、执行结果。
- 持续循环:回到监控环节,7×24小时不间断运行。
2. 异常处理流程
2.1 大模型进程突然崩溃
- 监控模块检测到目标进程PID消失。
- 立即记录崩溃时间和日志。
- 执行进程重启命令,加载模型。
- 等待模型加载完成,验证进程是否存活。
- 如果存活,自愈成功;如果失败,则重试重启,注意最多重试3次。
- 重试失败后,发送告警通知。
2.2 显存泄漏导致占用持续升高
- 巡检模块对比历史显存数据,发现线性增长。
- 执行一级清理:调用显存清理函数。
- 清理后显存仍然升高,执行二级清理:重启模型推理进程。
- 重启后显存恢复正常,记录泄漏治理日志。
- 继续监控,防止再次泄漏。
2.3 OOM预警触发
- 显存占用达到85%的二级预警阈值。
- 系统自动暂停非核心推理请求,释放显存。
- 执行强制缓存清理。
- 如果显存下降到安全值,就恢复正常服务。
- 如果显存继续升高,就立即重启服务,避免OOM。
2.4 定时巡检执行
- 到达预设的巡检时间,比如每小时一次。
- 依次检测进程、GPU、内存、服务接口。
- 所有指标正常,生成正常的巡检报告。
- 发现隐性异常,触发对应的自愈策略。
- 保存巡检报告,方便后续追溯。
四、应用实践
下面是一个大模型服务进程保活与故障自愈的监控脚本示例,它能做到定时检测、异常崩溃后自动重启,并把结果记录到图表中。具体功能说明如下:
- 进程保活:定时检测模型进程是否存活,崩溃后自动重启,最多重试3次。
- OOM预警:GPU显存超过85%阈值时,自动清理缓存;清理无效则重启服务。
- 显存泄漏治理:显存超过70%时执行轻度清理,提前预防泄漏累积。
- 资源监控可视化:实时采集GPU和系统内存数据,定时生成趋势图表。
输出结果:
===== 大模型进程保活与故障自愈服务启动 =====
[19:21:33] 运行正常 | 进程PID:3296490 | GPU显存:8.72% | 系统内存:3.0%
[19:21:38] 运行正常 | 进程PID:3296490 | GPU显存:32.54% | 系统内存:4.2%
[19:21:43] 运行正常 | 进程PID:3296490 | GPU显存:50.21% | 系统内存:2.6%
[19:21:48] 运行正常 | 进程PID:3296490 | GPU显存:50.21% | 系统内存:2.7%
[19:21:53] 运行正常 | 进程PID:3296490 | GPU显存:58.92% | 系统内存:3.6%
[19:21:58] 提示:GPU显存占用83.6%,执行轻度清理
[2026-04-30 19:21:59.061133] 已执行GPU显存清理
[19:22:04] 警告:GPU显存占用90.39%,触发OOM预警!
[2026-04-30 19:22:04.113335] 已执行GPU显存清理
........
输出结果图示:

大模型资源监控趋势图:

五、总结
大模型的进程保活与故障自愈方案,可以说是它落地生产环境时,不可或缺的一项运维核心能力。在实际应用中,大家应该都遇到过类似的情况:模型好不容易部署上去,结果进程莫名其妙崩溃了,或者显存悄悄泄漏,再或者突发OOM宕机,每一个都让人头疼。这些问题如果全靠人工盯着排查、手动重启,不仅费时费力,还很容易错过故障处理的最佳时机,根本没法支撑长期稳定的运行。
所以,系统性地把进程监控、显存治理、OOM预警、定时巡检、自动自愈这整套东西做起来,是运维环节里极其重要的一部分。很多时候业务出故障,未必是模型本身不行,而是进程和资源没管好。
这里算是抛砖引玉。大家上手的时候,建议先吃透进程监控、GPU显存查看这些基础知识点,然后亲自动手跑通示例代码,测试一下崩溃重启、显存预警的实际效果。后续可以在这个基础上,继续扩展告警通知、日志持久化等功能,慢慢把这套方案改造成适配自己项目的定制化版本,真正做到让大模型服务免人工值守、全自动稳定运行。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- 大模型应用开发工具链技术选型与实施方案
- 时间:2026-08-17
-

- 大模型应用开发基础:Function Calling实现程序调用能力
- 时间:2026-08-16
-
- LangChain实战:构建企业级ReAct数据分析Agent
- 时间:2026-08-05
-
- 最新版Dify功能介绍及阿里云百炼Coding Plan与Token Plan接入教程
- 时间:2026-07-29
-
- 五部门联合部署 民航大模型应用迈入数智新纪元
- 时间:2026-07-28
-

- 提示词工程版本化,提示词管理成大模型新基建
- 时间:2026-07-25
-

- AI安全网关升温 提示词防护权限校验内容审计成大模型标配
- 时间:2026-07-25
-
- LangChain+LangGraph架构拆解:大模型复杂AI任务编排与状态管理
- 时间:2026-07-25
精选合集
更多大家都在玩
大家都在看
更多-

- 八大山人是谁
- 时间:2026-09-21
-
- 精浓度越高,消毒效果越好吗 蚂蚁庄园今日答案9.22
- 时间:2026-09-21
-
- 蚂蚁庄园今天答题答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园答题今日答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园小课堂2026年9月22日最新题目答案
- 时间:2026-09-21
-
- 小鸡答题今天的答案是什么2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园每日答题答案2026年9月22日
- 时间:2026-09-21
-
- 以下哪一项是闽南地区的特色小吃 蚂蚁庄园今日答案9月22日
- 时间:2026-09-21