告别纯文本 Skill-Omni重塑多模态智能体经验范式
时间:2026-07-22 | 作者:多维游侠 | 阅读:0核心判断:在过去,人工智能体的任务执行几乎完全依赖文字指令。但当你面对修图、GUI操作这类高度依赖视觉感知的任务时,纯文本的短板就会暴露无遗。说得直白一点:文字描述再精准,也抵不上一张“参考图”来得直观。
就在最近,openJiuwen社区正式推出了Skill-Omni。作为业界首个工程化落地的多模态Skill范式,它让Agent的经验从“读得懂”升级为“看得见”,也为智能体与复杂视觉任务的交互打开了一扇新的大门。
传统Skill范式的局限
传统Skill范式在处理视觉任务时,往往因为缺乏直观参照而显得力不从心。举个例子:在图像修复任务中,光靠“色调柔和”这样的文字描述,Agent很难拿捏调整的尺度。
- 是偏暖还是偏冷?
- 饱和度调多少?
- 没有视觉锚点,一切都是纸上谈兵。
Skill-Omni的突破
Skill-Omni的关键变化在于:它能把网页截图、界面状态以及视频操作脉络,统统转化为可复用的视觉经验资产。通过引入对比图与关键帧,Agent不仅能掌握操作流程,还能直观理解任务预期的“视觉标准”。
执行成功率和准确度自然水涨船高。
多模态时代来临
Skill-Omni的推出,意味着AI Agent的经验工程正从单纯的文档驱动,走向视觉与逻辑并重的多模态时代。目前,这一范式已经在多个场景中展现出巨大潜力:
- 图像处理
- GUI自动化
- 企业知识库升级
未来展望与开箱即用
未来,随着Skill-Omni向Physical AI领域探索,有望通过沉淀物理交互经验,让智能体在现实世界中实现更精准的操控。
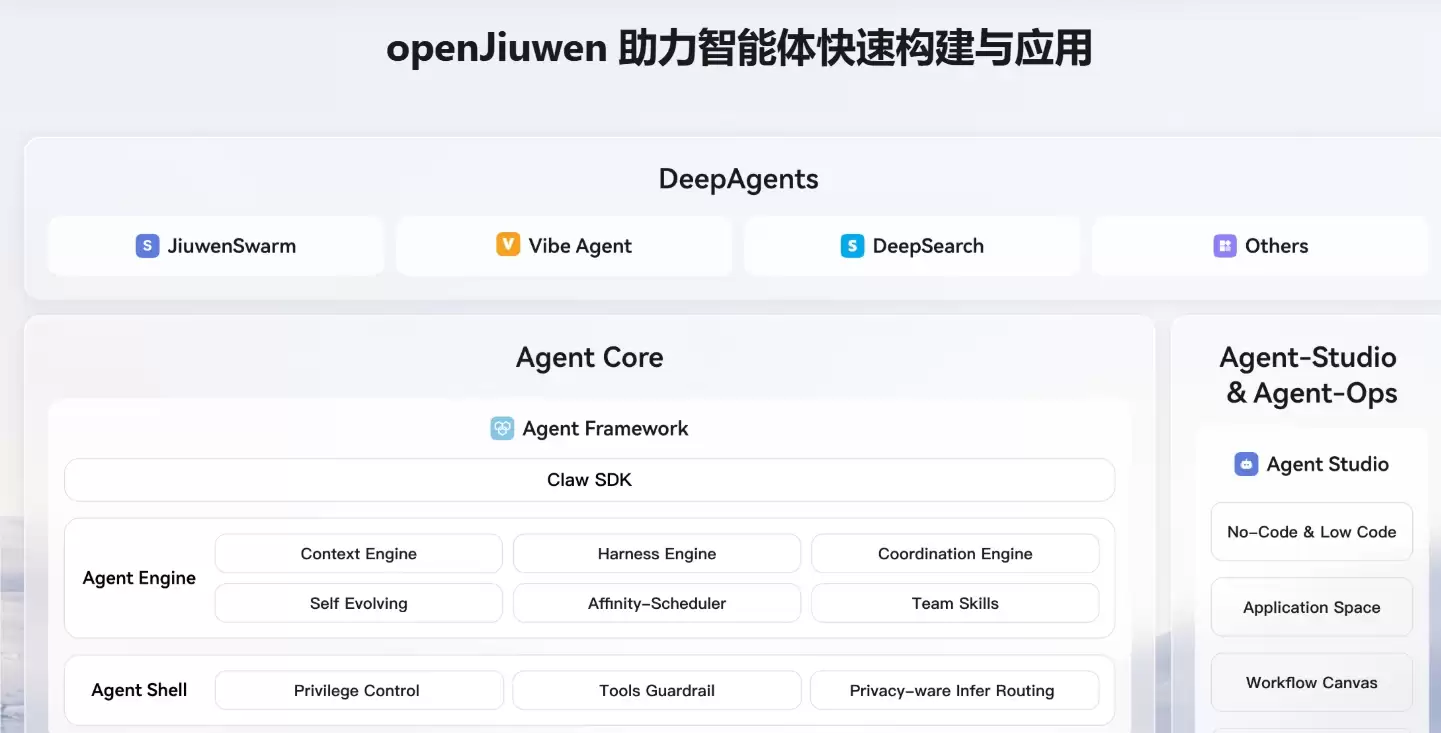
好消息是,Skill-Omni已经在JiuwenSwarm中实现开箱即用,为开发者打造更强大的多模态Agent提供了坚实的支撑。说白了,想用的话,直接上手就行。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 阿里千问开放第三方Agent与Skill接入,瑞幸东航首批测试
- 时间:2026-08-21
-

- 将老员工经验沉淀为Agent可调用资产:Skill与MCP治理实践
- 时间:2026-08-21
-

- Microsoft Agent Framework 1.0发布:Agent开发迈入工程化时代
- 时间:2026-08-21
-

- 郑州GEO源码推荐指南:核心要点与靠谱选择技巧
- 时间:2026-08-18
-

- OpenSkill智能体自进化新范式:孙立超团队刷新多项基准SOTA
- 时间:2026-08-18
-

- 小红书上线RED Skill功能:AI应用深度嵌入社区笔记场景
- 时间:2026-08-18
-

- AI简历优化工具怎么选:校招社招ATS兼容与数据安全指南
- 时间:2026-08-17
-

- AI简历工具推荐:国内与海外及ATS和全流程能力区别
- 时间:2026-08-17
精选合集
更多大家都在玩
大家都在看
更多-

- 2026年9月17日小鸡庄园答案
- 时间:2026-09-16
-
- 蚂蚁庄园今日答案2026年9月17日
- 时间:2026-09-16
-
- 蚂蚁庄园小课堂今日最新答案2026年9月17日
- 时间:2026-09-16
-
- 蚂蚁庄园小鸡答题今日答案2026年9月17日
- 时间:2026-09-16
-
- 褪黑素主要由人体哪个器官分泌 蚂蚁庄园今日答案9.17
- 时间:2026-09-16
-
- 蚂蚁庄园今天答题答案2026年9月17日
- 时间:2026-09-16
-
- 蚂蚁庄园答题今日答案2026年9月17日
- 时间:2026-09-16
-
- 研学旅游指导师的核心服务对象是 蚂蚁新村今日答案2026.9.16
- 时间:2026-09-16