阿里开源skill-up让Agent技能可评测可回归
时间:2026-07-24 | 作者:怪兽小助手 | 阅读:0这是2026年的第40篇文章
( 本文阅读时间:约 15 分钟 )
01
Agent Skill 火了,但「它到底好不好用」没人能回答
过去一年,Agent Skill 迅速成为 AI 应用领域的核心基础设施。
一段 SKILL.md、几个脚本、一组工具声明,就能让 Agent 具备一项新的专业能力:写发布计划、做代码评审、升级依赖、跑数据分析。
写一个能「跑起来」的 Skill 已经不难。
难的是回答另一个问题:它到底好不好用?
- 装上它之后,Agent 的行为真的符合预期吗?
- 下次有人改了一行描述,它会不会悄悄退化?
- 换一个 Agent 引擎,它还表现一致吗?
对传统软件,我们有单元测试、集成测试、CI 门禁来回答「改动有没有破坏原有行为」。
但 Skill 是 prompt、文件与工具配置的组合。它的行为对模型版本、引擎实现、输入措辞都高度敏感。
长期以来,缺少一种「声明一次、随时回放」的方式来固化我们对它的预期。
一旦预期没有被显式写下来,Skill 的质量就只能靠肉眼检查和人工记忆维护。而这恰恰是软件工程里最容易出问题的环节。
为此,阿里巴巴开源了 skill-up:一个专门面向 Agent Skill 开发者的命令行评测框架。
它的目标是「让 Agent Skill 的每一次迭代都可被验证、可被回归」。
本文会讲清楚四件事:
- skill-up 是什么;
- 它解决了哪些真实痛点;
- 它是如何设计的;
- 它在集团内部真实落地场景。
项目开源地址:github.com/alibaba/skill-up
用户手册:alibaba.github.io/skill-up/zh
02
三个大概率会发生的场景
如果我们正在编写或维护 Agent Skill,大概率会遇到以下问题:
场景一:Skill 悄悄退化,但没人在评审阶段察觉
你为团队的发布系统写了一个 publish-plan Skill,本地跑了几遍觉得「差不多了」就发布。
两周后,同事改了 SKILL.md 里的一段描述。Skill 在某些输入下却不再调用预期的工具,而是退化成了纯文本回答。
这个变化没有任何人在代码评审阶段发现,直到用户报障才暴露。
场景二:换个引擎,行为就变了
你写了一个 code-review Skill,在某个 Agent 引擎上跑得不错。
团队另一位同事换了另一个引擎,反馈说同样的提示语下输出结构完全不同。
你想系统地验证 Skill 在两个引擎下的真实差异,但每次都得手工触发、手工对比、手工记笔记。最后这件事被无限期搁置。
场景三:评测逻辑散落各处,无法复用
为了给一个复杂 Skill 做评测,你写了一堆脚本:安装 Skill、调用 Agent、解析输出、对比结果、生成报告。
它能跑,但评测语义散落在多个脚本和中间文件里。本地一套、CI 又一套。新增一条用例要同时改好几处,新人根本看不懂「这条评测到底在判什么」。
这三个场景的问题其实是同一个:Skill 缺少一个标准化的评测框架。
这个框架需要把「加载用例→启动 Agent→发送输入→收集回复→判定是否通过→生成报告」这一整套流程稳定地串起来,并且能被本地开发和 CI 流水线共同复用。
03
skill-up 是什么
skill-up 是一个独立的命令行评测框架。
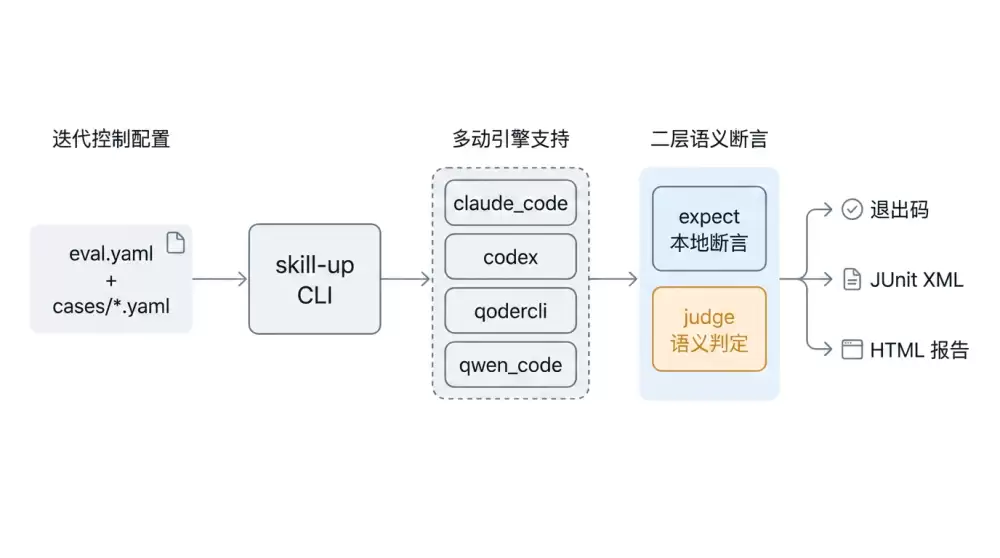
你在 Skill 目录下放一份 evals/eval.yaml 和若干 evals/cases/*.yaml。用声明式的方式写清楚:评测在什么环境里跑、用哪个 Agent 引擎、跑哪些用例、用什么方式判定通过。
然后执行一条命令,它就会逐用例执行并产出结构化报告。
一份最小的 eval.yaml 大致长这样:
schema_version: v1alpha1
environment:
  type: none # 本地直跑;也可选择沙箱化隔离环境
engine:
  name: claude_code # 内置多引擎,一个参数即可切换
cases:
  files:
    - evals/cases/create_plan.yaml
  defaults:
    timeout_seconds: 300
    max_turns: 10
每一条用例是一份独立的 case YAML,描述输入、期望检查和判定方式:
id: case_create_plan
title: 验证发布计划生成能力
input:
  prompt: "帮我为今天上午 10:30 的 web 系统发布生成一个发布计划"
expect:
  must_contain:
    - "发布计划"
    - "10:30"
judge:
  type: agent_judge
  criteria:
    - "回答是否提供了完整的发布步骤与回滚方案"
    - "是否正确调用了发布计划生成工具"
声明完成后,运行:
skill-up run ./evals/eval.yaml
它会逐用例执行,并产出三类结果:
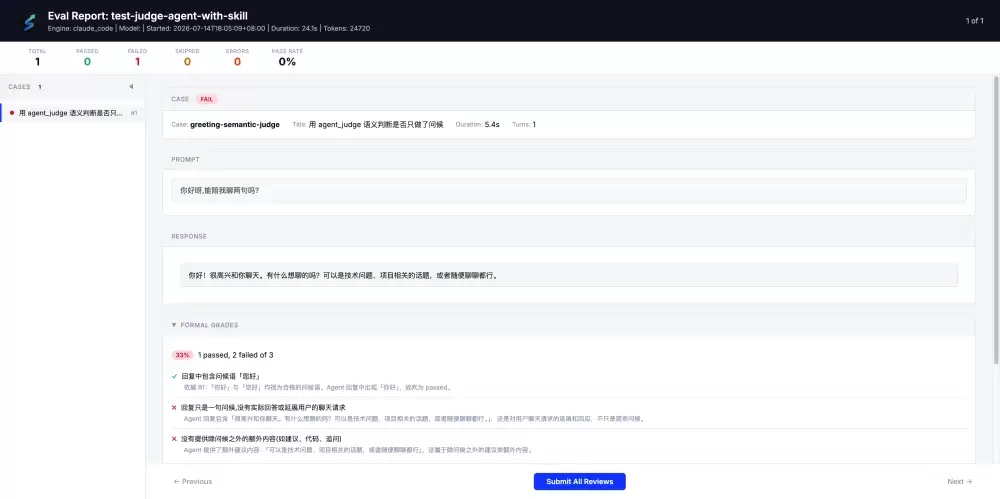
- 每条断言的通过情况与证据(工具是否被调用、输出是否包含关键字段、判定理由);
- 本次评测的汇总通过率与耗时/token 消耗;
- 一个进程退出码:0 表示全部通过,非0 表示存在失败用例,可以直接接入 CI 作为合并门禁。
除此之外,它还能同时输出 JUnit XML 和一份可视化的 HTML 报告。


| 维度 | 迁移前(手搓流水线) | 迁移后(skill-up) |
|---|---|---|
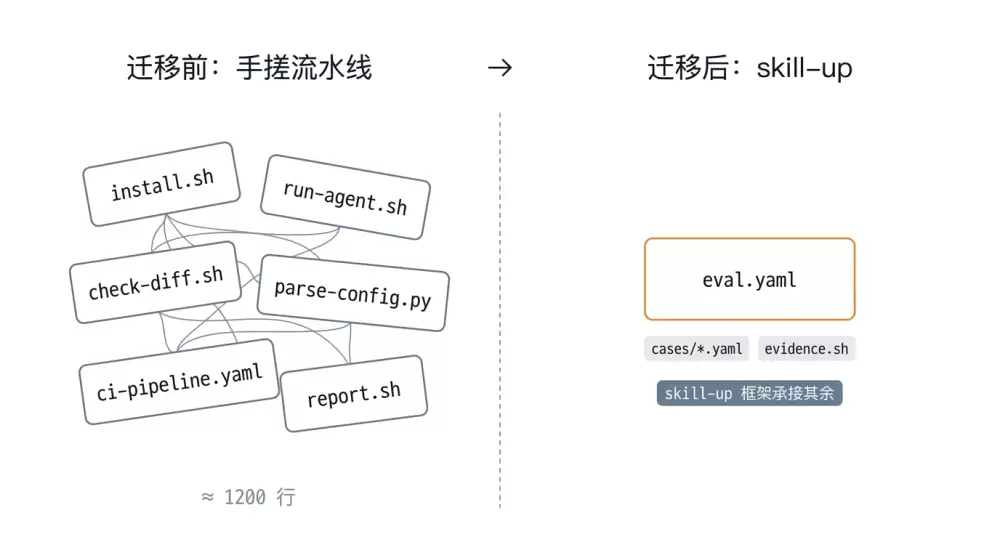
| 通用执行编排 | 多个 Shell 脚本,约数百行 | 删除,交由框架承接 |
| 判定方式 | 结论解析脚本 + 源码 diff 脚本硬判 | expect + 证据脚本 + agent_judge / judge skill |
| 引擎支持 | 仅锁定单一引擎 | 一个参数切换多引擎回归 |
| 本地 / CI 一致性 | 两套独立逻辑,改动不同步 | 共享同一份评测声明 |
| 快速失败 | 无,明显失败也要跑完整对比 | expect 失败即跳过昂贵阶段 |
| 复杂语义判断 | 难以表达 | agent_judge 结合证据判断 |
| 新增用例成本 | 改 CI 配置 + 确认脚本兼容 | 新增一份约 40 行的 YAML |
| 结果可达性 | 下载制品、解压、读原始文件 | 一个链接直达可视化报告 |
这次迁移带来的收益,几件事同时发生。
声明式结构让「这条用例要做什么、整体怎么判」从「读完好几个脚本才拼得出来」变成「打开 YAML 就能顺着看清」。
分层判定让廉价失败快速返回、确定性证据稳定产出、复杂差异交给评审 Agent。
跨引擎回归从「重写整套安装脚本」变成「改一个参数」。
本地和 CI 共享同一份评测语义,不再「本地一套、CI 一套」。
其中体感变化最大的一步,其实不是评测本身,反而是报告。
过去评测产物只是躺在 CI 制品里的原始文件。想看结果的人要进 CI、找构建、下载、解压、读 JSON。
这个门槛对创建者本人还能接受,对团队其他成员(评审人、TL、协作方)来说太高。很多人看到「需要下载」就放弃了。
迁移后,每次评测的 HTML 报告被发布成一个可访问的链接。评审、验收、争议解决都可以直接甩链接。
这不是一个技术问题,而是一个协作问题:评测只有被看见才有价值,而被看见的前提是路径足够短。
这个案例也修正了一个此前不太确定的判断。
对于「真实代码仓库输入、真实环境执行、产物级 diff 验证、允许合理差异并需要语义评」的重型 Skill 端到端评测,skill-up 已有的原语是可以承接的。
它不是把 CI、业务镜像、标准答案这些问题都替你解决。而是把原本散落在脚本里的评测语义抽出来,用一套稳定的结构承载起来。
08
五分钟上手
skill-up 提供两条上手路径。
路径A:让 Agent 帮你自动生成评测集(推荐)
skill-up 随仓库开源了一个名为 skill-upper 的 Agent Skill。专门用来帮 Agent 读取 SKILL.md 和相关脚本、推断这个 Skill 适合怎么评测。
装上之后,在 Skill 仓库根目录打开任意一个支持的 Agent,直接说一句「评测当前 Skill」。
skill-upper 就会生成 evals/eval.yaml 和 evals/cases/*.yaml,并调用 skill-up 跑一遍,把初始结果和 HTML 报告返回给你。
它的价值不是替你完成评测建模,而是把「从 0 到 1 的样板」先搭出来,让你围绕真实预期继续迭代。
# 以全局安装到 Claude Code 为例
npx skills add https://github.com/alibaba/skill-up/tree/main/skills/skill-upper -g -a claude-code -y
路径B:纯 CLI 上手
适合需要在 CI 中跑、对评测集有精细控制的场景。
# 安装
curl -fsSL https://raw.githubusercontent.com/alibaba/skill-up/main/install.sh | bash
skill-up --version
# 在 Skill 目录下创建 evals/eval.yaml 与 evals/cases/*.yaml 后运行
skill-up run
无论哪条路径,产出都是同一套结构化结果:
- 逐条断言的通过情况
- 汇总通过率
- 可接入 CI 的退出码
- 一份可视化 HTML 报告
09
写在最后
skill-up 的定位可以用一句话概括:用简单易懂的声明式配置,固化我们对 Agent Skill 的预期,让代码评审和 CI 流水线都能有效验证它。
从「一问一答」的单轮断言,到贴近真实交互的多轮会话,再到承接真实业务的重型端到端评测。
它想做的始终是同一件事:把 Skill 的质量从「靠肉眼和记忆维护」变成「可声明、可回放、可回归」。
它也有清晰的边界,值得先说在前面。
- 如果你的判定就是「产物必须逐字节一致」,用
script_judge靠退出码硬判会更省成本,不必动用agent_judge。 - skill-up 不替你解决真实环境的可复现问题。工具链、镜像、标准答案仍需你自己准备好。
- 对于单条要跑几十分钟的重型用例,更合适的方式是定时回归而非每次提交都卡门禁。把它当成一层「质量基线」,而不是「每个 commit 的强阻断」。
看清这些边界,反而更容易把 skill-up 用在它真正擅长的地方。
那么,最直接的上手方式,其实就是打开你自己的 Skill 仓库,装上 skill-upper,说一句「评测当前 Skill」。
几分钟后你会拿到第一份 HTML 报告,然后围绕它继续迭代。
如果你也在编写或维护 Agent Skill,欢迎试用并参与共建:
- 开源仓库:github.com/alibaba/skill-up
- 中文用户手册:alibaba.github.io/skill-up/zh
- 反馈渠道:github.com/alibaba/skill-up/issues

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 阿里千问开放第三方Agent与Skill接入,瑞幸东航首批测试
- 时间:2026-08-21
-

- 将老员工经验沉淀为Agent可调用资产:Skill与MCP治理实践
- 时间:2026-08-21
-

- Microsoft Agent Framework 1.0发布:Agent开发迈入工程化时代
- 时间:2026-08-21
-

- 郑州GEO源码推荐指南:核心要点与靠谱选择技巧
- 时间:2026-08-18
-

- OpenSkill智能体自进化新范式:孙立超团队刷新多项基准SOTA
- 时间:2026-08-18
-

- 小红书上线RED Skill功能:AI应用深度嵌入社区笔记场景
- 时间:2026-08-18
-

- AI简历优化工具怎么选:校招社招ATS兼容与数据安全指南
- 时间:2026-08-17
-

- AI简历工具推荐:国内与海外及ATS和全流程能力区别
- 时间:2026-08-17
精选合集
更多大家都在玩
大家都在看
更多-

- 以下哪种食材被称为“地下苹果” 蚂蚁庄园今日答案9.18
- 时间:2026-09-17
-
- 蚂蚁庄园今天答题答案2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园答题今日答案2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园小课堂2026年9月18日最新题目答案
- 时间:2026-09-17
-
- 小鸡答题今天的答案是什么2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园每日答题答案2026年9月18日
- 时间:2026-09-17
-
- 蔬菜洗完掉色,说明是被染色了,是真的吗 蚂蚁庄园今日答案9月18日
- 时间:2026-09-17
-
- 满襟蜡绘花纹巧染就花纹当绣裳说的是哪种传统技艺 蚂蚁新村今日答案2026.9.17
- 时间:2026-09-17