Linux 环境里跑 Node.js 应用时,JavaScript 异常日志常常又长又密,第一眼很容易看不出重点。其实大多数报错都能按固定顺序拆解:先确认异常属于哪一类,再定位报错位置,最后顺着堆栈还原调用路径。掌握这个阅读方法后,你不仅能更快找到出错代码,也能判断下一步该继续看日志,还是直接进入调试器。
先看懂异常日志的四个核心部分
一段完整的 Node.js 异常日志,通常至少包含四类关键信息。排查时不要一上来就盯着整段红色输出逐行读,先把这四部分拆出来,效率会高很多。

1. 异常类型:先判断问题属于哪一类
异常类型相当于问题标签,常见的有 TypeError、ReferenceError、SyntaxError。看到类型后,通常就能先缩小排查范围。
TypeError往往和对象类型不符合预期、访问了不存在的属性有关。ReferenceError通常表示变量未定义,或者作用域里找不到对应标识符。SyntaxError更偏向语法层面,意味着代码在执行前就已经出错。
2. 异常描述:直接提示“到底发生了什么”
异常描述通常是一句非常具体的话,例如 Cannot read property 'x' of undefined。这类信息的价值在于,它不只告诉你“出错了”,还会明确指出错误动作和对象状态。
以上面这句为例,含义就是代码试图读取一个 undefined 对象上的 x 属性。看到这里,排查重点就可以直接转向“为什么这个变量会是 undefined”。
3. 异常位置:先找到文件和行号
日志里通常会给出明确位置,例如 /app.js:25。这类坐标信息很关键,因为它能把排查范围从整个项目收缩到具体文件的具体行。
需要注意的是,报错行本身不一定就是根因所在,但它通常是最值得先看的入口。先回到这一行,再结合上下文检查变量来源、函数入参和执行条件,往往比全局搜索更有效。
4. 堆栈跟踪:还原异常是怎么一路传上来的
堆栈跟踪是整段异常信息里最有价值的部分。它会把相关函数调用链按顺序列出来,帮助你看清问题是在哪个调用环节被触发、又是如何一路冒泡到控制台的。
实际分析时,可以把堆栈理解成一条“调用路线图”:最上方通常更接近异常触发点,较下方则更接近调用入口。把触发点和入口一起看,才能判断这是单点代码失误,还是上游参数传递已经出了问题。
先把日志落盘,再做关键词定位
如果应用直接在终端里运行,最实用的第一步通常不是立即手工翻屏,而是先把输出完整保存下来。这样做的好处是,后续可以反复检索、比对,也不怕终端内容被新日志冲掉。
运行 Node.js 应用时,可以把标准输出和错误输出一起重定向到文件:
node app.js > output.log 2>&1
这条命令会把所有控制台输出,包括错误和警告,都写入 output.log。文件保存好之后,再用文本编辑器或 IDE 打开它,通过 Ctrl+F(Mac 下是 Cmd+F)搜索以下几类关键词:
- 异常类型,例如
TypeError、ReferenceError - 异常描述中的关键短语
- 文件路径或行号,例如
/app.js:25
这一阶段的目标不是立刻解释全部日志,而是尽快把“最像根因的那一段”定位出来。
顺着堆栈跟踪,从入口看到触发点
找到异常片段之后,接下来就该认真读堆栈跟踪。很多人只盯着第一行描述,但真正能帮助你判断上下游关系的,往往是后面的调用链。
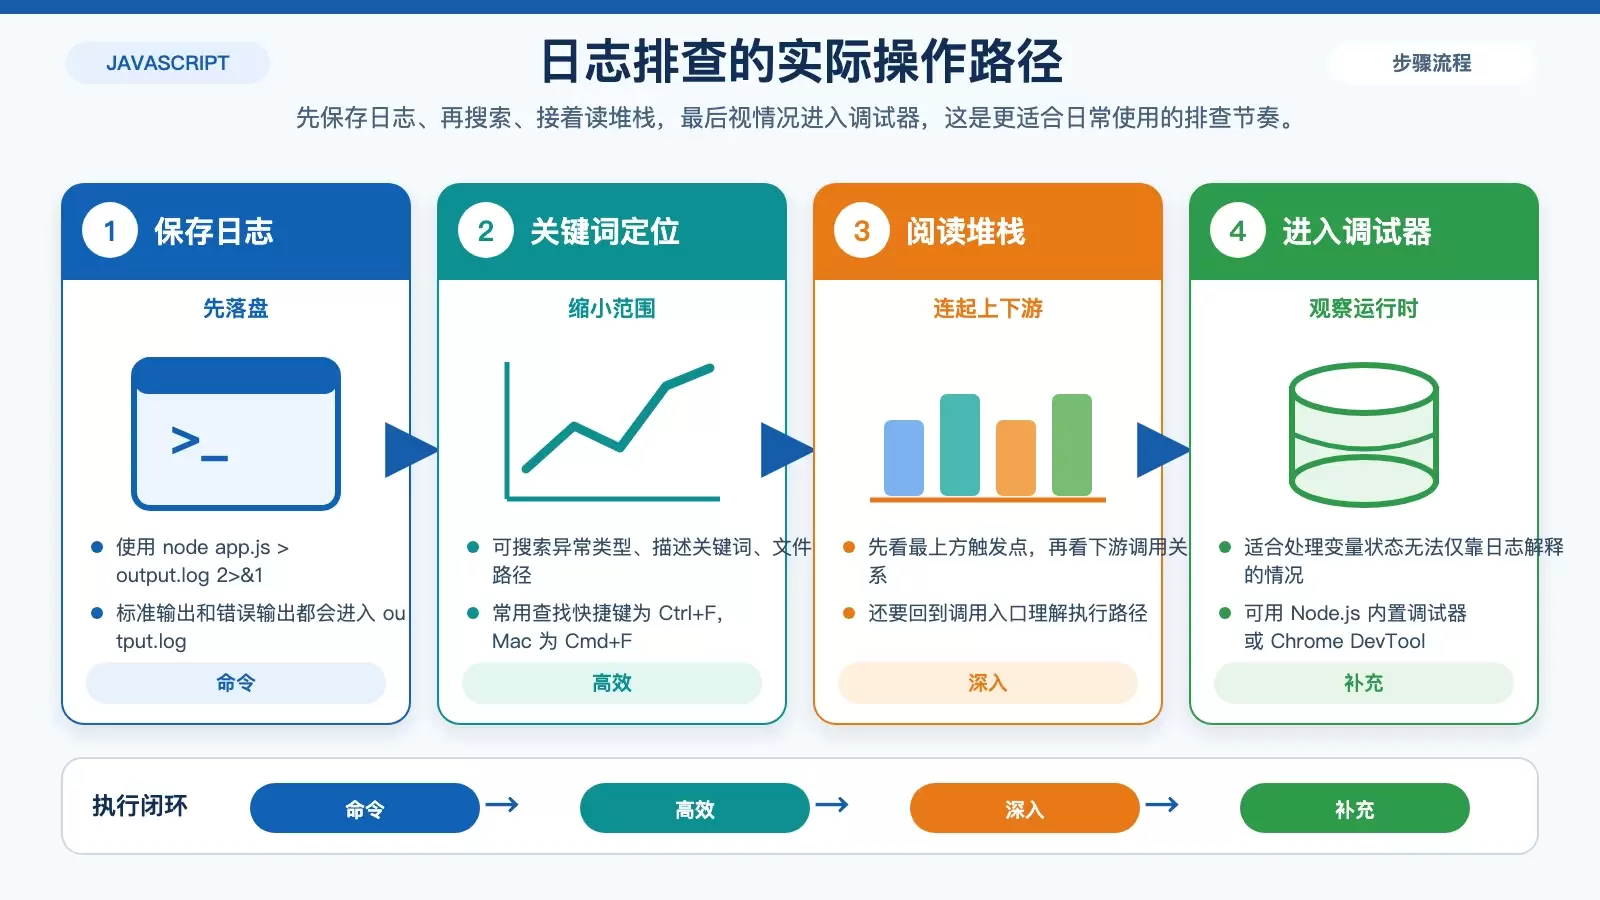
阅读时可以按这个顺序来:
- 先确认最上方的异常触发位置,看看是哪一行代码直接抛出了问题。
- 再往下看相关函数调用,判断这个值是在哪一层被传进来的。
- 最后回到调用入口,理解这条执行路径为什么会走到这里。
例如,当报错显示读取了一个 undefined 的属性时,真正的问题可能并不在访问属性这一行,而在更早之前某个函数没有返回预期数据,或者某个分支条件导致变量未初始化。堆栈的作用,就是帮你把这条链完整接起来。
日志不够时,再切到调试器
如果日志已经告诉你大概位置,但仍然无法解释变量为什么会变成当前状态,就该进入调试阶段了。相比反复猜测,调试器更适合处理那些“看起来没问题,但运行结果不对”的情况。
这时可以使用 Node.js 内置调试器,或者借助 Chrome DevTools 这类外部工具,逐步执行代码,重点观察两类信息:
- 关键变量在进入函数前后是否已经异常
- 函数调用过程中,参数和值是在什么环节发生变化的
当日志只能告诉你“哪里炸了”,调试器能进一步告诉你“为什么会炸”。两者结合,通常就能把问题范围压到足够小。
一套适合日常排查的阅读顺序
在 Linux 上看 Node.js 的 JavaScript 异常日志,最稳妥的方式不是凭感觉乱翻,而是按固定顺序处理:先看异常类型,再读异常描述,接着定位文件和行号,最后结合堆栈跟踪还原调用过程。
实际操作里,也建议遵循同样的节奏:先把日志保存到文件,随后做关键词检索,再深入阅读堆栈;只有当日志信息不足以解释问题时,再切换到调试器。按这个顺序排查,遇到大多数常见异常时都会更快找到根因。


